本周,图像、语言和语音领域的新模型集中亮相。实际上手测试表明,排行榜上的名次与真正值得使用的模型并不总是一致。最实用的新面孔之一似乎是Krea 3,这款图像工具只修改你用框圈出的部分。语音方面,xAI的Grok Voice 3.0回应极快,测试搭建的客服智能体用起来几乎像真人对话。与此同时,Meta的Muse Wonder在一项编程基准测试中拿下最高分,基准测试是用来比较模型的标准化测试;但它根据一条提示词做出的游戏,看起来比Claude Opus 5.5和Gemini 4 Argon做出的更粗糙。
图像模型比拼的是控制力和速度
主流模型的基础文生图质量如今看来已基本成熟,竞争焦点因此转向两个问题:能多精确地修改图像的某一部分,以及能否在自己的硬件上运行模型。
Krea 3只编辑你选中的部分
Krea 3目前已在网页端开放公测,在普通文生图方面与GPT Image 2.5、Nano Banana等模型表现相当。它真正的强项是基于边界框的多轮编辑:在某个区域画框,输入只作用于该区域的指令,图像其余部分保持不变。
用一张包含人物面孔和智能手机的缩略图测试,过程如下:
- 框选手机屏幕和人物的眼睛,指示把手机背景改成蓝色、把眼睛改成布满血丝的红眼,约10秒后返回了3个变体。
- 第二轮把手机上显示的模型名称从Claude Haiku 5.5改为Gemini 4 Argon,并把Anthropic的标志换成谷歌的标志。
- 第三轮把标题改写为“NEW MODEL!”,保留了同样的黄色艺术字体,还把帽子上的刺绣徽章改成了棒球标志。
编辑过的部分与周围衔接自然,连刺绣的针脚和字体粗细都保留了下来。对于经常修改缩略图或设计素材的人来说,Krea 3产出的结果似乎比对话式图像编辑器更干净。画框时要紧贴目标,以免周围细节被改动;提交前先叠加多个各带提示词的框,就能一次完成一批修改。
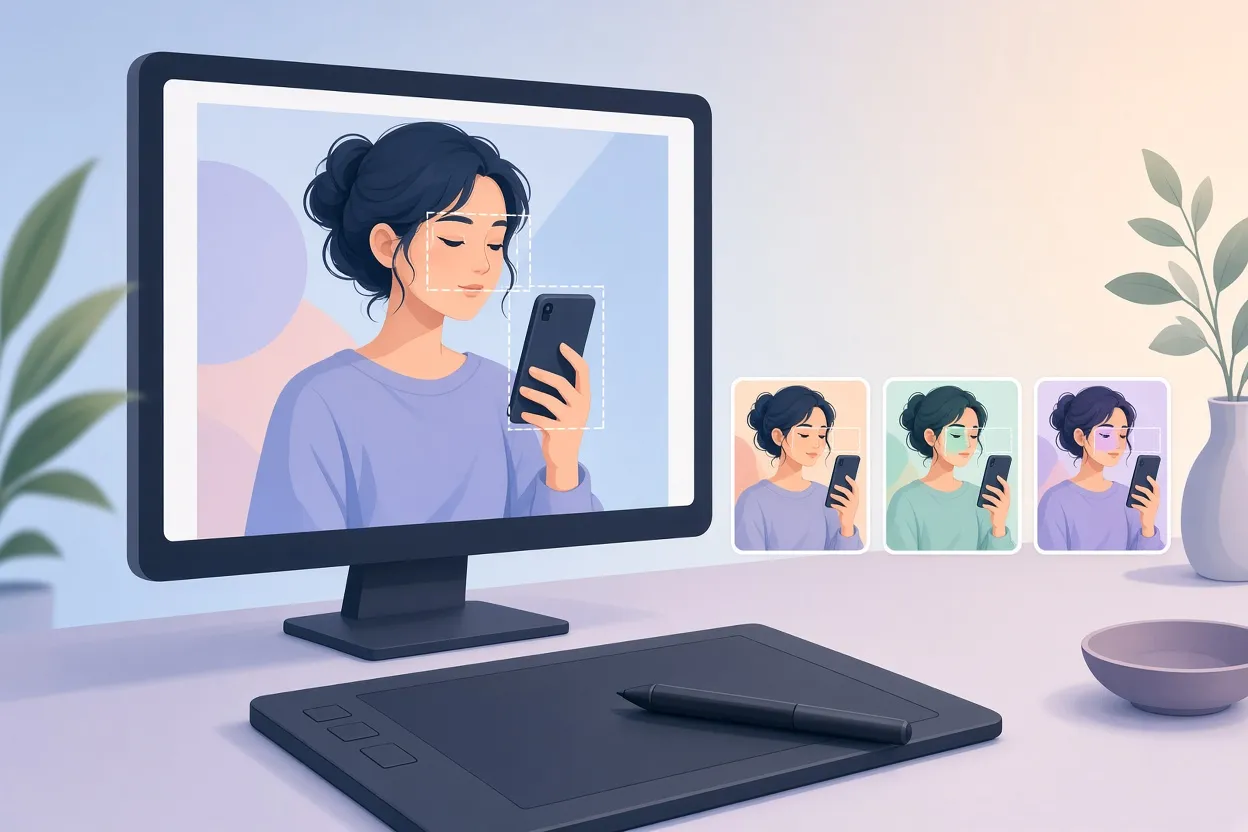
▲ 只编辑选中区域的局部修改
能在台式机GPU上运行的开放权重图像模型
另有两款新的开放权重图像模型发布,任何人都可以下载并运行其训练好的模型文件。
Black Forest Labs发布了FLUX 3 Image Klein,这是一款参数量为56.8亿的模型,支持文生图、基于多张参考图的生成以及图像编辑。模型权重已在Hugging Face上公开,可以微调,也就是针对特定任务进一步训练;另有为降低延迟而调校的蒸馏版本。
| 硬件 | 文生图 | 图像编辑 |
|---|---|---|
| 英伟达DGX Spark,约$4,000级别 | 约7.3秒 | 16.2秒 |
| 英伟达GeForce RTX 4070,消费级GPU | 8.9秒 | 未列出 |
消费级显卡每张图只比DGX Spark慢不到两秒;对多数人来说,能在普通台式机上完成高分辨率生成和编辑,可能更为重要。
阿里巴巴推出了Qwen-Image-2.1-Turbo,这是Qwen-Image-2.1的加速版检查点,只需8个去噪步骤就能生成和编辑高分辨率图像。去噪步骤是模型把随机噪声逐步变成完整图片的过程。它牺牲了一些细节,但提高了实际生产中的吞吐量,示例中还有一张信息密集、带原子模型和活动性表格的化学学习海报。
两款模型都可以在Hugging Face的社区Spaces上免费试用,无需下载任何东西,不过共享的Spaces在流量大时可能变慢,或让请求排队。
Grok Voice 3.0以响应速度为卖点
xAI发布了Grok Voice 3.0,这是一款实时语音到语音模型,听到语音后直接用语音作答。xAI称其在延迟和声音自然度方面创下基准测试纪录,语音基准测试综合得分为86.9。
语音智能体是能朝着目标自主完成工作的AI程序。在xAI的语音智能体沙盒中,可以设置系统指令、问候语、回复规则、打断处理方式和预设声音。在那里为一个网站搭建的客服智能体几乎即时应答,感觉比一般的语音助手快得多,被中途打断时也能从容应对。被问到时,它还能直接从网站调取工具推荐和新闻报道。
如果要搭建语音智能体,应在指令中写明禁止事项,让它只依据经过审核的内容作答;同时调整静默超时和打断阈值,避免它和通话对方抢话。
ElevenLabs也在ElevenCreative中推出了Instant Soundtracks。它会读取视频的画面线索、节奏和转场,无需手动剪辑就能配上合适的背景音乐和对准时间点的音效。
▲ 无延迟的实时语音客服
语言模型:排行榜与实际产出并不一致
Gemini 4 Argon的首发价格持续到11月
谷歌正式推出了9月30日首次宣布的Gemini 4 Argon,开发者可通过API和Google AI Studio使用,AI Ultra和Pro套餐的订阅用户也可使用。它直接对标OpenAI的GPT-6 Astra和Anthropic的Claude Opus 5.5。API首发价格为每百万输入token $2.00、每百万输出token $10.00;token是模型读写文本时使用的小单位。这一价格持续到11月底,之后大约翻倍。在Artificial Analysis Intelligence Index上,Argon得分53,比Claude Opus 5.5低5分,但每项任务的成本要低得多。
在一项让模型用SVG代码画人物漫画、再由AI评委团打分的测试中,Argon用时约四分钟、花费$0.34,得到7.6分,在排行榜上仅次于GPT-6.1 Sol,位列第二。SVG是一种用形状和线条描述图像的格式。让它用一条提示词制作一款3D动作游戏,它做出了一款可以运行的第三人称竞技场游戏,带有连跳移动和升级卡牌,不过画面比较简陋。谷歌的工程师把生成可3D打印的CAD模型列为Argon的强项,测试也印证了这一点:Argon根据一张面部照片生成了半身像的STL文件,打印出的半身像从正面看相当神似,只是侧面轮廓略显扁平。
纸面上领先的Muse Wonder
Meta的Muse Wonder在编程基准测试DeepSWE上领先,Muse Wonder Full得分79.0%,标准版Muse Wonder得分78.8%,超过Claude Opus 5.5的74.2%和GPT-6 Astra的74.1%。在Artificial Analysis Intelligence Index上,它的得分高于Gemini 4 Argon、GPT-6 Astra和Claude Fable 5.1,与Claude Sonnet 5.5持平。其价格为每百万输入token $4.00、每百万输出token $20.00,与Claude Opus 5.5相当;在Artificial Analysis评估过的模型中,它的每任务成本排第五高,略低于Claude Opus 5.5。
实际使用中,它没有那么占优。在同样的漫画测试中,Muse Wonder得到6.6分,排名第14。用同样的3D游戏提示词,它做出了可以运行的操控、碰撞判定、跳跃、镜头平移和一波波来袭的敌人,但与Claude Opus 5.5和Gemini 4 Argon的版本相比,画面简单,动作僵硬。基准测试领先并不保证产出精良。
| 项目 | Gemini 4 Argon | Muse Wonder |
|---|---|---|
| 每百万token的API价格 | 输入$2.00,输出$10.00,至11月底 | 输入$4.00,输出$20.00 |
| 漫画SVG测试 | 7.6分,第2名,$0.34 | 6.6分,第14名,$0.3422 |
| 一条提示词做3D游戏 | 可运行,画面简陋 | 可运行,简单僵硬 |
更多新模型:按规模、速度和价格区分
- Muse Spark Open(Meta):Meta在推出Muse Wonder之后,把曾经的顶级专有模型Muse Spark以开放权重形式发布。Meta称它是迄今美国最强的开放权重模型。它的总参数量为8160亿,每个token激活420亿,上下文窗口为100万token,上下文窗口指模型一次能考虑的输入量。它借助苹果的MLX框架完成优化,可在两台M5 Ultra Mac Studio上本地运行,在通用任务上领先Mistral Large 4和Qwen 3.8,但在DeepSWE上落后于Kimi K3。近$1万的Mac Studio硬件恐怕很难称为消费级配置,它在漫画测试中也只得到3.9分。
- Nemotron 3.5 Super VL(英伟达):一款参数量为1200亿的开放权重视觉语言模型。它在Artificial Analysis指数上得分26,落后于DeepSeek、Qwen 3.8和GLM 5.3,但每秒输出token数约为更聪明的开放权重对手的5倍,因此看起来最适合低延迟比深度推理更重要的智能体工作流。
- MAI-Base 2(微软):一款已完成初始预训练的基础模型,总参数2.8万亿,其中激活参数800亿。微软称,它在编程和推理方面的原始预训练评估中优于现有开放权重模型,但由于尚未经过后训练,公开发布和独立测试仍有待进行。
- Ultramarine 1 Flash:一家AI公司推出的开放模型,面向专业知识工作,定价为每百万输入token $0.15、每百万输出token $0.50。该公司称,它在金融、法律和咨询工作中能以Fable级模型约六十分之一的成本达到Claude Fable 5.1的水平,但它尚未上线OpenRouter,外部验证仍有待完成。
OpenAI的“28 Days of Shipping”进入平淡期
OpenAI于10月4日宣布的为期28天的发布活动“28 Days of Shipping”,第二周明显平淡了许多:
- 第5天:Codex中的Composer Predictions会根据项目上下文,为Pro用户推荐下一条提示词。
- 第7天:Codex中GPT-6.1 Sol的默认上下文窗口从27.2万token扩大到50万token,增幅约84%。
- 第9天:ChatGPT和Codex桌面应用占用的磁盘空间减少约60%。
- 第11天:新增的算力减少了容量不足的报错,请求现在会在后台自动重试,而不再阻塞用户。
- 第6天、第8天和第10天:没有新功能,只有使用额度重置。
许多用户认为第9天和第11天只是迟到的漏洞修复和服务器维护,算不上新功能,这一批评看来不无道理。如果你在用Codex,不妨更新桌面应用,并试着把整个代码仓库放进更大的上下文窗口。
决策模型以低成本专做一件事
与写出成段文字的生成式模型不同,决策模型会评估输入,然后返回一个选项或经过校准的概率。基于Qwen2.5-9B微调而成的Microsoft-Decision-1,可以处理是非题、多项选择、数值评分,以及按评分标准对AI回答或智能体行为打分。另一家AI公司称,其Nimble-v4-max在一项决策基准测试中准确率达到85.0%,错误比一款竞品模型少43%。微软、OpenAI等公司的方案看起来几乎可以互相替代,因此真正的收益在于成本:在请求分发、内容审核或按标准打分等场景中,决策模型可以替代大语言模型,降低算力开支并缩短响应时间。
如何用好本周的新模型
在这些测试中,编辑的可控性、响应速度和运行成本,似乎比基准测试分数更能区分出好用的工具。编程榜首模型做出的游戏反而不够精良,而一款智能得分平平的模型则凭速度找到了用武之地。可以根据自己的工作这样选择:
- 如果经常修改图像,可以试用Krea 3的公开测试版,把框画得紧贴目标,并把指令合并后一次发送。
- 如果想在自己的电脑上生成图像,下载之前先在Hugging Face Spaces上试用FLUX 3 Image Klein或Qwen-Image-2.1-Turbo。
- 如果在意API成本,在首发价格于11月底结束前,用自己的任务评估Gemini 4 Argon。
- 如果智能体需要快速响应,可以考虑Nemotron 3.5 Super VL这类高速模型,或用决策模型来做请求分发和打分。
- 如果正在搭建语音智能体,用明确的禁止事项限制回答范围,并调整静默和打断设置。
- 比较模型时,不要只看总榜,还要看分领域的基准测试,比如编程看DeepSWE,法律和金融工作看DiligenceBench。