제3자 평가 기관 METR이 2026년 11월 공개한 보고서는 Anthropic이 자사 AI 모델의 역량을 과거보다 약 2배 빠른 속도로 끌어올리고 있으며, 그 가속의 약 80%가 AI 도구를 연구개발에 쓴 결과라고 결론지었습니다. 여기에 향후 12개월 안에 이 흐름을 멈출 만한 기술적 병목이 보이지 않는다는 판단이 더해지면서, recursive self-improvement(AI가 다음 세대 AI의 개발을 도우며 스스로 개선 속도를 높이는 되먹임)와 singularity(AI가 스스로를 개선해 인간의 이해와 통제를 벗어나는 전환점)가 임박했다는 해석으로 이어집니다. 이 글은 보고서가 어떤 지표와 전제로 그런 결론에 이르렀는지, 그리고 어디까지가 확인된 사실이고 어디부터가 해석인지 가려 읽는 기준을 정리합니다.
평가가 이뤄진 배경
이번 평가의 출발점은 2026년 9월 12일입니다. Anthropic의 Dario Amodei가 frontier(최전선 모델 개발) 속도를 조절하자는 세 갈래 계획을 공개하고 독립 평가자에게 내부 모델, 시스템, 대화 기록, 연구자에 대한 직원 수준의 접근을 보장하겠다고 밝혔고, OpenAI의 Sam Altman도 이에 동의하며 같은 약속을 했습니다. 두 회사 모두 통제를 벗어난 자기 개선과 superintelligence(인간을 넘어서는 지능)에 대한 우려를 이유로 들었습니다.
METR은 8월 중순부터 11주 동안 2.5명(정규직 환산) 규모의 인력으로 Anthropic 내부를 들여다봤습니다. 사전 학습, 강화 학습, compute(연산 자원) 클러스터에 걸친 원자료를 직접 검토했고, 질적 인터뷰, 자가 보고된 생산성 향상치, 인력 기록, 작성된 코드 줄 수, 실험 사용 로그를 증거로 삼았습니다. 보고서의 제목은 '2026년 10월 Anthropic의 AI 연구개발 가속에 대한 독립 평가'이며 11월 5일 자로 공개됐습니다.
평가는 세 가지 질문에 집중했습니다.
| 질문 | 보고서의 답 |
|---|---|
| 내부 역량 성장이 실제로 빨라졌는가 | 그렇다 |
| 가속 가운데 AI에 돌릴 수 있는 몫은 얼마인가 | 약 80% |
| 가까운 시일 안에 병목이 있는가 | 12개월 안에는 보이지 않음 |
보고서가 제시한 핵심 수치
가장 중심이 되는 수치는 '약 2배'입니다. 2026년 10월 기준 Anthropic은 잘 정의된 과제(well-specified tasks)에서 모델 역량을 2024년 3월부터 2025년 10월 사이의 평균보다 약 2배 빠르게 개선하고 있습니다. 여기서 잘 정의된 과제란 주로 시스템 인프라 최적화나 학습 파이프라인을 떠받치는 자율 코드 생성처럼 핵심 AI 연구개발 공정에 속하는 일을 뜻합니다.
다만 METR은 이 값에 폭을 두었습니다. 직원마다 평가 방법이 달라 실제 배율은 1.3배에서 3배 사이일 수 있다고 적었고, Anthropic의 내부 역량 지수인 AECI 기준으로는 2025년 10월 이후 가속 계수를 1.9배, 95% 신뢰 구간을 1.5~2.8배로 제시했습니다.
| 지표 | 수치 |
|---|---|
| 잘 정의된 과제의 역량 개선 속도 | 과거 대비 약 2배(1.3~3배 범위) |
| AECI 가속 계수 | 1.9배(95% 신뢰 구간 1.5~2.8배) |
| 가속 가운데 AI 기여분 | 약 80% |
| AECI 연간 증가폭 | 2024년 초~2025년 말 약 +15점, 그 이후 +29점 이상 |
| 1년치 진전의 크기 | 2025년 10월~2026년 10월 1년이 2023년 10월~2025년 10월 2년과 맞먹음 |
AECI 추이를 보면 2024년 4월 Claude 3 Opus부터 Claude 3.5 Sonnet, Claude Opus 4까지는 해마다 약 15점씩 오르는 직선에 가까웠습니다. 2025년 말 Claude Opus 4.5 이후 곡선이 꺾여 Claude Opus 4.6, 초기 Mythos 모델, Claude Opus 5.5를 거치며 연 29점 이상으로 가팔라졌습니다. 이 변화는 선형 추세에서 가속 곡선으로의 전환으로 요약할 수 있습니다.
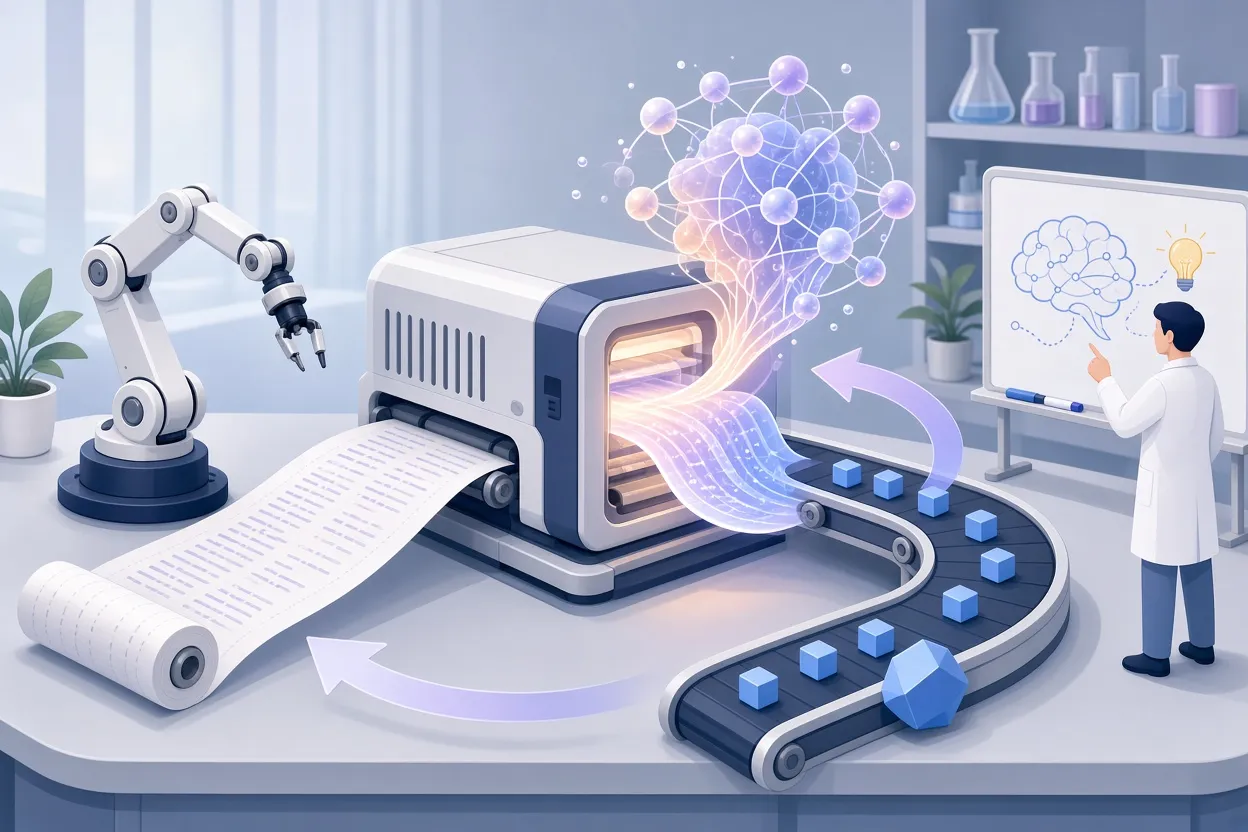
▲ AI가 AI 개발을 돕는 되먹임
가속의 원인을 AI라고 본 근거
빨라진 것 자체보다 중요한 질문은 '왜'입니다. METR은 학습 compute 증가, 공격적인 채용, 사람의 알고리즘 발견 같은 비AI 요인이 원인일 가능성을 하나씩 검토했습니다. 결론은 compute 성장률의 증가가 가속을 설명하지 못한다는 것이었습니다. Anthropic이 올해 초 frontier 모델을 서비스하는 데 운영상 제약을 겪었다는 사실도 대규모 인프라 확장이 주된 동력이 아니었음을 뒷받침한다고 봤습니다. 다만 compute 확장에 관한 세부 증거는 Anthropic의 요청으로 비공개 처리됐습니다.
대신 보고서는 2025년 말 Claude Opus 4.5의 등장을 변곡점으로 지목합니다. 그 이전의 AI 코딩 도구가 짧은 코드 조각을 완성하는 수준이었다면, Claude Opus 4.5부터는 agent(스스로 계획하고 도구를 써서 일을 끝내는 AI)가 앱의 기능 하나와 아키텍처 구성 요소를 통째로 만들 수 있게 됐습니다. 이후 Mythos Preview에 agent scaffolding(agent가 반복 작업을 수행하도록 감싸는 실행 틀)을 붙이자 모델이 실험 반복을 자율적으로 돌리는 데 실제로 쓸모 있어졌다는 것이 연구자들의 평가입니다.
익명 처리된 Anthropic 연구자들의 인터뷰도 같은 방향을 가리킵니다.
- 전반적인 생산성 향상은 2배에서 4배 사이이며, 내부 모델의 도움이 다른 모든 요인을 합친 것보다 큰 단일 효과라는 증언이 반복됩니다.
- 아이디어를 떠올린 시점부터 실험을 돌리기까지 걸리는 시간이 60% 줄었고, 사람이 직접 구현하며 생기는 실수가 줄어 20%의 추가 이득이 있었다는 보고가 있습니다.
- 회의적인 연구자들도 15~20%의 향상은 인정했습니다.
- 모델 개발의 병목이 더는 코드 작성이 아니며, 제약이 아이디어와 가용 compute로 옮겨 갔다는 데 여러 연구자가 동의했습니다.
- 1년 안에 2년치 이상의 진전이 있었다는 데 다수가 동의했고, 4년치에 해당한다는 견해도 있었습니다.
완전히 자율적인 AI 연구개발은 아직 실현되지 않았지만, 핵심 모델 학습에 AI가 자율적으로 기여하는 날이 머지않았음을 보여 주는 '생명의 신호'가 뚜렷하다는 것이 연구자들의 관찰입니다.
미공개 모델과 포화되는 benchmark
보고서 부록은 아직 공개되지 않은 내부 모델인 Model 3, Model 4, Mythos 5의 데이터를 담고 있습니다. 앞선 system card(모델 공개 시 함께 내는 설명 문서)들은 Mythos Preview에서 보인 도약을 일회성 급등으로 해석했지만, 그 뒤의 내부 모델들은 기울기 변화가 지속되고 있음을 보여 줍니다. 9개월 전 Claude Opus 4.6이 일부 과제에서 50%를 밑돌던 평가에서 Model 4는 전반적으로 50%를 넘겼고, Anthropic은 새 모델이 기존 benchmark(모델 성능을 재는 표준 시험)를 빠르게 포화시키는 바람에 내부 benchmark를 계속 더 어렵게 만들어야 했습니다.
재무 지표가 보여 주는 같은 그림
기술 지표와 별도로 Anthropic이 기업공개를 앞두고 제출한 S-1 서류의 수치도 같은 방향을 가리킨다는 해석이 가능합니다. compute에 $1를 쓸 때 거두는 매출이 분기마다 크게 달라졌습니다.
| 분기 | compute $1당 매출 | 비고 |
|---|---|---|
| 2025년 4분기 | $0.67~0.69 | compute 기준 큰 적자 |
| 2026년 1분기 | 약 $1 | 손익분기 도달 |
| 2026년 2분기 | $2.08 | 매출 $116억, compute 비용 $56억 |
| 2026년 3분기 | $1.72 | 매출 $170억, 단기 인프라 압박으로 비율 하락 |
같은 하드웨어에서 더 많은 매출을 뽑아낸다는 것은 모델이 과제를 훨씬 적은 자원으로 처리하게 됐다는 뜻으로 읽힙니다. 참고할 만한 사례로 Google DeepMind는 AlphaEvolve 논문에서 AI로 데이터센터 하드웨어 구조를 개선해 1%의 효율 향상을 얻었고, 이것이 수십억 달러 규모의 절감으로 이어졌다고 밝힌 바 있습니다. Anthropic의 AI 시스템도 내부 작업 흐름, 코드 생성, 자원 배분을 계속 최적화해 기존 하드웨어의 성능을 끌어내고 있다고 볼 수 있습니다.
▲ 평가 접근 범위와 비공개 처리의 한계
이 보고서를 읽을 때 염두에 둘 한계
보고서가 강한 결론을 내리는 만큼, 보고서 스스로 밝힌 제약도 함께 봐야 합니다.
- 비공개 처리 권한. Anthropic은 경쟁사에 도움이 될 수 있는 독점 정보를 가릴 권리를 가졌고, METR이 외부에 공개할 내용에 대해서도 통제권을 행사했습니다. 외부 독자는 가려지지 않은 결과만 보는 셈입니다.
- 약속과 다른 접근 방식. 9월에 공언된 '직원 수준의 상시 접근'과 달리, 이번 평가는 Anthropic이 정보 요청을 승인하거나 거절할 일방적 권리를 가진 협상형 접근 모델로 진행됐습니다. 10월 15일 Responsible Scaling Policy 갱신에서 언급된 독립 평가자 틀과도 별개의 계약이었습니다.
- 중도 범위 축소. Anthropic은 평가 도중 계약 범위를 바꿔, 역량 연구와 안전 연구 사이의 compute 배분을 독립적으로 검증하는 항목을 제외했습니다. Anthropic은 당분간 위험 평가에만 집중하기 위한 조치라고 설명했습니다.
- 내부 의견 차이. METR 직원 사이에서도 가속의 정확한 크기를 두고 의견이 갈렸고, 1.3~3배라는 넓은 범위가 그 불확실성을 반영합니다.
- 잘 정의된 과제의 범위. 코딩과 엔지니어링처럼 목표가 분명한 과제에서의 가속이 목표가 흐릿한 넓은 연구 문제로 얼마나 옮겨 가는지는 아직 불확실합니다.
- 증거의 질. 사내 Slack 설문으로 모은 자가 보고 생산성 수치는 엄밀한 과학적 증거라기보다 가벼운 참고 자료라는 점을 보고서도 인정합니다.
하나 더 짚을 점이 있습니다. 연구자들은 compute가 병목이라고 말하는데, METR은 compute 확장이 가속의 원인이 아니라고 결론지었습니다. 두 진술은 '현재 더 빨리 가지 못하는 이유'와 '지금까지 빨라진 이유'를 각각 말하는 것이어서 양립할 수 있지만, 이 관계가 보고서에서 충분히 풀리지는 않았다고 보입니다.
과장과 실제 신호를 가르는 기준
이 보고서를 둘러싼 논의에서 독자가 적용해 볼 만한 구분은 다음과 같습니다.
보고서가 실제로 확인한 것
- 잘 정의된 연구개발 과제에서 역량 개선 속도가 과거의 약 2배라는 점
- 그 가속의 약 80%가 AI 도구 사용에서 왔다는 점
- 향후 12개월 안에 알고리즘, 학습 compute, 실험 compute, 데이터 어느 쪽에서도 뚜렷한 병목이 보이지 않는다는 점
- 미공개 내부 모델에서도 기울기 변화가 이어진다는 점
보고서가 말하지 않은 것
- singularity나 superintelligence가 특정 시점에 온다는 예측. '12개월'은 병목이 보이지 않는다고 판단한 기간이지 어떤 사건의 도래 시점이 아닙니다.
- 완전 자율 AI 연구개발이 이미 실현됐다는 주장. 보고서는 '생명의 신호'라고 표현합니다.
- 코딩 과제의 가속이 연구 전반의 가속과 같다는 결론.
따라서 "recursive self-improvement가 이미 시작됐다"는 표현은 보고서 수치에 대한 하나의 해석이며, 그 해석의 근거는 'AI가 AI 개발을 돕는 되먹임이 측정 가능한 수준으로 작동하고 있고 가까운 병목이 보이지 않는다'는 두 가지 사실입니다. 보고서 역시 더 똑똑한 모델이 더 유능한 후속 모델의 개발을 앞당기는 복리 효과가 형성되고 있으며, 수익 체감이나 병목이 없다면 내년에는 진전이 더 빨라질 수 있다고 우려를 표했습니다. 이 점에서 해석이 근거 없는 과장이라고 보기는 어렵습니다.
한편 인간의 이해 가능성이 줄어든다는 우려에는 구체적인 사례가 붙어 있습니다. weight space programming, 즉 모델이 중간 소스 코드를 쓰지 않고 신경망의 weight(모델 내부의 수치 매개변수)를 직접 생성하는 방식이 등장했다는 점입니다. 사람이 읽을 수 있는 코드를 거치지 않는 개발 방식은 해석과 조정의 여지를 좁힐 수 있습니다. 다만 사람이 유망한 연구 방향을 떠올리는 데서는 아직 우위에 있으며, 충분한 compute가 있으면 무차별 탐색이 인간 직관을 우회할 수 있다는 전망은 아직 전망의 단계입니다.
정리와 독자가 할 일
이번 METR 보고서의 의미는 'AI가 AI 개발을 빠르게 하고 있다'는 오랜 추측이 처음으로 외부 평가 기관의 내부 자료 검토를 거쳐 수치로 확인됐다는 데 있습니다. 동시에 접근 범위, 비공개 처리, 자가 보고 의존 같은 한계를 보고서가 스스로 적어 두었다는 점도 분명합니다. 앞으로 비슷한 전망을 접할 때 다음 기준을 적용해 볼 수 있습니다.
- 회사의 마케팅 자료가 아니라 METR 같은 독립 평가의 원문과 그 안의 신뢰 구간, 비공개 처리 표시를 확인합니다.
- '몇 배 빨라졌다'는 주장에는 무엇을 기준으로, 어떤 과제에서, 어느 기간을 비교했는지 따져 봅니다.
- 아이디어에서 실험까지 걸리는 시간 같은 내부 생산성 지표가 frontier 역량 도약의 선행 지표가 될 수 있으므로, 이런 수치의 변화를 눈여겨봅니다.
- benchmark가 포화되고 있다는 소식은 모델이 못 하는 일이 없어졌다는 뜻이 아니라 측정 도구가 뒤처졌다는 뜻이므로, 새로 만든 더 어려운 평가의 결과를 기다려 판단합니다.
- 개발 업무를 하는 독자라면 사람이 코드를 직접 쓰는 방식에서 agent가 실험을 설계하고 돌리는 방식으로 작업 흐름이 옮겨 가는 흐름에 대비하고, agent가 만든 변경을 테스트와 디버깅으로 검증하는 습관을 유지합니다.
보고서가 던지는 질문은 '언제 singularity가 오는가'보다 '가속을 측정하고 검증할 외부의 눈이 충분히 확보되어 있는가'에 가깝습니다. 9월의 약속과 11월의 실제 평가 사이에 남은 간격이 앞으로 어떻게 메워지는지가, 이 흐름을 읽는 다음 지표가 될 것으로 보입니다.


