최근 ChatGPT, Gemini, Claude에 나온 업데이트를 모아 보면 한 방향이 보입니다. AI를 따로 여는 대화 창에 두지 않고, 사람들이 이미 일하는 브라우저와 문서 도구 안으로 들여놓는 쪽입니다. Anthropic은 Claude를 Google Docs, Sheets, Slides 안에 사이드바로 넣었고, ChatGPT는 Chrome에 열어 둔 탭을 읽고 웹 양식 입력과 파일 내려받기까지 맡게 됐습니다. ChatGPT의 Voice Mode는 한국어를 포함한 6개 언어를 새로 지원하고, Gemini는 외부 서비스 connector(다른 서비스와 연결하는 기능)와 AI 이미지 확인 기능을 더했습니다. 개발자용으로는 OpenAI가 GPT-6.1 Sol보다 token(모델이 글을 처리하는 단위) 생성 속도가 8배 빠른 GPT-6.1 Ultrafast와 판단 전용 도구 Decisions를 API 플랫폼에 내놓았습니다. 무엇을 지금 써 보고 무엇을 따져 볼지 기능별로 정리합니다.
Claude, Google Docs·Sheets·Slides 안으로
Anthropic이 내놓은 Claude for Google Workspace는 Google Drive와 Gmail, Google Calendar 계정을 Claude에 연결합니다. 공식 Chrome 확장 프로그램을 설치하면 Google Docs, Google Sheets, Google Slides에서 Claude가 사이드바로 열립니다. 문서를 복사해 다른 창에 붙여 넣지 않고, 작업하던 파일 옆에서 바로 고치고 분석하는 방식입니다.
| 도구 | Claude가 맡는 일의 예 |
|---|---|
| Claude for Docs | 경영진용 인력 운용 계획 문서를 다시 구성하고, 소제목을 다듬고, 글머리 목록을 비교 표로 바꿈 |
| Claude for Sheets | CSV 예산 보고서를 불러와 계획 대비 실제 지출의 차이를 계산하고, 예산을 넘긴 부서를 표시한 뒤 요약 표 작성 |
| Claude for Slides | Salesforce의 고객 메모와 Drive 자료를 모아 분기 사업 검토(QBR) 발표 자료 한 벌 완성 |
Anthropic은 이와 별도로 Claude 웹 앱 왼쪽 메뉴에 Design을 마련했습니다. 발표 자료, 사용자 화면(UI), 코드, 디자인 시스템을 Google Workspace 없이 Claude 안에서 만드는 공간입니다. Google Workspace로 일하는 팀은 사이드바를, 그렇지 않은 사람은 Design을 쓰는 식으로 나눠 쓸 수 있어 보입니다.
ChatGPT, 브라우저 탭과 음성으로 일한다
@Chrome으로 열어 둔 탭 맡기기
ChatGPT도 공식 Chrome 확장 프로그램을 설치하면 Chrome과 바로 이어집니다. prompt(AI에 주는 지시문)에 ’@Chrome’을 넣으면 ChatGPT가 지금 열려 있는 탭을 읽고 그 내용을 바탕으로 답합니다. 예를 들어 소파를 고르느라 여러 상품 탭을 열어 둔 채 “이제 소파를 사려는데, 보고 있는 것 중 우리 집에 가장 잘 맞는 건 뭐야?“라고 물으면, ChatGPT가 탭마다 크기, 천 소재, 가격을 비교해 특정 제품을 골라 줍니다.
탭을 읽는 데서 끝나지 않습니다. 웹 양식을 채우고, 파일을 내려받고, 사용자를 대신해 브라우저에서 페이지를 옮겨 다니는 일도 맡길 수 있습니다. 비교와 정리는 바로 맡겨 볼 만하지만, 양식 제출이나 내려받기처럼 실제로 무언가를 바꾸는 작업은 결과를 직접 확인하는 편이 안전해 보입니다.
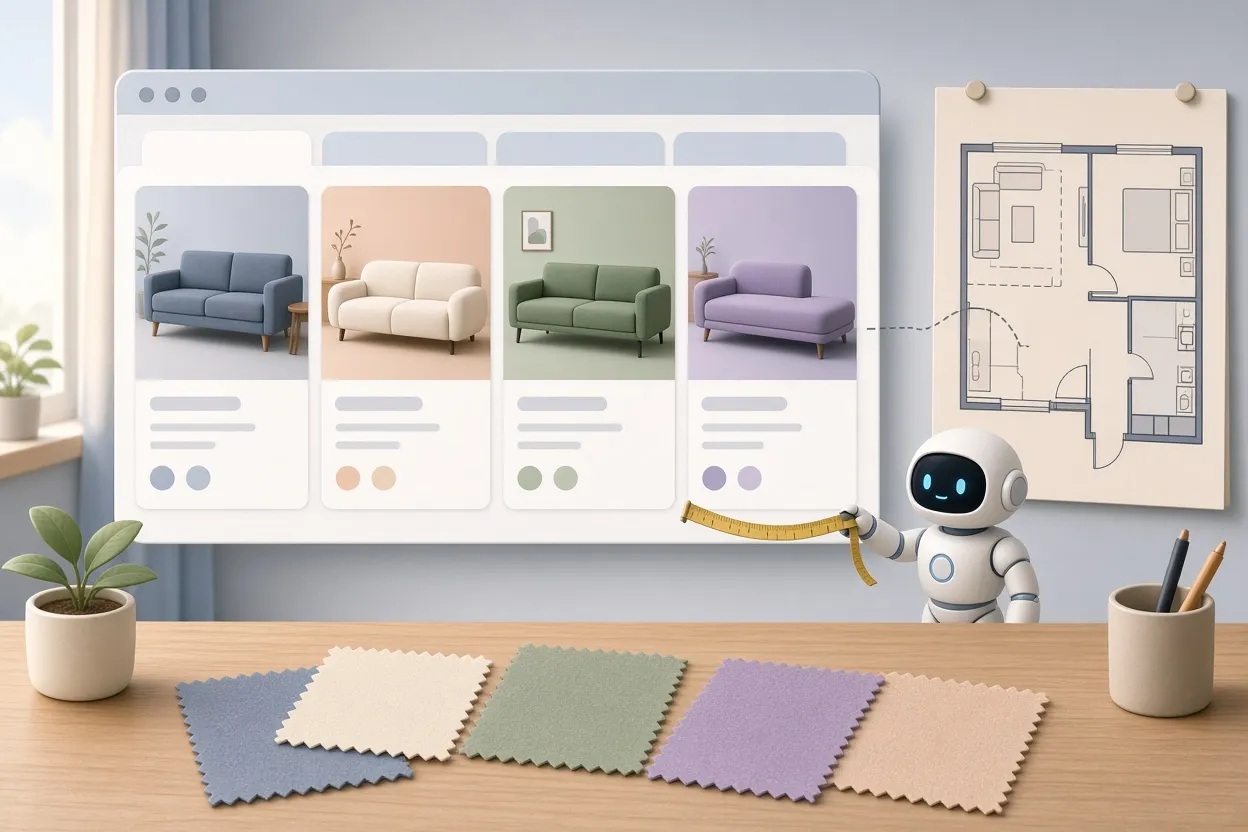
▲ 열린 탭을 비교하는 AI
GPT-Live-1.1, 한국어 음성 대화와 손을 쓰지 않는 작업
OpenAI는 Voice Mode의 모델을 GPT-Live-1.1로 바꿨습니다. ChatGPT와 Codex, dots에 함께 적용되며, 새 목소리가 추가되고 프랑스어, 독일어, 힌디어, 멕시코 스페인어, 한국어, 일본어 6개 언어로 자연스럽게 대화할 수 있게 됐습니다. 대화 중에 되풀이해 나오던 ‘Checking…’ 안내 음성도 사라졌습니다. 이 안내는 특히 vibe coding(코드를 직접 짜기보다 AI에 원하는 것을 설명해 프로그램을 만드는 방식) 중에 흐름을 자주 끊었습니다.
GPT-Live-1.1은 ChatGPT Work에도 들어갔습니다. Voice Mode를 켜면 키보드를 만지지 않고도 첨부 파일을 읽히고, 작업 공간의 도구를 다루고, plugin 기능을 실행하라고 말로 지시할 수 있습니다. 한국어가 새 지원 언어에 들어간 만큼 국내 사용자도 바로 시험해 볼 수 있습니다.
ChatGPT Work에 들어오는 MCP 앱
ChatGPT Work에서는 이제 개발자와 외부 plugin 제작사가 MCP(AI가 외부 도구와 데이터에 연결하는 표준 규격) 기반의 전용 앱을 만들어 넣을 수 있습니다. YouTube 채널 분석 서비스 vidIQ의 앱이 그 예입니다. 채널을 연결하면 최근 올린 영상의 성과와 같은 분야에서 반응이 크게 오른 영상을 보여 주고, 키워드 탭에서는 검색어마다 월간 검색량, 경쟁 점수, 최근 30일 수요 추이를 알려 줍니다. 제안된 작업을 누르면 ChatGPT Work가 뒤에서 조사를 진행해 장기 전략을 내놓고, 그 과정의 복잡한 시스템 prompt는 사용자에게 드러내지 않습니다.
Gemini, 연결 기능과 AI 이미지 확인
connector와 skill을 @로 불러 쓰기
Gemini의 ‘Customize Gemini’ 메뉴에서는 맞춤 skill(Gemini에 더해 쓰는 작업 기능)을 켜고 외부 서비스를 연결할 수 있습니다. 기본 connector는 Google Workspace를 비롯해 Dropbox, Canva, Shopify 등이 있고, 직접 지정한 MCP 서버 주소로 연결할 수도 있습니다. 메시지 입력창에 ’@’를 치면 켜 둔 skill과 connector 목록이 나타나 필요한 것을 바로 부를 수 있습니다.
@Verify AI, Google AI로 만든 이미지인지 확인
이 목록에는 SynthID(Google AI로 만든 콘텐츠를 가려내는 Google의 기술)를 쓰는 ’@Verify AI’도 있습니다. 이미지를 올리고 AI로 만든 것인지 물으면 Gemini가 살펴 판정합니다. 컴퓨터 바탕화면을 찍은 스크린숏은 Google의 AI 생성 도구로 만든 이미지가 아니라고 답하고, AI로 만든 인물 사진은 Google AI로 생성하거나 편집한 이미지라고 확인해 줍니다.
한계도 있습니다. Google AI로 만들었는지는 확실히 가려내지만, 다른 회사의 AI 도구로 만든 이미지라면 어떤 도구에서 나왔는지까지 늘 확인해 주지는 못합니다. 그래서 ’Google AI로 만들지 않았다’는 답을 AI와 무관한 이미지라는 뜻으로 받아들이지 않는 편이 좋겠습니다.
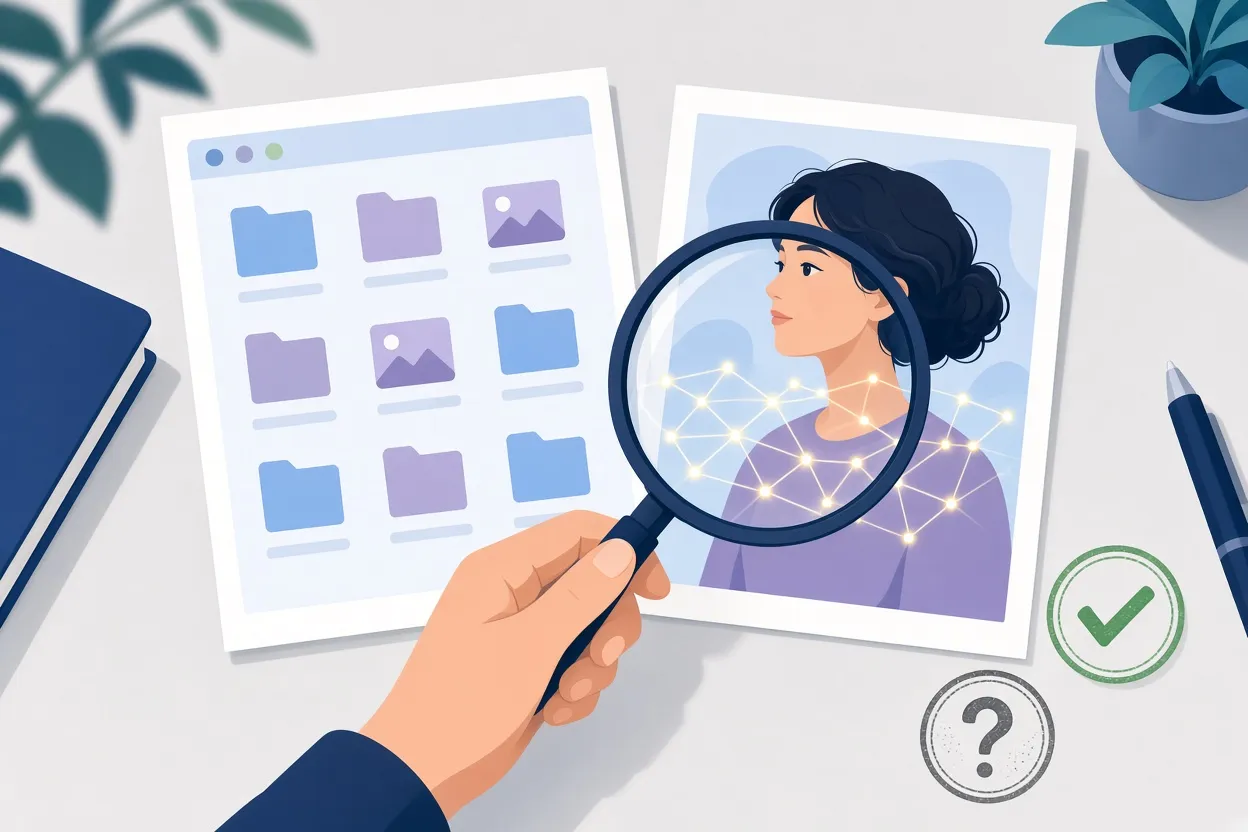
▲ 이미지 출처 확인
Gemini 4 Argon, 성능표에서는 대부분 앞서
Gemini의 모델 목록에는 Gemini 3.1 Pro 같은 기존 모델과 함께 Gemini 4 Argon이 올라왔습니다. 기업 업무와 여러 단계를 거치는 복잡한 추론을 겨냥한 Google의 새 최상위 모델로, 복잡한 재무 보고서 분석, 발표 자료 제작, prompt만으로 3D 모델을 만드는 작업을 내세웁니다.
Google이 공개한 성능표에서 Argon은 대부분의 benchmark(모델 성능을 비교하는 표준 시험)에서 비교 대상 세 모델보다 높은 점수를 받았습니다.
| benchmark | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|---|---|
| Vals Index | 68.9% | 67.0% | 63.1% | 65.8% |
| AutomationBench | 51.3% | 42.5% | 41.4% | 31.4% |
| DeepSWE v1.1 | 77.9% | 74.2% | 74.1% | 67.4% |
| Vibe Code Bench | 91.9% | 90.3% | 89.6% | 90.3% |
| GraphWalks 256k | 84.2% | 66.8% | 71.8% | 65.0% |
| RiemannBench | 76.0% | 69.3% | 72.0% | 65.6% |
| FrontierSWE v2 | 55.0% | 62.3% | 65.5% | 56.3% |
| Terminal-Bench 4.0 | 57.4% | 66.4% | 58.2% | 57.9% |
모든 항목에서 앞선 것은 아닙니다. 표 아래쪽의 FrontierSWE v2와 Terminal-Bench 4.0에서는 네 모델 가운데 가장 낮았습니다. Terminal-Bench Science 0.1에서는 GPT-6 Astra가 68.1%로 Argon의 57.6%를 크게 앞섰고, PostTrainBench에서는 Claude Opus 5.5가 49.3%로 Argon의 45.3%보다 높았습니다. OSWorld-2.0에서도 GPT-6 Astra가 72.6%로 Argon의 69.2%를 앞섰고, 보안 평가인 CWE-Bench v1에서는 Argon과 GPT-6 Astra가 68.0%로 같았습니다. FrontierSWE v2 같은 agent(목표를 받아 스스로 작업을 이어 가는 AI 프로그램) 방식의 코딩 지표에서 뒤진 데다 회사가 직접 공개한 수치인 만큼, 코딩용 모델을 고른다면 성능표보다 자기 작업으로 직접 비교해 보는 편이 좋겠습니다.
개발자용 GPT-6.1 Ultrafast와 Decisions
OpenAI의 개발자 API 플랫폼에는 GPT-6.1 Sol과 나란히 GPT-6.1 Ultrafast가 올라왔습니다. 답을 이루는 token을 Sol보다 8배 빠르게 만들어 냅니다. token당 가격은 더 비싸지만 같은 시간에 훨씬 많은 일을 끝낼 수 있어, 지연 시간이 중요한 대량 반복 agent 작업이라면 값을 더 치를 만해 보입니다.
개발자 대시보드에는 Decisions라는 새 도구도 생겼습니다. 일반 대화형 답변 생성과 따로 떨어진 판단 전용 기능으로, 평가 방식은 세 가지입니다.
| 방식 | 하는 일 |
|---|---|
| Predicate | 어떤 진술이 참일 확률을 0~100%로 계산(예: 이 고양이는 편안한 상태인가) |
| Choice | 여러 선택지를 주면 선택지마다 확률을 나눠 매김 |
| Score | 입력을 미리 정한 등급 순서에 비춰 보정된 점수를 냄 |
Decisions는 긴 답을 생성하는 대형 언어 모델을 통째로 돌리는 것보다 훨씬 빠르고 값도 크게 쌉니다. 결과도 거의 즉시 나옵니다. 분류, 선택, 점수 매기기처럼 답이 정해진 판단만 필요하다면 일반 대화형 호출 대신 Decisions로 옮겨 볼 만합니다. 아직 크게 주목받지 못한 것으로 보이지만, agent 안에서 되풀이되는 작은 판단의 비용과 시간을 줄이려는 개발자라면 먼저 살펴볼 기능입니다.
지금 써 볼 기능과 따져 볼 기능
바로 효과를 보기 쉬운 쪽은 이미 쓰는 도구 안으로 들어온 기능입니다. 반면 성능표와 속도를 내세운 기능은 내 작업에서 비용과 결과를 확인한 뒤 넓히는 편이 안전해 보입니다.
| 기능 | 이런 경우에 | 먼저 해 볼 일 |
|---|---|---|
| Claude for Google Workspace | Google Docs·Sheets·Slides로 일할 때 | 예산 시트 분석이나 문서 정리처럼 결과를 금방 확인할 수 있는 작업부터 맡기기 |
| ChatGPT의 @Chrome | 여러 탭을 오가며 비교할 때 | 상품·자료 비교부터 맡기고, 양식 제출과 내려받기는 결과 확인 |
| GPT-Live-1.1 | 말로 일을 시키고 싶을 때 | 한국어 음성으로 ChatGPT Work의 파일 작업을 지시해 보기 |
| Gemini의 connector와 @Verify AI | 여러 서비스를 Gemini로 묶을 때 | 자주 쓰는 서비스를 연결하고, 받은 이미지가 Google AI로 만든 것인지 확인 |
| Gemini 4 Argon | 여러 단계를 거치는 복잡한 작업을 맡길 때 | 모델 목록에서 고르되 코딩 용도는 자기 작업으로 비교 |
| Ultrafast와 Decisions | API로 agent를 만들 때 | 속도가 중요한 대량 작업은 Ultrafast로, 분류와 점수 매기기는 Decisions로 시험 |
세 회사의 경쟁이 모델 점수만큼이나 업무 도구 안의 자리를 두고 벌어지는 것으로 보이는 만큼, 새 모델 이름보다 매일 여는 프로그램에 무엇이 들어왔는지부터 확인해 보시기 바랍니다.