プロダクトマネージャー(PM)は今、トライアルから離脱した顧客にメールを送り、返信には数分以内に答え、自動返信を出す前に自分の回答を社内ドキュメントと照合するエージェントを自分で構築できます。構築にかかる時間は、Anthropicのコマンドライン型コーディングエージェントであるClaude Codeを使っておよそ30~40分。必要なのはルールを書いたMarkdownファイルとメール接続だけです。Boltの元最高プロダクト責任者で、現在は対話型AIのスタートアップを率いる人物が、この構築手順を一つずつ示しました。このプロセスは、同氏が掲げるより大きな主張、つまり「AIツールを使えば、PM1人と3~5人のエンジニアで、かつて20~25人のエンジニアを要した成果を出せる」という主張を具体的に検証する場にもなっています。
PMが数千件の対話を求める理由
Boltでは、プロダクトリーダーが月に7~8人の顧客と話せば、十分な調査頻度とみなされていました。自動化された双方向の対話は、この規模を根本から変えます。エージェントは毎月数万人のユーザーと往復のインタビューを行い、懸念をその場で解消し、統合したテーマを定期的にプロダクトチームへ返すことができます。
最も明確な数字は、同氏のスタートアップがAncestry.comと実施したA/Bテストから得られたものです。対象はDNAキットの購入手続きを途中で離脱した買い物客で、アウトリーチ群86,400人と、接触しない対照群85,900人に分けられました。
| グループ | 顧客数 | コンバージョン数 | コンバージョン率 |
|---|---|---|---|
| AIアウトリーチ | 86,400 | 15,898 | 18.4% |
| 接触なしの対照群 | 85,900 | 11,511 | 13.4% |
これは相対で37.3%の向上(p<0.001)にあたり、この1件の事例で約4,300件の追加注文が生まれた計算になります。エージェントは3,470件の対話を通じて、人々がためらった理由にもタグを付けました。1件あたり平均1.5のテーマが含まれていました。
| 異議のテーマ | 対話に占める割合 |
|---|---|
| プライバシーと予期しないDNAの発見 | 42.1% |
| ギフト用か自分用かというタイミング | 38.6% |
| サブスクリプションや隠れた費用への懸念 | 31.2% |
| 科学的な正確さへの疑念 | 24.5% |
| 競合する代替品 | 19.8% |
より有用なのは、異議ごとのコンバージョン率です。配送や到着時期について質問した買い物客は、エージェントが答えた後に41.3%の割合で購入に至りました。返信したユーザー全体のベンチマークは31.5%です。一方、サブスクリプションについて混乱していた買い物客のコンバージョン率は19.8%にとどまり、予期しない親族の発見を不安に思う人では14.2%でした。ここから示される解釈は、年末配送の締め切りのように事実で解消できる異議は対話でよく転換する一方、適切な回答をしても解消されない異議は、ロードマップで扱うべき価格設定やUXの問題を指し示している、というものです。
チェックインループを部品ごとに見る
このプロトタイプは「チェックインループ」と呼ばれ、5つの部品で構成されます。例として使われるのは、14日間のトライアルを持つ架空のAIフィットネスコーチングアプリ「Cadence」で、登録したもののほとんどアプリを使っていないユーザーに対し、12日目にアウトリーチを送ります。
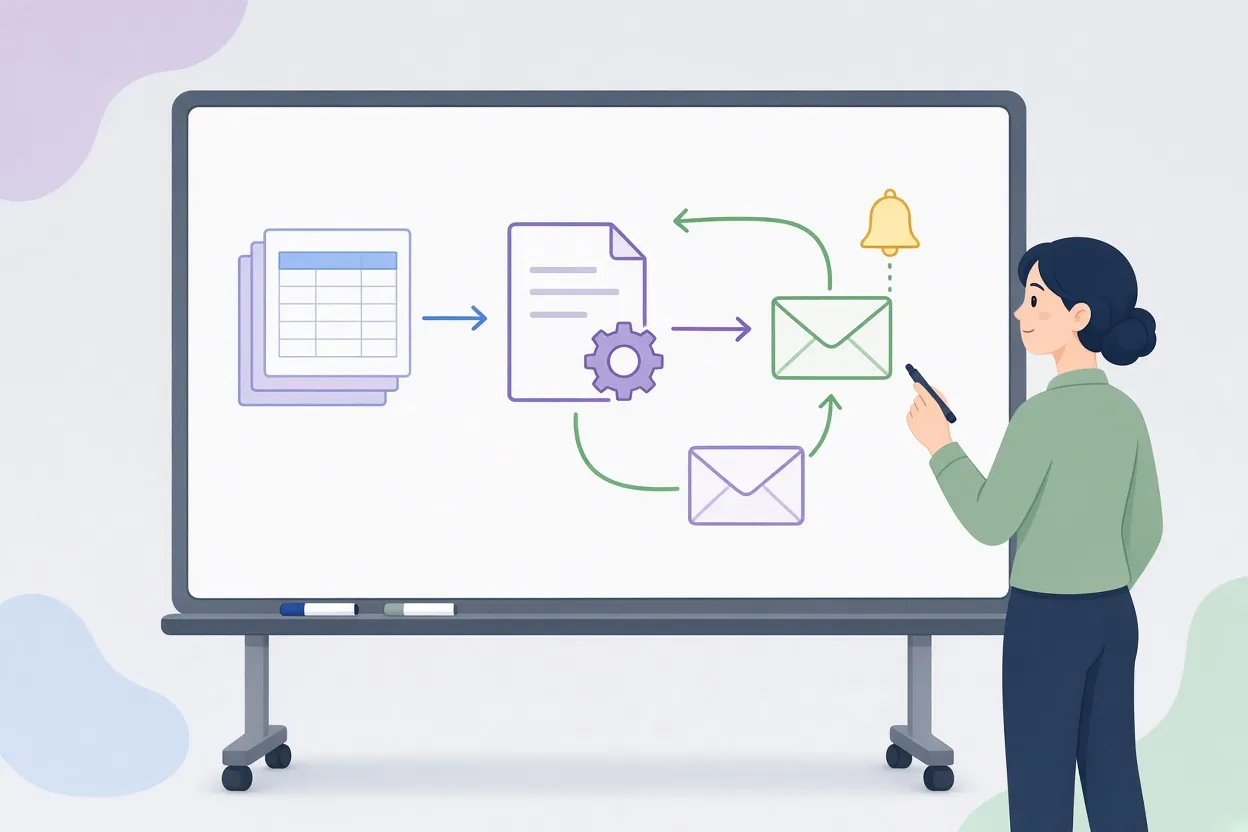
▲ 顧客チェックインループの構成
- 顧客データ。 最初はCSVのエクスポートで十分で、規模が大きくなればSnowflakeのようなデータウェアハウスやSegmentのような顧客データプラットフォームが使えます。鍵となる項目はトライアル離脱のタイムスタンプと利用履歴で、エージェントはこれを使って各メッセージをパーソナライズします。
- ルールファイル。 CLAUDE.mdという名前のMarkdownファイルに、メッセージの構造、トーン、エスカレーションの経路、エージェントの権限の範囲を定めます。Cadenceの場合は、ワークアウトのカスタマイズに関するルール、怪我に関する方針、返金の扱い、割引の上限がこれにあたります。こうしたドキュメントが社内にない場合は、Claudeに公開ウェブサイトを読ませて最初の版を下書きさせることができます。
- アウトリーチスキル。 スクリプトはまだ連絡していない離脱者を見つけ、各人のメタデータを使って短いメールを書き、送信します。サンプル実行での件名は人間が書いたように読めるもので、たとえば「HIIT Expressの調子はどうですか?」や「Rileyさん、Cadenceのトライアルは残り4日です」といったものでした。
- メールの送信経路。 送信は、AIエージェントが外部ツールを呼び出せるようにする標準規格のModel Context Protocol(MCP)を通じて行います。初期のテストや小規模なコホートにはGmailのMCPサーバーで十分ですが、Gmailには1日の送信上限があるため、より大きな量を扱うにはPostmarkのようなトランザクションメールサービス(こちらにもMCPサーバーがあります)を使うか、マーケティングチームと連携する必要があります。いずれにしても、PMはMedalliaやQualtricsのようなエンタープライズ向け調査プラットフォームに触れることなく、この実験を実行できます。
- 返信処理とアラート。 ユーザーが返信すると、エージェントはそのメッセージを通常の返信かエスカレーションかに分類し、数分以内に応答し、人間の対応が必要な場合はSlackに投稿します。あるサンプルのスレッドでは、トライアルユーザーがワークアウトの強度と予算の両方について懸念を示し、エージェントは与えられたルールの範囲内でその両方に対応しました。
最初のテスト実行では、返信が元のGmailスレッドに紐づかない、ときどき不適切な表現が混じる、といったありふれたバグが見つかりました。こうした点を修正して回す作業も、30~40分という見積もりに含まれています。
実際に返信が来るアウトリーチのルール
仕組みそのものより重要なのは、メールがどう読まれ、いつ届くかです。
- プレーンテキストで、質問は一つ。 メールはキャンペーンではなく1対1のやり取りに見えるべきで、その人がファネルのどこにいるかに結びついた直接的な質問を一つだけ添えて書き始めます。最初のメッセージにアンケートを詰め込むのが、最もよくある失敗です。
- 速く答える、ただし即答はしない。 自動返信に遅延を挿入すると返信率が急落し、コンバージョンもそれに伴って下がりました。人は受信箱を離れてしまい、勢いが途切れるためです。一方で、数秒以内の返信は機械的に感じられます。数分が最適な間合いです。
- 離れた人にはメールを使う。 アプリ内チャットはアクティブなユーザーには向いていますが、離脱したユーザーは定義上アプリの中にいません。また、利用中のセッションで調査を促すと、作業を終える妨げになることがあります。的を絞った調査メールの回答率は通常20~40%で、あるフィットネス企業のトライアル離脱テストでは約35%でした。回答率はファネルの深さに応じて上がり、製品を使った人はファネル上部の離脱者よりはるかに多く返信します。
- ライフサイクルの節目を狙う。 推奨される接点は、オンボーディングでの離脱(返信率は最も低いが量は最も多く、アクティベーションの障壁が見える)、トライアル中盤のチェックイン、コンバージョンなしでのトライアル終了、アップセルを検討したが購入しなかったユーザー、直近数週間で利用が落ちた休眠ユーザー、そしてサブスクリプションの解約です。
- トライアル終了時のメールにはインセンティブを添える。 フィードバックと引き換えにサブスクリプション20%割引のような特典を提示すると、迷っている見込み客からの返信が増え、エージェントが同じスレッドの中で異議を解消し、販売を取り戻す機会が生まれます。
こうしたスレッドは、再利用できるデータセットにもなります。PMは後から、過去の対話をClaudeにスキャンさせて、ある機能がないことに不満を述べた全員を見つけ、その機能がリリースされた際にテストへ招待することができます。
無人で返信させるための評価ループを加える
評価(eval)とは、パイプラインに組み込まれ、明示的な基準に対してモデルの出力を採点し、毎回実行されるチェックのことです。顧客に接するエージェントにとって最も重要な評価は「根拠性(groundedness)」、つまり返信に含まれるすべての主張が、ヘルプセンターやルールファイルといった承認済みのドキュメントにさかのぼれるか、という点です。
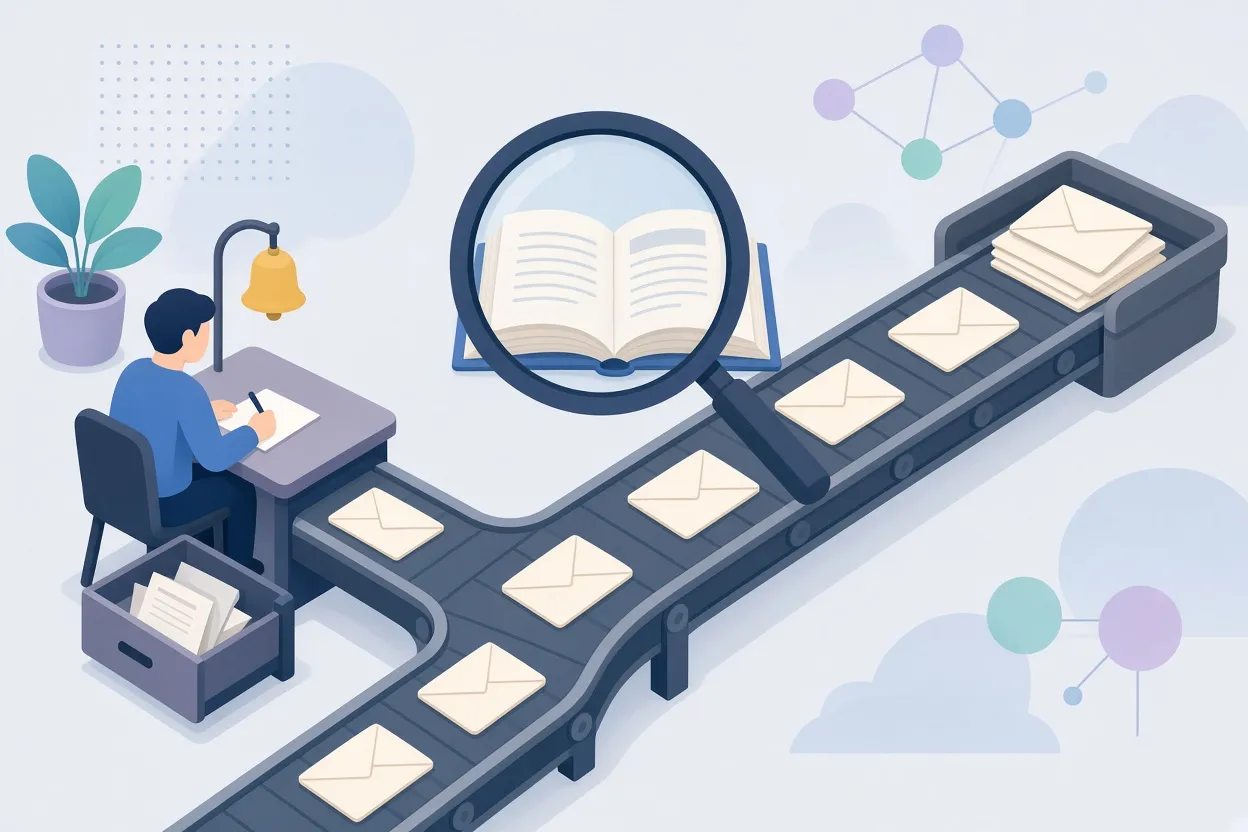
▲ 根拠性評価と再試行、下書きへの退避
このループはClaude Codeへの一つのプロンプトでCadenceのパイプラインに追加され、出来上がった設計はそのまま真似できるほど単純です。
- 評価を分類の後、送信の前に挿入する。 チェックは自動送信モードに設定された返信にだけ実行されます。エスカレーションはすでに人間に回されています。
- システムのドキュメントに照らして根拠性を判定する。 モデルが判定者となり、返信の下書きを、もっともらしさの感覚ではなく元のファイルと比較します。
- 不合格なら、理由を添えて一度だけ再生成する。 評価が示した「何が問題だったか」の説明を、生成プロンプトにコンテキストとして戻します。大多数のケースでは、2回目の試行で合格します。
- 再試行も不合格なら、送信せずGmailの下書きとして保存する。 人間が下書きを確認し、根拠のない内容は顧客に届きません。
- チームに通知する。 Claude Codeは、頼まれていないのに、評価の不合格ごとに失敗マーカー付きのSlack通知を追加しました。エージェント型のコーディングツールはこのように隣接するニーズを先回りすることが多く、便利な一方で、すべての差分を読むべき理由でもあります。
設計上、際立つ点が二つあります。第一に、このループを可能にしているのはメールです。チャットのユーザーは数百ミリ秒での応答を期待し、3分の待ち時間には耐えられませんが、メールの返信が3分後に届くのはまったく普通のことです。非同期のチャネルだからこそ、多段階の評価と再生成の余地が生まれます。第二に、評価は制約ではなく導きであるべきです。硬直した評価基準にプロンプトを過剰に合わせると、ぎこちないメッセージになります。不合格を全体の再生成のためのコンテキストとして扱えば、自然な推論を保ちながら、特定の欠陥だけを直せます。
同スタートアップのエンタープライズ向けプラットフォームには、プラットフォーム全体に適用されるガードレールが備わっており、ほかに何を評価すべきかのチェックリストとしても使えます。AIであることの開示と透明性、250語未満という簡潔さ、整ったメールの書式、検証済みのコンテキストへの根拠付け、そして決まり文句、埋め込み画像、未承認のクーポン、空のリンクパラメータ、シリアル番号、求められていない助言の禁止です。各下書きはこれらとドメイン固有のカスタムルールに照らしてチェックされ、適合するまで再実行されます。本番公開の前には、シミュレーションした顧客対話のバッチを使って運用者が出力を確認し、そのフィードバックをプレイブックとガードレールの更新に反映します。このエンタープライズ向けプラットフォームでは、ワークフローを把握したチームなら新しいエンゲージメントポイントの設定に5~10分しかかからず、大口顧客は数百のポイントを運用しています。
確率的なシステムをテストする
プロダクトマネジメントの基本はここでも変わりませんが、テストのパラダイムは変わります。従来のソフトウェアには、ある入力が特定の出力を生むことを検証する決定的なテストがあります。対話型エージェントは無数に変化するユーザー意図に向き合うため、チームには、根拠性や意図への忠実さといった主観的な性質を判定できる「LLMを判定者とする」フレームワークと、応答の構造化された部分に対する決定的なルールの組み合わせが必要になります。
ここからいくつかの実践が導かれます。
- 信頼できるサンプルデータセットを本番環境の外に保持し、モデルのアップグレードやプロンプトの変更があれば、デプロイ前にガードレールのベンチマークを同等の水準で通過することを必須にする。基盤モデルのバージョンを上げるだけでも、ユーザーに見える形で挙動が変わることがあり、週に何百回も反復するチームがこれを手作業で確認することはできません。
- 顧客に接するエージェントには、社内向けコパイロットよりはるかに高い基準を課す。社内ツールには公開前に出力を確認する従業員がいますが、顧客に接するエージェントにはそうした安全網がありません。
- 最終的なテキストだけでなく、中間のトレースを検査する。言語モデルはユーザーを喜ばせる方向に傾きがちなので、評価では、個々の行動がすべてシステムプロンプトとビジネスルールで明示的に許可されていたことを確認しなければなりません。よく引き合いに出される、自動車ディーラーのチャットボットがトラックを$1で売ることに同意した事例は、設計で防ぐべき失敗の典型です。
- 成功例も研究する。コンバージョンがほとんど起きない状況でエージェントが顧客を転換させたときは、そのトレースを解剖し、その手法をプロンプトとガイドラインに還元します。
PM1人は本当にエンジニア25人分なのか
Uberでは、PM1人に対してエンジニア3~4人が典型的な比率でした。チームが大きくなる前の最も生産的だった時期には、同じリーダーがPM1人対エンジニア25人の体制を回し、この比率がプロセスを焼き払い、全員を出荷に集中させたと感じています。同氏の主張は、AIツールを使うPM1人と3~5人のエンジニアからなるポッドが、かつて25人のエンジニアが出していた成果を今では出せる、というものです。
上記の構築は、この主張のより限定的な版を裏付けています。Claude Codeで1人で作業した人物が、データの取り込み、パーソナライズしたアウトリーチ、返信処理、評価と再試行のループ、下書きへの振り分け、Slackへの通知を1時間足らずで立ち上げました。この範囲の作業は、以前なら複数人のプロジェクトだったと言えるでしょう。チームの比率に関する主張そのものは、測定されたベンチマークではなく一人のリーダーの経験に基づくもので、同氏が明示する条件も伴います。PMは素早くコンテキストを切り替え、デザインやプロダクトマーケティングのような隣接する仕事を引き受け、出荷が速くなっても断片的な機能の山にならないよう製品をまとめ上げなければなりません。また、形式的に存在するだけの調整会議を断り、これまでカレンダーを埋めていたステータスレポート、計画書、会議準備はAIに下書きさせる必要があります。
同氏自身の4人の会社が、その運営モデルを示しています。チームは人間の時間の大半を、ホワイトボードやFigJam上で問題領域を議論し、顧客のジャーニーを描くことに使います。会議の文字起こしと図はカスタムのAIスキルに渡され、そこからプロダクト要求仕様書(PRD)が下書きされ、Linearのチケットに分割され、コーディングエージェントが最初の実装を担います。ボトルネックは作ることではなく、何を作るかを決めることです。PRDのテンプレートが義務付けられ、複数部門のレビューがある大企業でも、同じアプローチは機能します。高い帯域幅でブレインストーミングし、その文字起こしをAIに所定の形式へ落とし込ませて承認に回せばよいのです。
自動化すべきでないとき
最も強い注意点はタイミングに関するものです。プロダクトマーケットフィットの前、あるいは顧客数が少ない段階で、アウトリーチを自動化するのは誤りです。初期の探索は、チームに必要な直感を育てるビデオ通話と直接の関係に依存しており、それをエージェントに委ねると、PMはまさに重要なシグナルから切り離されてしまいます。自動化が適切なのは、製品が基本的な価値を示し、規模が体系的なエンゲージメントを要求するようになってからです。
その段階でも、自動化は人間の接触を置き換えるのではなく、その隣に置かれます。提案されているリズムは、ZoomやSlack、テキストで週に少なくとも2回は顧客と直接会話し、それを3つのAI主導の柱で支えるというものです。合成アバターとの対話、上記のループのような自動メール接点、そして営業電話とソーシャル上のフィードバックの自動統合です。Listen Labsのようなプラットフォームによる自動音声インタビューは、顧客基盤の大きな企業には規模を加えられますが、創業者との直接接触がまだ必要な極めて初期のスタートアップには過剰です。メールエージェントは選別のファネルとしてよく機能し、最も説得力のあるフィードバックを寄せた回答者を、より深い人間のインタビューへと浮かび上がらせます。背景調査が済んでいるため、PMは基本的な質問をすでに終えた状態でそのインタビューに臨めます。
ここから何をするか
実践の道筋は短いものです。離脱日と利用状況を含むトライアル離脱者のCSVをエクスポートします。トーン、エスカレーションの条件、返金と割引の上限を定めたCLAUDE.mdを書くか、自社のウェブサイトからClaudeに下書きさせます。小規模なコホート向けにGmailのMCPサーバーを接続し、質問を一つだけ含むプレーンテキストのメールを送ります。エージェントに単独で返信させる前に、不合格の理由を添えて一度再生成し、それでも通らなければ人間の確認用に下書きを保存する根拠性評価を追加し、コーディングエージェントが出す差分はすべて読みます。適切な回答の後もコンバージョンしない異議がどれかを見極めてください。それはメッセージの問題ではなくロードマップの項目です。そして、まだプロダクトマーケットフィットを探している段階なら、電話は自分でかけ続けてください。


