Y Combinator出身のスタートアップArdentは、本番環境のPostgreSQLデータベースを完全に分離したコピーとして6秒以内に作成し、数十から数百のAIコーディングエージェントが本番データに触れることなく並列で変更をテストできるようにします。同社は最初からこの構想で始まったわけではありません。創業者は誰も欲しがらない製品を1年かけて出し続け、自分のデータベースを壊し続けるAIデータエンジニアを作り、単独創業者として$220万を調達し、月額$100を支払う3社の顧客を抱えた状態で12月にピボットし、7回の不採択を経て8回目の応募でY Combinatorに採択されました。この物語が役立つのは、その劇的さよりも、そこから見えてくる判断の基準にあります。本当の問題はどのように気づかれるのか、顧客のフィードバックはどう製品の方向を変えるのか、そして何度断られても続けるべきなのはどんなときか、という点です。
問題:1つのデータベースに並列エージェント
創業者の前の製品は自律型のAIデータエンジニアでした。同じデータベースに対して複数のエージェントを同時に走らせたところ、Ardentの種となる障害パターンが見つかりました。2つのエージェントが単一の状態に対して相反するスキーママイグレーションを試みると、解決不能な衝突とデータ破損が生じます。エージェント1がエージェント2の依存するものを上書きしてしまうのです。分離がなければ、エンジニアはマイグレーションスクリプトやスキーマ変更を本番にマージする前に現実的に検証できず、衝突はやがて復旧コストの高い障害として表面化します。
Ardentの考え方は、GitとGitHubがブランチとクローンによってソースコードでこの問題を解決したのだから、同じモデルを稼働中のデータベースの状態にも適用すべきだ、というものです。GitHubが自社のインフラを単純にデータベースへ拡張できない理由は物理的なものです。ソースファイルは小さく離散的なので、クローンの計算コストは取るに足りません。一方、データベースはテラバイトからペタバイト規模の状態を抱え、ディスクのIOPS(1秒あたりにディスクが処理できる読み書き回数)とネットワーク帯域に縛られます。素朴なファイルコピーではスケールしません。
共有ステージング環境が失敗する理由
従来の答えは集中型のステージングデータベースです。Ardentの立場では、この構成は安全装置どころか障害の構造的な原因であり、その理由はいくつかあります。
| ステージングの慣行 | 何が問題になるか |
|---|---|
| 完全なエクスポートとインポート | データ1テラバイトあたり6~8時間 |
| 夜間の同期ジョブ | 同期が1回失敗するとチーム全体が1日分の作業を失う |
| 1つのステージングデータベースに複数のエージェント | 重なり合う書き込みが互いの状態を静かに壊す |
| より小さなデータサブセット | 本番にしか存在しないエッジケースの異常が欠落する |
最後の点は、AIエージェントでコードをテストするすべての人に関わります。削ぎ落としたサブセットで通ったテストが本番で壊れることはあり得ます。障害の原因となる異常は、完全なデータセットの中にしか存在しないからです。
クローンの仕組み
Ardentはコピーオンライトのアーキテクチャによって物理的なコピーを完全に回避します。これは、新しいコピーが元のデータを共有し、実際に何かが変更されたときだけ新しいブロックを書き込む手法です。エージェントやエンジニアがクローンをプロビジョニングすると、Ardentは新しいコンピュートインスタンスを作成し、そのポインタが読み取り要求を元のデータセットに向けます。インデックスのルーティングや構造上の参照はメタデータが担います。生データが移動しないため、ペタバイト規模のデータベースのクローンも6秒以内に現れます。
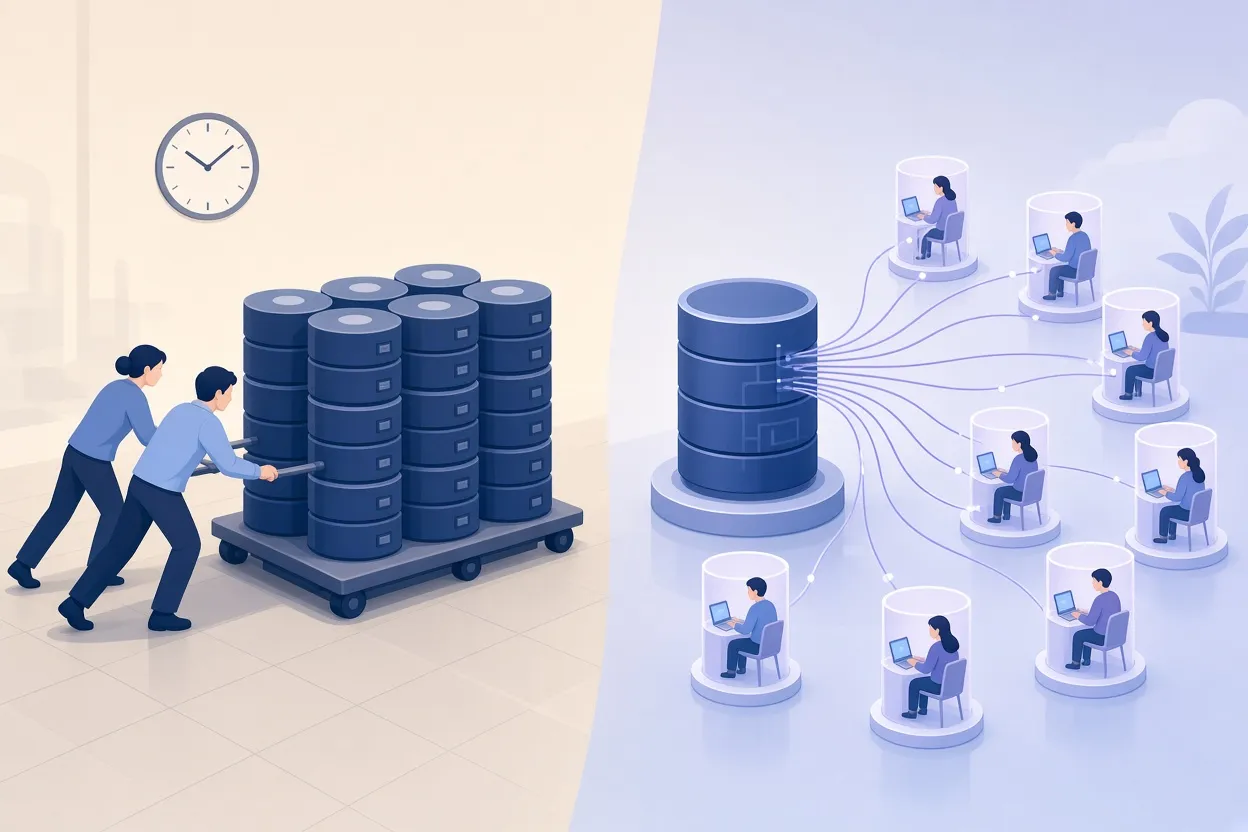
▲ ステージングのデータコピーとコピーオンライトのクローン
これは、データベースのサンドボックスを通常のコンピュートサンドボックスと同じ方法では作れない理由でもあります。企業の巨大なテーブルをまるごとメモリに読み込もうとするコンピュートサンドボックスは即座にクラッシュします。データベースの状態はメモリ、ディスク、ネットワークに異なる制約を課すのです。Ardentは水平スケールするように設計されており、同社によれば数百、数千、数万のアクティブなクローンを同時に稼働させられるといいます。
オンボーディングは4つのコマンドラインインターフェース(CLI)コマンドにまで絞り込まれています。認証、コネクタコマンドによるデータベースの接続、機能名などの名前を付けたブランチの作成、チームメンバーの招待です。ある顧客は、Ardentを課題管理ツールのLinearとクラウド上のコーディングエージェントにつなぎました。彼はノートパソコンからデータベース関連のタスクの山を投入し、車に座ったままノートパソコンを閉じ、エージェントにクラウド上の実データベースのクローンで作業を検証させました。
理解した人々と、顧客の来かた
Ardentの資金調達には逆張りのピッチが必要でした。多くの投資家はデータベースのサンドボックスを基本的なコンピュートサンドボックスと混同し、インフラの実務経験のない人には、状態があることでなぜ制約が変わるのかが伝わりませんでした。価値をすぐに理解した投資家は、ステージングの破損や壊れたマイグレーションを自ら経験した元技術者でした。自律型AIエージェントが稼働中の本番データベースを消してしまったという話がXで広く共有されたことも認知の向上を助けました。ディープなインフラ領域の創業者にとっての実践的な教訓は、その問題を肌で感じたことのある支援者を選び分けることです。
顧客獲得はオーガニックで、XとLinkedInでの継続的な投稿とやり取りが原動力です。エージェントを導入する開発者は自力でデータベース破損にぶつかりがちなので、インバウンドの見込み客はたいてい問題を理解した状態でやって来ます。需要が本物であれば、最初の通話は売り込みではなくオンボーディングになる、というのが同社の主張です。ある顧客はオンボーディングの通話の最初の10分間、クラウド自動化への驚きを口にし続けたと伝えられています。
ピボットへの道
現在の製品は、長い失敗の連続の上に成り立っています。2023年、純粋なソフトウェアエンジニアとして働いていた創業者は、およそ1年をかけて誰も欲しがらない4つの製品を作りました。5人のユーザーがプロトタイプを試しては、すぐに離脱していきました。当時は自動化されたAIコーディングツールがまだ未熟で開発サイクルが長く、無駄にした1か月ごとのコストが大きかったのです。この経験から、誰も気に留めないものを作っているときの紛れもない感覚を学んだと彼は語ります。
次のアイデアは機械学習の経歴から生まれました。モデルの出力は上流のデータ品質に制約される、というものです。データ品質が本当のボトルネックかどうかを確かめるため、彼は作る前に50~60人の機械学習エンジニアやデータエンジニアにインタビューしました。そして以前とは順序を逆にし、最小限のプロトタイプやランディングページを用意して、まず売ることを試みました。単独創業者として1年かけてAIデータエンジニアを開発・マーケティングし、1人で$220万を調達し、最初の年間経常収益の契約を獲得しました。
12月、彼はAIデータエンジニアの出力を検証することが根本的なボトルネックであり、それは自分のユーザーだけでなく業界全体に当てはまると気づきました。この気づきと、エージェントを並列で走らせたときに目にしたデータベースの衝突が重なり、Y Combinatorを前にしたピボットにつながりました。初期の最小実用製品は、動くもののバグの多いプロトタイプとしてプログラムに入りました。3社のパイロット顧客がそれぞれ月額$100を支払い、毎日ブランチIDとバグ報告を送ってきました。創業者はこれを、製品が彼らにとって切実な問題に応えている証拠と受け止めています。
片道切符とソファでの1年
これらすべての前に、創業者はシアトルで修士課程を終え、大企業のエンジニア職のオファーを断っていました。彼の見方では、成熟したビッグテックが支配するシアトルのエコシステムは、人を高い給与、持ち家、ワークライフバランスへと向かわせ、ゼロから始める創業者は孤立感を抱きかねません。彼は会社をゼロから立ち上げることに取り憑かれた環境を求め、投資と貯蓄を換金して$10,000を手にし、サンフランシスコ行きの片道切符を買い、友人のソファで寝るつもりでした。
▲ 創業者のソファでの1年と7通の不採択通知
後戻りの余地をなくすため、彼は切符の写真をXに投稿しました。それまでほとんど投稿したことがなく、オンラインで何かを売った経験もなく、「いいね」は5件ほどだろうと見込んでいました。過去最高の投稿でも表示回数はおよそ300回でした。ところが2時間以内にベイエリアの著名なアカウントが引用投稿を始め、投稿は一晩で25万回の表示に達し、投資家、協力者、地元の創業者からダイレクトメッセージが届きました。フライトは3か月先に予約していましたが、その週末に前倒ししました。その後、彼はほぼ丸1年をソファの上で過ごしながら事業を築きました。
この経験が彼のディストリビューション観を形づくりました。初期のバイラルは運のように感じられますが、十分に繰り返せば設計されたシステムになります。彼によれば、隔週のペースで10万から20万回の表示を安定して生み出せるようになったといいます。実践的なルールは、世界を変えるような発表を待つのではなく日常の開発経験や率直な振り返りを公開すること、そしてXとLinkedInで別々のペルソナを作り込むのではなく、同じメッセージを軽く体裁を変えて両方に投稿することです。別々のペルソナは不自然で消耗すると彼は感じています。また、フォロワーが多くても自動的に良い採用につながるわけではないとも注意を促しています。
Y Combinatorへの8回の応募
創業者はY Combinatorに7回応募し、そのたびに不採択でした。YC出身の友人たちが、失うものはないと言って8回目の応募を後押ししました。提出から4日以内に面接の招待が届き、彼は現地に足を運びました。YCのグループパートナーからの採択メールは迷惑メールフォルダに入ってしまい、フォローアップの電話があるまで1日パニックに陥りました。
アクセラレーターに株式を渡す判断について、彼はネットワーク、コミュニティ、資本が成功の確率を測定可能なほど高めるかどうかという厳密な計算として捉えています。Ardentの場合、プログラムはブランドの信頼性、顧客の紹介、人材へのアクセスをもたらし、その中にはデータエンジニアリング歴20年のCTOも含まれます。技術面の責任をそのCTOに委ねたことで、創業者は実行を並列化し、戦略に集中できるようになりました。
市場が先、開発は後
創業者が最も強く勧めるのは、本格的なコードを書く前に需要を検証することです。彼の数字では、ターゲットとなる見込み顧客20人が課題を認め、月額の継続課金に同意すれば、技術リスクは二の次になり、エンジニアリングの仕事は先に売ったものを届けることになります。より広くは、開発に時間とお金を投じる前に40~50人の潜在ユーザーと話すことを勧めています。現代のツールは開発をあまりに簡単にするため、創業者はこのステップを飛ばしたくなるのです。
この考え方では、営業は説得ではなく発見です。顧客を強引に説き伏せなければならないなら、製品が十分に良くないということです。製品が頭痛の種を消し去るなら、顧客は進んで支払います。彼は資本の規律も説きます。厳密に必要な分だけを調達し、顧客1社あたりのサービス提供コストを利益の出る水準に保ち、シリーズAのマイルストーンまでバーンレートを低く維持し、事業を築くエンジニアに大きな付与ができるよう株式プールを守ることです。需要がないまま大型ラウンドを調達すると、士気を蝕む偽の勢いが生まれると彼は警告します。Ardentについて彼が公言する野心は、少なくとも$200億でのイグジットです。
創業者がここから学べること
Ardentの歴史を貫くパターンは、事業が創業者自身がエージェントを並列で走らせる中でぶつかった問題から生まれ、すでに苦しんでいた顧客によって裏付けられたということです。ピボットはホワイトボードではなくフィードバックに従いました。主要な拠点の外にいる創業者、快適な大企業のエコシステムを離れるべきか迷っている人も含めて、いくつかの判断基準が浮かび上がります。
- 自分が繰り返し直面する技術的な失敗を問題の候補として扱う。Ardentになったデータベースの衝突は、最初は別の製品のバグとして現れた
- 開発の前に20~50人のターゲットユーザーにインタビューして先行販売を試み、最初の通話がオンボーディングに変わることを本当の需要のシグナルと見なす
- 複数の自律型コーディングエージェントを1つの共有ステージングデータベースに向けない。本番の異常を欠く小さなデータサブセットでのテストを信用しない
- 継続的に進捗を公開する。表示回数300回のベースラインが25万回の投稿につながることもあるが、投稿しなければ始まらない
- アクセラレーターや資金調達ラウンドは、成功確率を上げるか、バーンレートを低く保てるか、重要な採用のために株式を守れるかで判断する
- 失うものがないなら再応募する。うまくいったのは8回目のYC応募だった
ここでの粘り強さは盲目的な頑固さではありません。製品が足元で変わり続ける中でも、出荷し続け、耳を傾け続け、応募し続ける意志のことです。