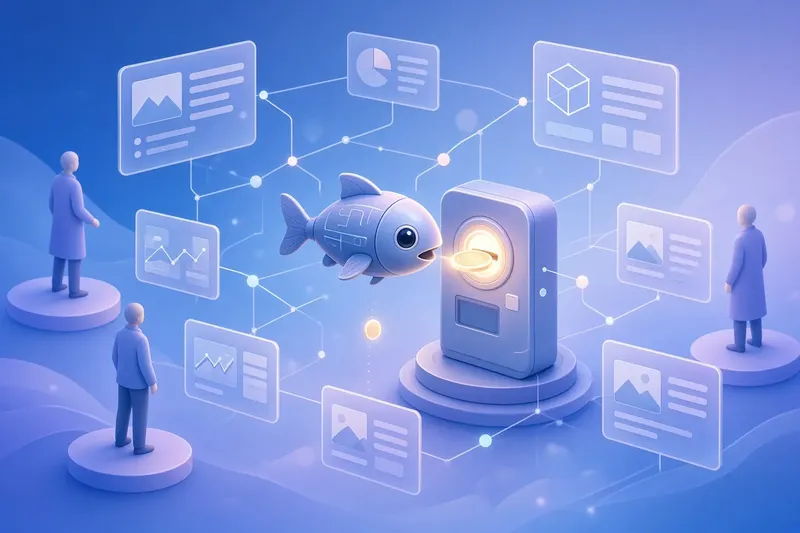
AI coding agent(코드를 스스로 작성하고 수정하는 AI)를 여러 개 동시에 돌리면 생각하지 못한 곳에서 병목이 생깁니다. 코드가 아니라 데이터베이스입니다. Y Combinator에 일곱 번 떨어지고 여덟 번째 지원에서 합격한 스타트업 Ardent는 바로 이 지점을 파고들었습니다. 운영 중인 PostgreSQL 데이터베이스의 격리된 복제본을 6초 안에 만들어, 수십에서 수백 개의 agent가 실제 데이터로 각자 코드를 검증하게 하는 인프라입니다. 이 사업은 처음부터 계획된 것이 아니라, 앞서 만든 제품이 실패하고 고객 피드백이 쌓이는 과정에서 찾아낸 pivot(사업 방향 전환)의 결과입니다.
병렬 coding agent가 공유 staging 데이터베이스에서 부딪히는 문제
Ardent의 출발점은 창업자가 앞서 만들던 'AI data engineer' 제품이었습니다. 데이터 작업을 자동으로 처리하는 agent 여러 개를 동시에 돌리자, 같은 데이터베이스 상태를 바라보는 agent들이 서로 충돌하는 schema(데이터베이스 구조) 변경을 시도했고, 해결할 수 없는 충돌과 데이터 손상이 반복됐습니다. 격리된 환경이 없으니 migration script(데이터베이스 구조를 바꾸는 스크립트)나 schema 변경을 production(실제 서비스 환경)에 합치기 전에 제대로 검증할 방법이 없었습니다. 이런 충돌은 결국 서비스 장애로 이어지고 복구 비용도 큽니다.
전통적인 해법인 중앙 staging 데이터베이스(배포 전에 시험하는 공용 환경)는 이 문제를 풀지 못합니다. Ardent 창업자가 정리한 한계는 다음과 같습니다.
- 데이터를 내보내고 다시 넣는 데 1TB당 6~8시간이 걸립니다.
- 그래서 매일 밤 동기화하는 작업에 의존하게 되는데, 동기화가 한 번 실패하면 엔지니어링 팀 전체가 복구를 기다리며 하루를 잃습니다.
- 여러 agent를 하나의 staging에 붙이면 쓰기 작업이 겹쳐, 첫 번째 agent가 두 번째 agent가 의존하는 상태를 망가뜨립니다.
- 데이터 일부만 뽑아 쓰는 우회책은 production 데이터에만 있는 edge case(드물게 나타나는 예외 사례)를 빠뜨립니다.
이 때문에 Ardent 창업자는 staging 데이터베이스를 안전장치가 아니라 장애를 만드는 구조로 봅니다. agent가 데이터베이스를 망가뜨리거나 지우는 일은 '일어날지'가 아니라 '언제 일어날지'의 문제라는 것입니다. 실제로 자율 agent가 폭주해 운영 데이터베이스를 통째로 지웠다는 사용자 사례가 X에서 화제가 되기도 했고, 이런 이야기가 투자자들의 인식을 바꾸는 계기가 됐습니다.
6초 미만 복제를 가능하게 한 copy-on-write
GitHub가 코드 파일의 branch와 clone을 쉽게 만든 것처럼, Ardent는 같은 모델을 살아 있는 PostgreSQL 데이터에 적용합니다. 다만 GitHub가 다루는 소스 코드는 작은 파일이라 복제가 계산상 사소한 반면, 데이터베이스는 수 TB에서 수 PB의 상태를 품고 있어 디스크 IOPS(초당 입출력 횟수)와 네트워크 대역폭의 물리적 한계에 묶입니다. 파일을 그대로 복사하는 방식은 통하지 않습니다.
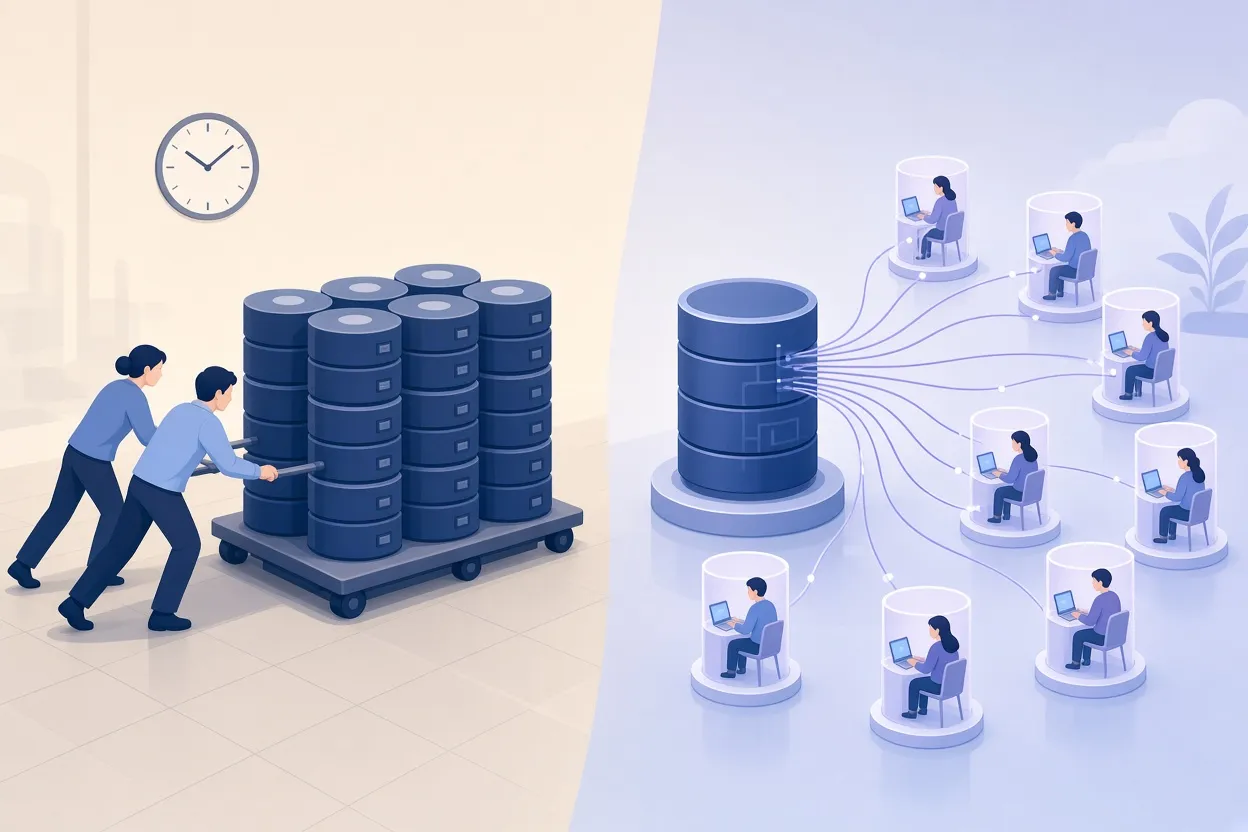
▲ copy-on-write 복제 방식
Ardent는 copy-on-write(원본을 공유하다가 변경이 생길 때만 그 부분을 복사하는 방식) 구조와 가벼운 포인터 참조로 물리적 복사를 없앴습니다. agent나 엔지니어가 복제본을 요청하면 새 컴퓨팅 인스턴스를 띄우고, 읽기 요청을 원본 데이터로 향하게 하는 포인터를 생성합니다. 인덱스 경로와 구조 참조는 메타데이터가 처리하므로 PB 규모의 데이터베이스도 6초 안에 복제본이 만들어집니다. 수평 확장이 가능해 수백, 수천, 수만 개의 복제본을 동시에 운영할 수 있습니다.
이 점이 일반 compute sandbox(코드를 격리해 실행하는 환경)와 다른 지점입니다. 데이터베이스 테이블 전체를 메모리에 올리려 하면 시스템이 곧바로 멈추기 때문에, 데이터베이스 sandbox는 compute sandbox와 같은 방식으로 만들 수 없습니다. 자금 조달 과정에서도 이 차이가 벽이 됐습니다. 인프라를 직접 다뤄 보지 않은 투자자 다수는 데이터베이스 sandbox를 compute sandbox와 같은 것으로 여겼고, 가치를 바로 알아본 쪽은 staging 손상과 깨진 migration으로 고생해 본 전직 기술 운영자들이었습니다. 창업자는 데이터베이스 신뢰성이 자율 소프트웨어 엔지니어링의 전제라는 점을 이해하는 투자자를 골라내는 일이 조달의 핵심이었다고 돌아봅니다.
실패한 제품과 고객 피드백이 이끈 pivot
Ardent 이전의 과정은 실패의 연속이었습니다. 창업자는 2023년 한 해 동안 네 개의 소프트웨어 제품을 만들었지만 모두 실패했습니다. 당시에는 순수한 소프트웨어 엔지니어처럼 몇 달씩 복잡한 prototype을 만들었고, 다섯 명이 써 보고는 곧바로 떠났습니다. 그 경험으로 '아무도 원하지 않는 것을 만들고 있다'는 느낌이 어떤 것인지 분명히 알게 됐다고 합니다.
다음 시도는 순서를 바꿨습니다. 머신러닝 모델 학습 경험에서 모델 성능이 상류의 데이터 품질에 묶인다는 점을 알고 있었고, 이것이 정말 병목인지 확인하려고 머신러닝 엔지니어와 데이터 엔지니어 50~60명을 인터뷰했습니다. 그 결과로 AI data engineer 제품을 구상했고, 최소한의 prototype과 landing page로 먼저 판매를 시도했습니다. 이 제품으로 혼자서 $220만을 조달하고 초기 연간 계약도 맺었습니다.
그런데 12월에 이르러 진짜 병목이 드러났습니다. AI data engineer가 내놓은 결과물을 검증하기가 어렵다는 점이었고, 이는 특정 고객이 아니라 업계 전체의 문제였습니다. 이 인식이 Y Combinator 입소 전의 pivot으로 이어졌습니다. 앞서 본 agent 간 데이터베이스 충돌이 바로 검증 문제의 핵심이었던 셈입니다.
Y Combinator에 들어갈 때 MVP(핵심 기능만 담은 최소 제품)는 작동은 하지만 버그가 많은 상태였습니다. 초기 고객 세 곳이 월 $100씩 내면서 매일 피드백을 주고, 실패한 branch ID와 bug report를 직접 보내 디버깅을 도왔습니다. 제품이 고객에게 급하고 가치가 큰 문제를 풀고 있었기 때문에 가능한 일이었다고 창업자는 설명합니다.
이후 성장은 X와 LinkedIn에 꾸준히 글을 올리는 organic(광고 없는 자연 유입) 방식으로 이뤄졌습니다. 개발자들은 agent를 배포하면서 데이터베이스 손상을 이미 겪은 상태라, Ardent를 발견했을 때 문제를 따로 설명할 필요가 없었습니다. onboarding(처음 도입해 설정하는 과정)은 인증, 데이터베이스 연결, branch 생성, 팀원 초대로 이어지는 CLI 명령 네 개로 줄였습니다. 한 고객은 이슈 관리 도구 Linear와 클라우드의 coding agent에 Ardent를 연결해, 밀린 작업을 agent에 맡기고 차 안에서 노트북을 덮은 뒤 agent들이 실제 데이터 복제본으로 검증을 끝내게 했습니다.
거절과 실패를 버틴 과정
창업자는 시애틀에서 석사를 마치고 대기업 제안을 거절했습니다. 시애틀의 기술 생태계는 성숙한 대기업 중심이라 높은 연봉과 내 집, 일과 삶의 균형을 지향하는 분위기가 강했고, 맨땅에서 시작하는 창업자는 고립감을 느끼기 쉬웠다고 합니다. 그래서 투자 자산과 저축을 모두 정리해 $10,000을 마련하고, 샌프란시스코행 편도 항공권을 샀습니다. 목표도 작지 않습니다. 창업자는 최소 $200억 규모의 exit(매각이나 상장으로 투자금을 회수하는 일)을 목표로 삼는다고 밝힙니다.
▲ 소파 생활과 반복된 지원의 시간
물러설 길을 없애려고 그 항공권 사진을 X에 올렸는데, 그전까지 가장 많이 본 게시물이 300회 정도였고 '좋아요' 다섯 개쯤을 예상했던 글이 두 시간 만에 유명 계정들의 인용을 타며 하룻밤 사이 25만 회 조회를 기록했습니다. 투자자, 협업 제안, 현지 창업자들의 메시지가 쏟아졌고, 3개월 뒤로 잡아 둔 출발을 그 주말로 앞당겼습니다. 샌프란시스코에서는 거의 1년을 지인의 소파에서 자며 사업에 매달렸습니다. 다만 소셜 미디어의 영향력이 곧바로 좋은 채용으로 이어지지는 않았고, 누구를 뽑고 누구를 뽑지 말아야 하는지는 혼자서 비싸게 배워야 했다고 합니다.
Y Combinator는 일곱 번 지원해 일곱 번 떨어졌습니다. 여덟 번째는 YC 출신 친구들이 다시 내서 손해 볼 것이 없다고 강하게 권해 지원했고, 제출 4일 만에 인터뷰 초청을 받아 직접 찾아갔습니다. 합격 메일은 스팸함에 들어가 하루 동안 애를 태우다가 후속 전화로 확인했습니다. 입소 뒤에는 브랜드 신뢰, 고객 소개, 그리고 데이터 엔지니어링 경력 20년의 CTO 같은 인재 접근이 가장 큰 지렛대가 됐습니다. CTO에게 기술 책임을 넘기면서 창업자는 전략에 집중하고 실행을 병렬로 나눌 수 있게 됐습니다.
자금 운용은 보수적입니다. 꼭 필요한 만큼만 조달하고, 고객 한 곳을 서비스하는 비용에서 손해를 보지 않는 margin profitability(고객당 원가 수준의 흑자)를 확보했습니다. burn rate(월 자금 소진 속도)를 낮게 유지하면 무한정 투자금을 찾지 않고도 Series A 목표를 잡을 수 있고, 과도한 조달로 희석되지 않은 지분을 핵심 직원에게 넉넉히 줄 수 있다는 판단입니다.
한국 창업자가 참고할 판단 기준
Ardent의 과정에서 뽑을 수 있는 기준을 정리하면 다음과 같습니다.
| 판단 기준 | 내용 |
|---|---|
| 시장 먼저, 개발은 나중 | landing page나 최소 prototype으로 먼저 팔고, 대상 고객 20명이 문제를 인정하고 월 구독료를 내겠다고 하면 기술 위험은 부차적 |
| 인터뷰 규모 | 코드를 쓰기 전에 잠재 고객 40~50명과 대화해 수요 확인 |
| 판매는 설득이 아니라 발견 | 억지로 설득해야 팔린다면 제품이 충분하지 않다는 신호, 수요가 있으면 첫 통화가 곧 onboarding |
| 공개 기록 | 일상적인 개발 과정과 솔직한 회고가 다듬어진 출시 발표보다 반응이 좋고, 꾸준히 올리면 10만~20만 조회를 내는 서사를 익히게 됨 |
| 채널 운영 | X와 LinkedIn에 같은 글을 조금만 손봐 교차 게시, 플랫폼별로 다른 인격을 만들면 소통이 부자연스럽고 지침 |
| 자금 조달 | 검증된 수요 없이 큰 투자금을 받으면 거짓 추진력이 생겨 팀 사기 유지가 어려움 |
| accelerator 선택 | 네트워크, 커뮤니티, 자본이 성공 확률을 실제로 높이는지로만 판단 |
요약하면 이렇습니다. 고객이 돈을 내겠다고 확인하기 전에는 코드를 길게 쓰지 않고, 판매를 문제 발견의 과정으로 삼으며, 지분을 아껴 초기 직원에게 보상합니다. 그리고 버그 많은 MVP를 고쳐 가든 accelerator에 여덟 번 지원하든, 버티는 일 자체가 창업의 조건으로 보입니다.
독자가 지금 할 수 있는 일은 세 가지입니다. coding agent를 여러 개 돌리는 팀이라면 공유 staging 데이터베이스에 agent를 붙이고 있지 않은지 점검하고, 일부 데이터만으로 migration을 시험하는 관행이 있는지 확인합니다. 제품을 구상 중이라면 개발 전에 잠재 고객 20~50명과 대화해 월 구독 의사를 받는 일부터 시작합니다. 그리고 지원이나 투자 심사가 진행 중이라면 스팸함도 챙겨 봅니다. 사소해 보이지만 Ardent 창업자가 하루를 애태운 바로 그 대목입니다.