今週は画像、言語、音声の新しいモデルが一度に登場しました。実際に試してみると、ランキングの順位と、本当に使う価値のあるモデルは必ずしも一致しないようです。特に実用的な新顔の一つとみられるのが、ボックスで囲んだ部分だけを変更する画像ツールのKrea 3です。音声では、xAIのGrok Voice 3.0の応答が非常に速く、試しに作ったサポートエージェントとのやり取りは本物の会話に近い感覚でした。一方、MetaのMuse Wonderは、モデルの比較に使う標準テストであるベンチマークのうち、コーディング分野で最高スコアを記録しました。ところが、1回のプロンプトで作ったゲームは、Claude Opus 5.5やGemini 4 Argonが作ったものより粗い出来でした。
画像モデルの競争軸は編集の精度と速度へ
主要モデルのテキストからの画像生成の基本品質は、すでにかなり成熟したように見えます。そのため競争の焦点は二つの問いに移っています。画像の一部をどれだけ正確に変えられるか、そして自分のハードウェアでモデルを動かせるかです。
選んだ部分だけを編集するKrea 3
Webで公開ベータ版が使えるKrea 3は、通常のテキストからの画像生成ではGPT Image 2.5やNano Bananaなどのモデルと同程度の性能です。真の強みは、バウンディングボックスを使った複数回の編集にあります。ある範囲をボックスで囲み、その範囲だけに適用する指示を入力すると、画像のほかの部分はそのまま残ります。
人物の顔とスマートフォンが写ったサムネイル画像で試した流れは次のとおりです。
- スマートフォンの画面と人物の目をボックスで囲み、スマートフォンの背景を青に、目を赤く充血させるよう指示すると、約10秒で3つのバリエーションが返ってきました。
- 2回目の編集では、スマートフォンに表示されたモデル名をClaude Haiku 5.5からGemini 4 Argonに変え、AnthropicのロゴをGoogleのロゴに差し替えました。
- 3回目の編集では、見出しを同じ黄色の装飾フォントのまま「NEW MODEL!」に書き換え、帽子の刺しゅうのエンブレムを野球のロゴに変えました。
編集した部分は、刺しゅうの縫い目やフォントの太さまで周囲になじんでいました。サムネイルやデザイン素材を頻繁に手直しする人にとって、Krea 3はチャット形式の画像エディターよりきれいな結果を出せるようです。周囲の細部を崩さないようボックスは対象にぴったり合わせて描き、それぞれにプロンプトを付けた複数のボックスを用意してから送信すれば、一度にまとめて変更できます。
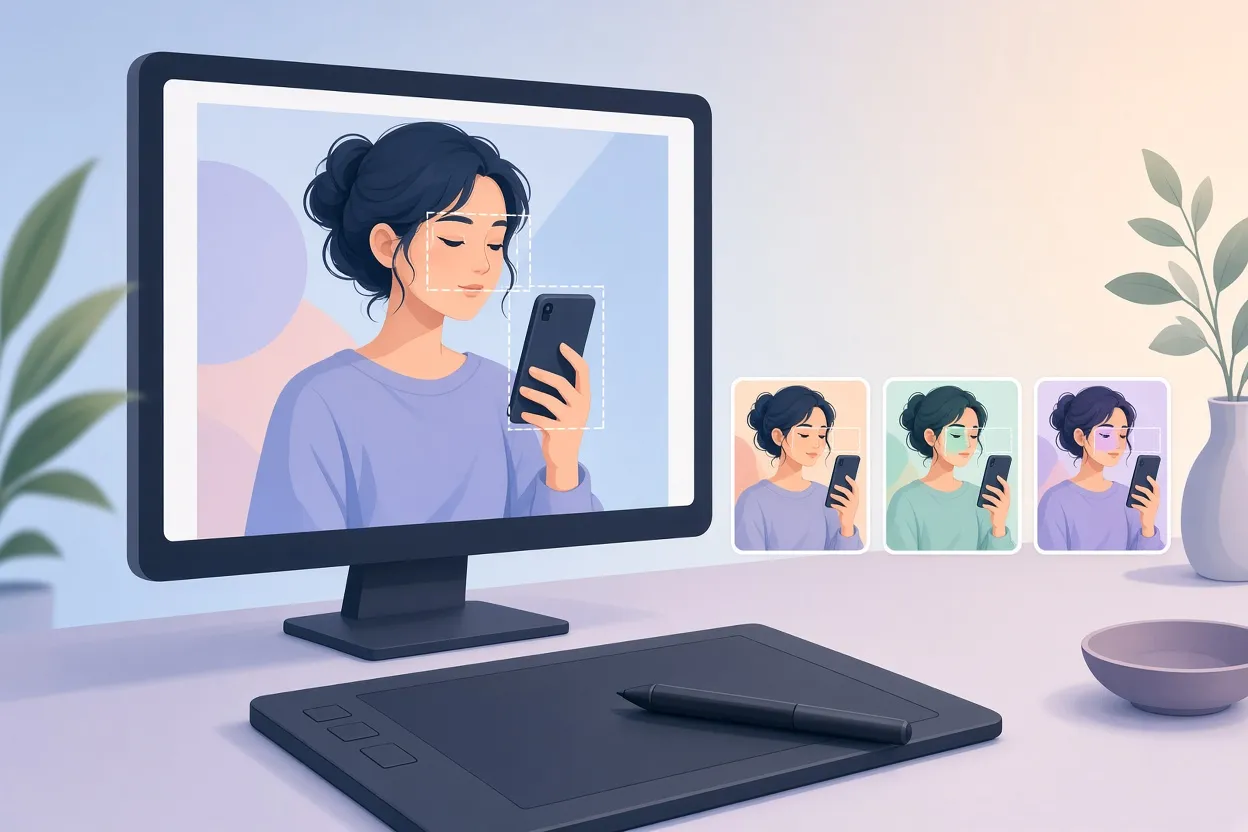
▲ 選択した範囲だけを変える部分編集
デスクトップのGPUで動くオープンウェイトの画像モデル
学習済みのファイルを誰でもダウンロードして実行できる、オープンウェイトの新しい画像モデルも2つ登場しました。
Black Forest Labsが公開したFLUX 3 Image Kleinは、パラメーター数56億8,000万のモデルで、テキストからの画像生成、複数の参照画像を使った生成、画像編集に対応します。重みはHugging Faceで公開されていてファインチューニング、つまり特定の作業に合わせた追加の学習ができ、遅延を抑えるよう調整した蒸留版もあります。
| ハードウェア | テキストからの画像生成 | 画像編集 |
|---|---|---|
| NVIDIA DGX Spark、約$4,000クラス | 約7.3秒 | 16.2秒 |
| NVIDIA GeForce RTX 4070、一般向けGPU | 8.9秒 | 記載なし |
一般向けのカードとDGX Sparkの差は1枚あたり2秒未満です。多くの人にとっては、普通のデスクトップで高解像度の生成や編集を動かせることのほうが重要でしょう。
Alibabaは、Qwen-Image-2.1を高速化したチェックポイントであるQwen-Image-2.1-Turboを追加しました。ランダムなノイズから完成した画像へと仕上げていく処理であるノイズ除去のステップをわずか8回で済ませ、高解像度の画像を生成・編集します。細部の描写は多少犠牲になりますが、実務での処理量は増え、サンプルには原子モデルや反応性の表を盛り込んだ情報量の多い化学の学習用ポスターもあります。
どちらもHugging Faceのコミュニティ向けSpacesで、何もダウンロードせずに無料で試せます。ただし共有のSpacesは、アクセスが集中すると遅くなったり、リクエストが順番待ちになったりすることがあります。
応答速度を売りにするGrok Voice 3.0
xAIは、音声を聞き取ってそのまま音声で答えるリアルタイムの音声対音声モデル、Grok Voice 3.0をリリースしました。xAIは遅延と声の自然さでベンチマークの最高記録を達成したとしており、音声ベンチマークの総合スコアは86.9です。
音声エージェントとは、目標に向けて自律的に作業を進めるAIプログラムです。xAIの音声エージェント用サンドボックスでは、システム指示、あいさつ、応答ルール、割り込みへの対応、プリセットの声を設定できます。そこでWebサイト向けに作ったカスタマーサポートエージェントはほぼ即座に応答し、一般的な音声アシスタントよりはるかに速く感じられ、途中で話を遮られてもスムーズに対応しました。尋ねると、ツールのおすすめやニュース記事もサイトから直接引き出しました。
音声エージェントを作るなら、承認済みの内容だけから答えるよう指示に禁止事項を明記し、通話相手の話に声をかぶせないよう、無音のタイムアウトと割り込みのしきい値を調整しましょう。
ElevenLabsもElevenCreativeにInstant Soundtracksを追加しました。動画の映像の手がかり、テンポ、場面転換を読み取り、手作業の編集なしで、合ったBGMとタイミングを合わせた効果音を付けます。
▲ 遅延のないリアルタイム音声サポート
言語モデル、ランキングと実際の出力は食い違う
Gemini 4 Argonの導入価格は11月まで
Googleは、9月30日に最初に発表したGemini 4 Argonを、開発者向けAPIとGoogle AI Studio、そしてAI UltraとProプランの加入者向けに正式に公開しました。OpenAIのGPT-6 AstraやAnthropicのClaude Opus 5.5と真っ向から競うモデルです。APIの導入価格は入力100万トークンあたり$2.00、出力100万トークンあたり$10.00です。トークンとは、モデルが読み書きするテキストの小さな単位です。この価格は11月末まで適用され、その後はほぼ倍になります。Artificial Analysis Intelligence IndexでのArgonのスコアは53で、Claude Opus 5.5より5ポイント低いものの、タスクあたりのコストは大幅に低くなっています。
人物の似顔絵をSVGコードで描かせ、AIの審査員団が採点するテストでは、Argonは約4分、$0.34で7.6点を獲得し、GPT-6.1 Solに次ぐ2位に入りました。SVGは、図形と線で画像を記述する形式です。1回のプロンプトで3Dアクションゲームを作らせると、バニーホップ移動やアップグレードカードを備えた三人称視点のアリーナゲームが実際に動きましたが、グラフィックは初歩的でした。Googleのエンジニアは3Dプリント用のCADモデル生成をArgonの強みに挙げており、テストでもそれが裏付けられました。顔写真1枚からArgonが作ったSTLファイルで印刷した胸像は、正面からはよく似ていましたが、横顔はやや平板な仕上がりでした。
数字の上では首位のMuse Wonder
MetaのMuse Wonderは、コーディングのベンチマークDeepSWEでMuse Wonder Fullが79.0%、標準のMuse Wonderが78.8%を記録し、Claude Opus 5.5の74.2%とGPT-6 Astraの74.1%を上回って首位に立ちました。Artificial Analysis Intelligence Indexでも、Gemini 4 Argon、GPT-6 Astra、Claude Fable 5.1を上回り、Claude Sonnet 5.5と並びます。価格は入力100万トークンあたり$4.00、出力100万トークンあたり$20.00で、Claude Opus 5.5と同程度です。タスクあたりのコストはArtificial Analysisが評価したモデルの中で5番目に高いものの、Claude Opus 5.5よりはやや低くなっています。
実際に使うと、それほど圧倒的ではありませんでした。同じ似顔絵テストでは6.6点で14位でした。同じ3Dゲームのプロンプトでは、操作、当たり判定、ジャンプ、カメラの移動、押し寄せる敵の波まで動く形で作りましたが、Claude Opus 5.5やGemini 4 Argonが作ったものと比べると、見た目は単純で動きもぎこちないものでした。ベンチマークで首位でも、完成度の高い出力が保証されるわけではありません。
| 項目 | Gemini 4 Argon | Muse Wonder |
|---|---|---|
| 100万トークンあたりのAPI価格 | 入力$2.00、出力$10.00、11月末まで | 入力$4.00、出力$20.00 |
| 似顔絵のSVGテスト | 7.6点、2位、$0.34 | 6.6点、14位、$0.3422 |
| 1回のプロンプトで作る3Dゲーム | 動作する、グラフィックは初歩的 | 動作する、単純でぎこちない |
規模、速度、価格で分かれるその他の新モデル
- Muse Spark Open(Meta):Metaのかつての非公開の最上位モデルMuse Sparkを、Muse Wonderの登場後にオープンウェイトで公開したものです。Metaは、米国でこれまでに公開されたオープンウェイトモデルの中で最も高性能だとしています。総パラメーター数は8,160億で、トークンごとに420億が使われ、コンテキストウィンドウ、つまりモデルが一度に考慮できる入力の量は100万トークンです。AppleのMLXフレームワークで最適化され、2台のM5 Ultra Mac Studioでローカルに動き、一般的なタスクではMistral Large 4とQwen 3.8を上回りますが、DeepSWEではKimi K3に及びません。$1万近いMac Studioのハードウェアを一般向けの環境と呼ぶのは難しそうで、似顔絵テストのスコアも3.9にとどまりました。
- Nemotron 3.5 Super VL(NVIDIA):パラメーター数1,200億のオープンウェイトの視覚言語モデルです。Artificial Analysisの指数でのスコアは26で、DeepSeek、Qwen 3.8、GLM 5.3に及びませんが、より賢いオープンウェイトのライバルと比べて毎秒の出力トークン数は約5倍です。そのため、深い推論よりも低遅延が重要なエージェントのワークフローに最も向いているように見えます。
- MAI-Base 2(Microsoft):総パラメーター数2兆8,000億のうち800億がアクティブな基盤モデルで、初期の事前学習を終えたところです。Microsoftは、コーディングと推論に関する素の事前学習評価で既存のオープンウェイトモデルを上回るとしていますが、事後学習を経ていないため、一般公開と第三者による検証はまだこれからです。
- Ultramarine 1 Flash:あるAI企業が公開した、専門的な知識労働向けのオープンモデルで、価格は入力100万トークンあたり$0.15、出力100万トークンあたり$0.50です。同社は金融、法務、コンサルティングの業務で、Claude Fable 5.1並みの性能をFableクラスのモデルの約60分の1のコストで実現すると主張していますが、まだOpenRouterで提供されていないため、外部による検証は済んでいません。
OpenAIの「28 Days of Shipping」は静かな週に
OpenAIが10月4日に発表した28日間のリリースイベント「28 Days of Shipping」は、2週目に入って目に見えて静かになりました。
- 5日目:CodexのComposer Predictionsが、Proユーザー向けにプロジェクトの文脈から次のプロンプトを提案します。
- 7日目:CodexでのGPT-6.1 Solの標準のコンテキストウィンドウが27万2,000トークンから50万トークンへ、約84%拡大しました。
- 9日目:ChatGPTとCodexのデスクトップアプリのディスク使用量が約60%減りました。
- 11日目:計算資源の追加で容量不足のエラーが減り、リクエストはユーザーの操作を止めずに、バックグラウンドで自動的に再試行されるようになりました。
- 6日目、8日目、10日目:新機能はなく、利用枠のリセットのみでした。
9日目と11日目については、新機能ではなく遅れていたバグ修正やサーバー保守にすぎないとする利用者が多く、その批判にはもっともな面があるようです。Codexを使っているなら、デスクトップアプリを更新し、拡大したコンテキストウィンドウにリポジトリ全体を読み込ませてみましょう。
一つの仕事を安くこなす判断モデル
文章を書く生成モデルと違い、判断モデルは入力を評価して、選択肢か較正された確率を返します。Qwen2.5-9Bをファインチューニングして作られたMicrosoft-Decision-1は、はい・いいえで答える質問、多肢選択、数値による評価、評価基準に基づくAIの回答やエージェントの行動の採点に対応します。別のAI企業は、自社のNimble-v4-maxが判断のベンチマークで85.0%の正答率に達し、競合モデルより誤りが43%少ないとしています。Microsoft、OpenAIなどの選択肢はほぼ置き換えがきくように見えるため、本当の利点はコストにあります。リクエストの振り分け、コンテンツのモデレーション、評価基準による採点では、判断モデルが大規模言語モデルの代わりを務め、計算コストと応答時間を削減できます。
今週の新モデルをどう使うか
今回のテストでは、ベンチマークのスコアよりも、編集の制御性、応答速度、運用コストが、役に立つツールとそうでないものを分けたように見えます。コーディングで首位のモデルが完成度の低いゲームを作る一方、知能スコアが控えめなモデルは速度で活躍の場を見いだしました。作業に応じて、次のように使い分けられます。
- 画像を頻繁に編集するなら、Krea 3の公開ベータ版で、ボックスを対象にぴったり合わせ、指示をまとめて送ってみましょう。
- 自分のPCで画像を生成したいなら、ダウンロードする前にHugging Face SpacesでFLUX 3 Image KleinかQwen-Image-2.1-Turboを試しましょう。
- APIのコストが気になるなら、導入価格が11月末に終わる前に、自分の作業でGemini 4 Argonを評価しましょう。
- エージェントに速い応答が必要なら、Nemotron 3.5 Super VLのような高速モデルや、振り分けと採点には判断モデルを検討しましょう。
- 音声エージェントを作るなら、明確な禁止事項で回答の範囲を制限し、無音と割り込みの設定を調整しましょう。
- モデルを比べるときは、総合ランキングだけでなく、コーディングならDeepSWE、法務・金融の業務ならDiligenceBenchのような分野別のベンチマークを確認しましょう。