Gemini 4 Argonが誰でも使えるようになりました。GoogleはこのモデルをGeminiアプリとGoogle AI Studioで公開し、Google CloudのGemini APIとAntigravityでも提供を始めました。Googleが最初にベンチマーク結果を発表してから約2週間後の一般公開で、公開前には10万人を超えるGoogle社員がこのモデルを使っていました。目立つ変化は二つあります。Argonは1回の生成ステップで最大100万トークン(モデルが読み書きする文章の小さな単位)を出力でき、AIが生成した文章にありがちな画一的な語り口をなくすよう、文章の書きぶりも調整し直されました。GoogleはArgonがすでに次世代のGeminiモデルづくりにも役立っているとしています。何が変わったのか、まずどこで試す価値があるのか、そして出力をどう確かめればよいのかをまとめます。
ベンチマークから公開までの2週間のテスト
Googleによると、ベンチマーク発表後の2週間を使って、Argonをさまざまな角度からテストしました。
- セキュリティ: GoogleはWizをはじめとするサイバーセキュリティのパートナーと協力し、Argonを使って重要なシステムの脆弱性を見つけ、修正しました。
- 段階的な展開: 一部の企業顧客に先行して提供し、本番環境でのフィードバックと現実のエッジケースを集めました。
- 専門分野での評価: Google DeepMindの研究者が、量子コンピューティング、ロボティクス、先端科学といった分野でモデルをテストしました。
- 政府による審査: Googleは安全性評価のため、モデルを米国政府に提出しました。
- 社内テスト: 10万人を超える社員がArgonを使いました。Googleの歴史でも最大級の公開前社内テストです。
Googleは安全対策を2層構造で説明しています。モデルの重みそのものに組み込んだ監視と、実行時のモデルの周囲に置くガードレール、つまりフィルタリングの仕組みです。
社内での利用はエンジニアリングにとどまらず、Google Cloudの営業などのチームにも広がりました。Googleはこれを、Argonがコードだけでなく一般的な知識業務もこなせる証拠として挙げています。以前のチェックポイント(学習の途中で保存したモデルのバージョン)に厳しい評価を下していた社内テスターの反応も、大きく好転しました。
1回のステップで100万トークンを出力
Googleは業界で初めて100万トークンの入力ウィンドウを提供しました。Argonではこれに加えて、Googleが業界トップクラスとうたう、1回の生成ステップで100万トークンの出力に対応しました。前世代の出力上限は64kトークンで、開発チームによると、この上限が難しい問題でのモデルの推論を妨げていました。
| 従来のモデル | Gemini 4 Argon | |
|---|---|---|
| 1回の生成の出力上限 | 64kトークン | 100万トークン |
| 100万トークンの生成 | Gemini 1.5 Flashのように複数のステップをつなげた場合のみ可能 | 1回の推論ステップで可能 |
この長い出力ウィンドウが想定するのは、難しい数学や答えの決まっていない科学の問いです。こうした問題では、モデルが答える前に段階を追って考える思考の連鎖を長く続ける必要があります。使うには、開発者がモデルの考える深さを決める設定である推論強度(reasoning effort)を「high」にします。すると問題が深い計算を必要とするとき、Argonは推論を100万トークンの上限まで広げます。
Google共同創業者のセルゲイ・ブリン氏は、この数字を人間の時間に置き換えて説明します。同氏の見積もりでは、100万トークンはおよそ50万秒の集中した思考に相当します。休みなく考え続ければ約1週間、通常の勤務時間なら約1か月分の思考を、一つの問いへの応答に注ぎ込む計算です。
AIスロップを減らした文章
Google Labsのバイスプレジデント、ジョシュ・ウッドワード氏によると、チームはGeminiアプリでのArgonの文章に大きな力を注ぎました。狙いはAIスロップ、つまり機械が量産する平板で型どおりの文章です。山のような箇条書き、ありきたりな埋め草、「正直に言うと」のような決まり文句のつなぎ言葉がその典型です。プロの書き手がモデルの出力に注釈を付け、学習用の質の高い参照データを作りました。Googleによれば、その結果、文章はより引き締まって個性的になり、大規模言語モデルにありがちな画一的な語り口がなくなりました。
ウッドワード氏自身の使い方は、その一つの例です。同氏は歩いているときや通勤中に音声メモを録り、Argonに厳しいコピーエディターの役を任せます。最も弱い論点を三つ挙げ、見落としを指摘し、読み手が混乱しそうな考えに印を付けてもらうのです。同氏はモデルを優れた編集者であり思考のパートナーだと見ていますが、独創的なアイデアには人間の判断が欠かせないと話します。
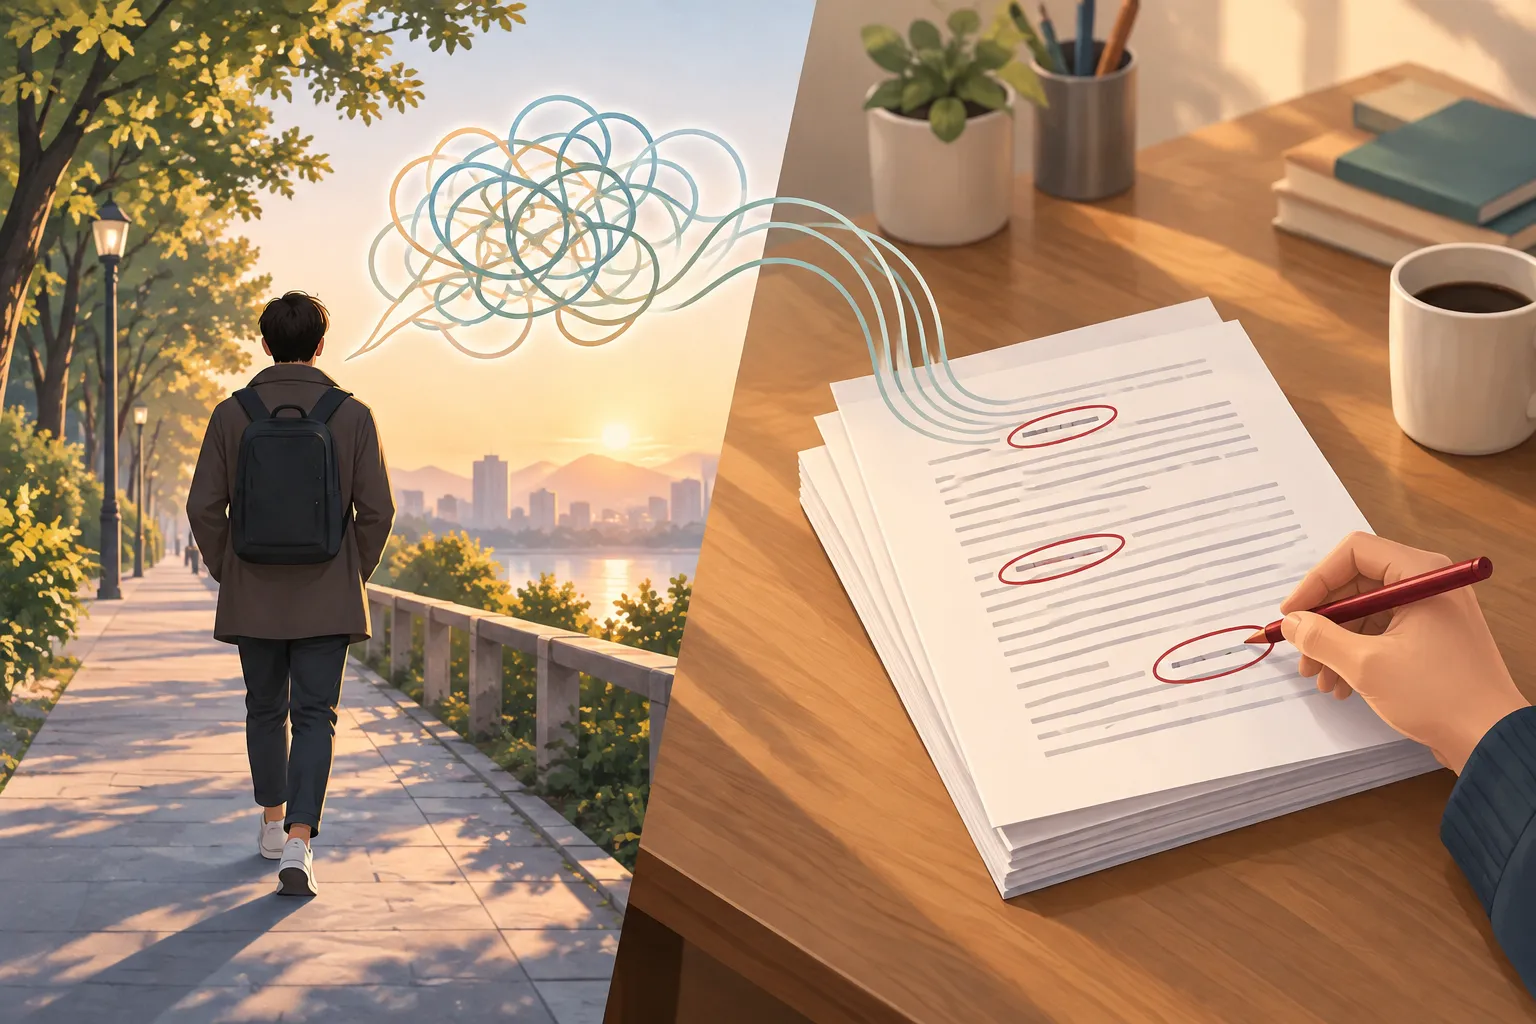
▲ 音声メモの文章化と推敲
Google DeepMindのあるプロダクト責任者は、手首の負担を和らげるために似た方法を使い、台本のないとりとめのない考えをそのままモデルに話しかけています。以前のモデルはこうした入力を、詰め込みすぎてぎこちない要約に変えがちでしたが、Argonはすっきり整理された文書を返します。それでも標準の文体が型にはまっていると感じるなら、箇条書きや埋め草の言い回し、決まりきった構成を避けるようモデルに直接指示できます。
AIはどのようにGeminiづくりを支えているのか
Geminiのポストトレーニングを率いる研究担当バイスプレジデントは、ArgonをAIエージェントが学習パイプライン全体で積極的な役割を果たした初の主要リリースだと位置づけています。ポストトレーニングはモデルの最初の学習に続く仕上げの段階で、エージェントは自らタスクをこなすAIシステムです。Argonの場合、エージェントは次のことを担いました。
- 最大規模の学習ランを継続的に監視し、システムの設定ミスを検出
- 報酬シグナルのスケールが適切かを確認
- バグを見つけ、コードの修正案を提示
- ポストトレーニングの前と最中に、データセットの重複レコードや不整合を点検
研究者がリソースを求める方法も変わりました。ポストトレーニングのチームは以前、GPUやTPUのチップを500個や1,000個の単位で要求していました。今ではArgonの処理能力をQPS、つまり1秒あたりのクエリ数で、5、10、15といった水準で求めます。モデル自体を使って次のバージョンの学習データを生成しているからです。ブリン氏はさらに、Argonが自らの学習データの誤りを見つけ、数学の定理の欠陥のある証明を指摘し、正しい反例を示したと付け加えます。
開発のペースは速いです。Google DeepMindは3〜4週間ごとに学習を繰り返し、2〜3週間ごとに候補のチェックポイントを評価しています。Argon自体も、広く展開する前に3〜4週間の社内ポストトレーニングテストを経ました。ブリン氏はFlash 3.6、3.7、3.8が立て続けに登場したことを挙げ、Googleは今や「RSIのトレッドミル」に乗っていると言います。RSIは再帰的自己改善の略で、モデルが研究者を助けて自らの後継を設計するループを指します。社内チームは通常、公開モデルの数世代先を手がけており、ブリン氏とポストトレーニング責任者はArgonの公開前から、すでにその先の試作モデルをテストしていました。
ブリン氏は二つの原動力を挙げます。リリースを速めるという意図的な決定と、現行モデルを使って次のモデルを立ち上げるやり方です。さらに、世代間の飛躍には基礎研究のブレークスルーも含まれており、それは求めに応じて予定どおりに生み出せるものではないと付け加えます。同氏はこのペースが今後も加速し続けると見ています。これはGoogle共同創業者による予測であり、当たるかどうかは今後のいくつかのリリースで明らかになるでしょう。
Argonが社内ですでにこなしたこと
公開前にGoogleが社内のチームから活用事例を募ったところ、Argonは幅広く使われていました。下の事例のうち二つは、ユーザーがモデルに与える平易な指示であるプロンプトだけから始まったものです。
| チームやプロジェクト | Argonがしたこと |
|---|---|
| Chromium | ブラウザー開発と複雑なコード作業を支援 |
| Gemma | 学習済みの重みが公開されているGoogleのオープンウェイトモデル群Gemmaで、ベンチマーク上の最適化を推進 |
| レガシー移行 | Antigravityチームによる、外部顧客のFortranコードのRustへの移行を支援 |
| データセンターゲーム | 故障したGPUの交換などを含む、データセンター運営のシミュレーションゲームをプロンプトだけで構築 |
| 読み方学習アプリ | チームメンバーの幼い息子のために幼児の学習理論を調べ、学習の到達目標を設定し、コードを書いてフロントエンドを公開 |
| Minecraft風のゲーム | 洞窟での採掘と画面上のステータス表示を備えたゲームを、2回のプロンプトで作成 |
Fortranは何十年も前の言語ですが、世界のレガシーインフラの多くは今もこの言語で動いています。だからこそ、そのコードをRustのような現代の言語に移す作業には今も価値があります。
エンジニアが何か月も付き合ってきたハードウェア障害
最も印象的な事例はハードウェアにまつわるものです。Googleの最大規模の学習ランで、マシンが破損した状態に陥ることが続いていました。エンジニアは何か月も原因を探し、しぶしぶその障害と付き合うようになっていました。あるエンジニアが診断の問題をArgonに渡したところ、モデルは物理的なハードウェアそのものの欠陥を指摘しました。
ハードウェアチームは当初懐疑的で、その分析をAIスロップだと退けました。エンジニアたちがハードウェアチームと膝を突き合わせ、部品ベンダーにも問い合わせた結果、原因が確認されました。広帯域メモリー(HBM)の、表に出ないデータ破損です。メモリーのエラーを捕らえるための仕組みである誤り訂正符号(ECC)は、これを見逃していました。そのためモデルの診断が決め手となり、Googleは保有するマシン全体から問題のあるマシンを見つけて隔離できました。
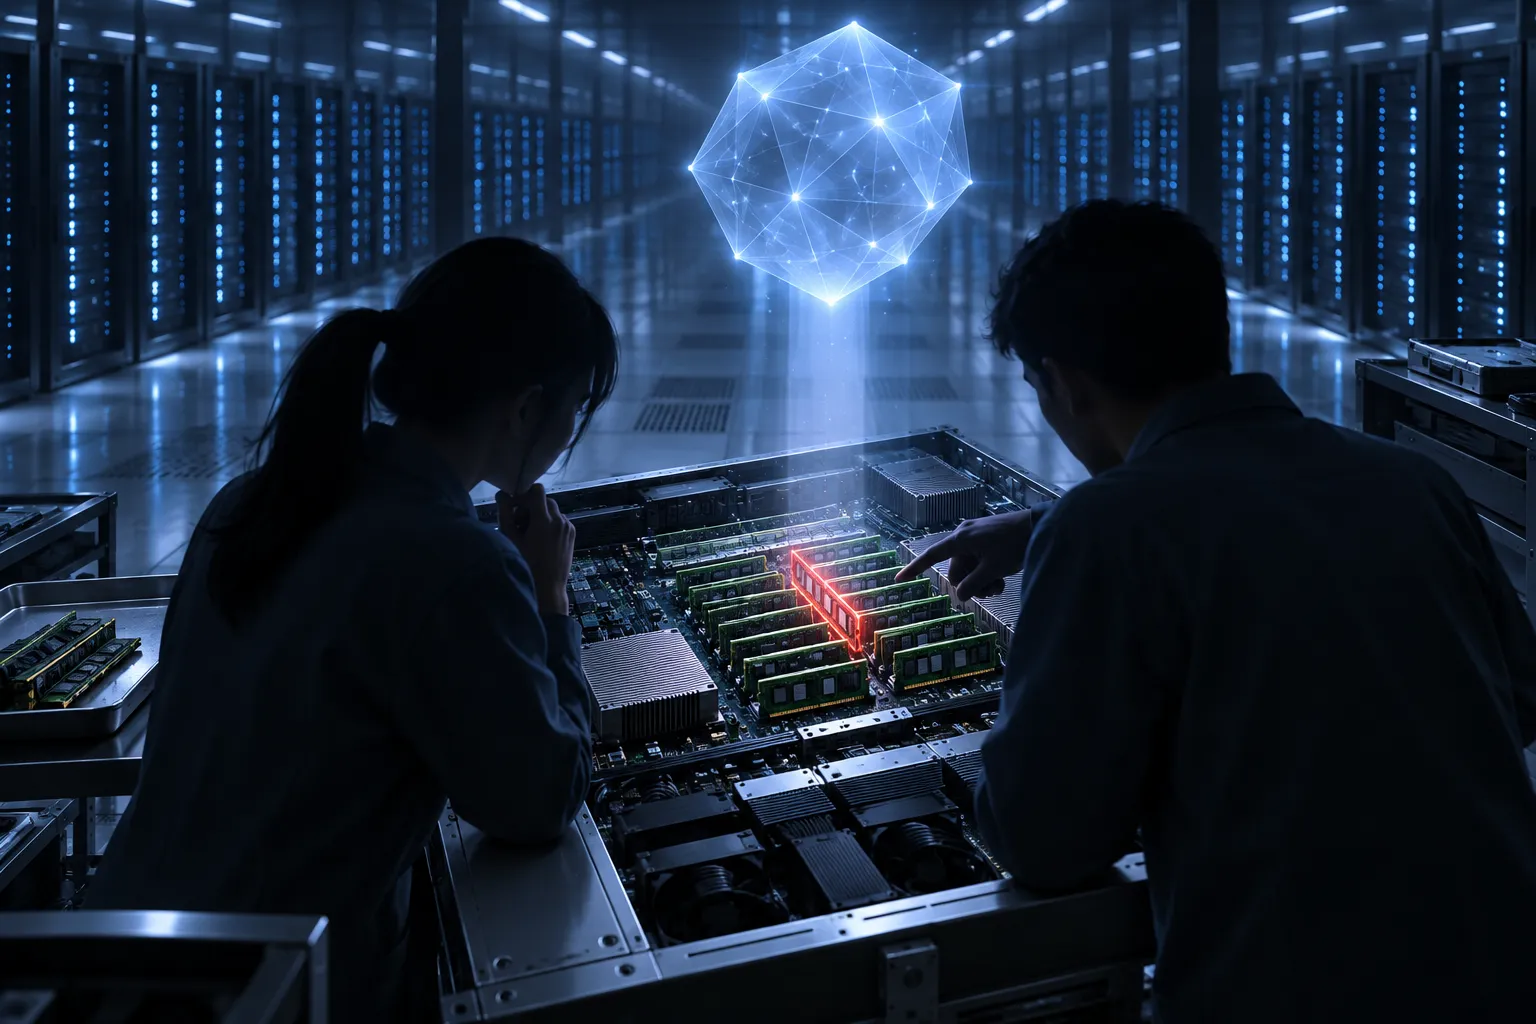
▲ 表に出ないメモリー破損の診断
ブリン氏は1998年か1999年の似た出来事を振り返りました。Googleが購入したばかりの約20台のサーバーが、どれもOSをインストールできなかったのです。何日もデバッグした末に、同氏はベンダーがマザーボードに合わない高スペックのメモリーを出荷しており、それが数時間ごとにデータを破損させていたことを突き止めました。それから約30年後、AIモデルが驚くほどよく似た問題を突き止めたことになります。
Argonの答えをどう確かめるか
Argonが広まるにつれ、ユーザーはおなじみの問いに直面します。意外な結果や込み入った結果を信じてよいのか、という問いです。Googleの外にいる開発者には、モデルの仕事を再確認してくれる10万人の同僚はいません。GoogleはArgonについて、根拠にしっかり基づき、迎合性(ユーザーが聞きたいことを言う傾向)を避け、成果を誇張せず、説明をでっち上げないとしています。それでもチームは、いくつかの習慣を勧めています。
- 誰に対しても同じように疑う。 ブリン氏は、あるアイデアがAIモデルから出たものでも人間の同僚から出たものでも、同じように吟味すべきだと言います。
- モデル同士に批評させる。 モデルにはエゴがないため、別のモデルの出力や以前の草稿の欠点を進んで指摘します。異なるモデルは異なる視点をもたらします。
- 最初の答えで止まらない。 ウッドワード氏は、ソフトウェア開発のボトルネックがコードを書くことからレビューすることへ移りつつあると言います。答えがおかしいと感じたら、同僚と一緒に元のプロンプトを練り直し、モデルにさらに深く掘り下げるよう求め続けましょう。追加の推論で結果が良くなることが多いからです。
- 自分の頭で考え続ける。 モデルをブレインストーミングの相手として扱い、出力をよく読み、不明瞭なところや誤っていそうなところを問いただしましょう。微妙な論理の誤りは、推論の筋が通っているかを誰かが積極的に確かめたときにだけ表に出やすく、非専門家ほど見逃しやすいものです。
粘り強さ、確認の質問、見える推論のバランス
モデルの振る舞いを調整するには、相反する目標の間で折り合いをつける必要があります。粘り強すぎるモデルは方向を変えるべきときにも突き進み、粘り強さが足りないモデルは確認の質問を重ねてユーザーを疲れさせます。
推論をどこまで見せるかも、同じようなトレードオフです。詳しい思考の過程は透明性を高めますが、長すぎるとインターフェースを圧迫します。Googleは社内テスト用のチャットルームで反応を集め、そのフィードバックをArgonで要約しています。Geminiアプリでは、思考の過程をどのくらいの間表示しておくべきか、ユーザーがいつそれを折りたたみ、いつ開くのかを試してきました。ウッドワード氏によると、初期のユーザーは思考の過程を隅々まで読み込む傾向がありますが、信頼が深まるにつれて短い要約を好むようになります。Googleはさらに、モデルの推論を簡潔な要約にまとめる専用の思考要約機能を開発者向けAPIに追加しています。
まとめ:今Gemini 4 Argonで何をすべきか
Gemini 4 Argonは今、一般ユーザーにも開発者にも開かれています。Googleの主張は三つの柱に立っています。はるかに長い推論出力、AIスロップを抑えた文章、そして自らの後継づくりを手伝えるほどの高い能力です。10万人の社員から政府による安全性審査まで及ぶテストの規模は、新しいモデルを公開するためのハードルが上がり続けていることも示しているようです。
- 入り口を選ぶ。 一般ユーザーはGeminiアプリを、開発者はGoogle AI StudioかGemini APIから使い始められます。
- 編集者として使う。 まとまっていない考えを口述し、最も弱い論点三つと見落としを尋ねましょう。文章がありきたりに聞こえるなら、箇条書きと埋め草を避けるよう指示します。
- 長い推論は難しい問題に取っておく。 数学の証明や深い研究の問いでは、推論強度を「high」に設定します。
- 表示する推論は短く。 アプリでモデルの思考を見せるなら、APIの思考要約機能を使いましょう。
- 信頼する前に検証する。 意外な結果は別のモデルに批評させ、プロンプトを練り直し、最終判断は自分で下しましょう。
- フィードバックを送る。 モデルが立ち止まって確認の質問をすべきときと、自らの想定で進めるべきときをGoogleに伝えましょう。次のバージョンの調整に役立ちます。