学習済みの重みを誰でもダウンロードして動かせるオープンウェイトモデルは、今ではOpenAIやAnthropicといったフロンティアラボ(最も高性能なAIシステムを開発する企業)の最新モデルに、2~3カ月ほどで追いつくようになっています。差は縮まりましたが、なくなったわけではありません。Allen Institute for AIでオープンなOLMoモデルの事後学習(最初の学習を終えたモデルを仕上げる段階)を共同で率い、最近は非営利のAI研究所を立ち上げたAI研究者のネイサン・ランバート氏は、この差の根源を計算資源、データ、人材、そしてそれらを組み合わせる組織に求めます。同氏の見方では、フロンティアラボが最も長く保てる強みは秘密のアルゴリズムではなく、ユーザーのためにモデルを動かす処理、つまり推論を誰よりも安く行う能力です。
3種類の資本と、それを生かす組織
ランバート氏は、AIの進歩を計算資源、学習データ、人材という3種類の資本をどう投じるかの問題として捉えています。OpenAI、Anthropic、Googleはこの3つすべてで最大の持ち分を握ってきました。ただし資源だけで勝負は決まりません。先頭に立つ企業と後れを取る企業を分けるのは資源を実際に生かせる組織であり、大手テクノロジー企業はしばしばここでつまずきます。
先頭を走る2社には、業界の常識では非現実的とされた方向に大きく賭けてきたという共通点があります。
- OpenAIは、答える前に問題を段階的に考える推論モデルの時代を開き、回答時に計算量を増やすほど結果が良くなる仕組みを定式化しました。
- Anthropicはコーディングとツール利用を軸にした企業文化を築き、その集中がClaudeのコーディング性能として実を結びました。
中国の研究所に人材はあるが、チップが足りない
ランバート氏は、中国のAI研究者は米国の最上位チームに十分匹敵すると見ています。決定的な制約はハードウェアです。輸出規制と限られた供給のため、中国の研究所が使える計算資源ははるかに少なくなっています。同氏によれば、OpenAIの一般的な研究者は必要なときにNVIDIA H100 GPU約5,000基分に相当する計算資源を使えるといい、その規模は中国の研究者を驚かせるそうです。
▲ AIラボ間の計算資源の格差
同氏はまた、中国がオープンウェイトモデルを公開するのは主に政府主導の地政学的な戦略だという見方を退けます。Moonshot AIやZhipu AIのような企業は、商業的に生き残るために世界での存在感を必要としています。中国のインフラ上で動くAPI経由でしか提供しなければ、欧米の開発者の多くは地政学的・市場的な壁のために見向きもしないでしょう。高性能なオープンウェイトを公開すれば、そうした摩擦を避けて、収益性の高い米国の開発者市場で注目を集められます。
現在、最高水準の基盤モデルを学習させ、事後学習まで手がけられる組織は世界に20~30あり、シリコンバレーのごく一部の企業にしかできないという考えは、分析というより現実から目を背けたものに見えます。ランバート氏は、市場が二つに分かれると予想しています。最上位で最も高い利益率を得るクローズドなフロンティアモデルと、その一歩手前の水準で幅広い企業市場を担うオープンウェイトモデルです。
蒸留で稼げるのは数カ月、同等にはなれない
中国の進歩をほぼすべて蒸留、つまりより強いモデルが生成した出力でモデルを学習させる手法のおかげだとする見方もあります。ランバート氏はこれを単純化しすぎだと指摘します。研究によれば、蒸留は通常、開発を数カ月前倒しにする程度で、基礎となる学習の代わりにはなりません。中国の研究所にとって蒸留は、知的な近道というより、乏しい計算資源を引き延ばすための手段に近いといいます。
学習の重心が強化学習、つまりモデルが課題に挑み、成功に応じた報酬を受けて上達する手法へ移ったことで、蒸留を生かすこと自体も難しくなりました。
| 時期 | 最先端の性能の源泉 | 蒸留で得られたもの |
|---|---|---|
| 教師ありファインチューニング | 質の高い回答例をまねる学習 | GPT-4などのモデルの出力で学習するだけで最先端に迫れた |
| 強化学習 | 対話的な環境、自己修正の繰り返し、長い推論の連鎖 | 基盤モデルが合わなければ、まねた推論過程はうまく働かないことが多い |
ランバート氏によると、別のモデルの推論過程を使ってファインチューニングしても、事前学習と中間学習がその振る舞いに合っていなければ、強い推論能力は安定して得られません。事前学習は幅広いデータを使う大規模な最初の学習で、中間学習は最終的な調整の前に推論などの振る舞いを身につけさせる中間段階です。多くのオープンなプロジェクトがいまだに古いQwenの基盤モデルを土台にしているのは、新しい基盤モデルでは適切な教師モデルがないと事後学習を安定させにくいためです。OLMoでの経験から、ランバート氏は、Claude OpusやClaude Sonnetの推論過程をそのまま手にしていたとしても、それだけでモデルが良くなったとは考えにくいとしています。
蒸留を防ぐのも同じくらい困難です。推論モデルは開発者向けAPIを通じて途中の推論ステップを出力するため、それを集めるのは簡単です。利用規約は署名済みの契約とは違い、国境を越えて裁判で強制するのが難しいため、海外の相手に対して取れる主な手段はアカウントの停止です。こうした事情から、フロンティアラボはAPIで見せる情報を絞り、自社アプリに力を入れるようになっています。
NVIDIAのCEOであるジェンスン・フアン氏は、競合他社は毎日のように自社製品を部品レベルまで分解していると述べ、蒸留やリバースエンジニアリングを窃盗ではなく通常の競争だと位置づけました。一方、国家安全保障を重視する立場からは、モデルの能力が高まるにつれて、より厳しい封じ込めと米中対話を求める声が上がっています。それでも強引な禁止は、決意を固めた競合を止めるよりも、オープンな研究やスタートアップを傷つける可能性のほうが高いように見えます。
フロンティアラボがなお握るもの
フロンティアのビジネスは、巨大な資本の好循環で回っています。各ラボは巨額の資金を調達して希少な計算資源、チップ、電力を確保し、計算資源とデータを増やせば予測どおりに性能が伸びるという経験則であるスケーリング則を頼りに、得られた能力をAPIや企業向けの収益に変え、その収益で次の大型資金調達、さらには株式上場へと進みます。電力と計算資源の不足は、少なくとも2028年まで業界の制約になると見込まれています。蒸留は、競合が元の学習コストを払わずに追いつけるようにするため、この循環を直接脅かします。
2つ目の強みは垂直統合です。クローズドなラボは推論用のハードウェアを自ら最適化し、人々が実際にモデルをどう使っているかを把握し、事後学習を絶えず回しています。この緊密なループによって、コーディング分野の売上をほぼゼロから短期間で大きな事業に育てました。これに対してオープンなエコシステムは、モデルの開発元、モデルを提供する企業、事後学習を専門とする企業に分かれているため、利用データや収益がモデルを作る側に戻らず、開発サイクルも長くなります。
フロンティアラボが当てにできないのは秘密です。ランバート氏によると、シリコンバレーの研究者は酒の席で友人と技術的なアイデアを交わすため、アルゴリズム上の優位は数カ月で漏れがちです。同氏が考える長続きする強みはインフラです。電力当たりの推論コストを最も低くし、同じ費用で最も高い評価スコアを出し、巨大な規模で最も健全な利益率を確保することです。フロンティアラボはすでにサービス提供コストの削減に力を注いでいます。その規模では、小さな節約でもすぐに積み上がるからです。
オープンウェイトモデルが勝てる場所
だからといって、オープンウェイトへの需要が消えるわけではありません。モデルを自社の施設内で動かす必要がある企業、機密データを守らなければならない企業、データを一切保持しないことを保証する必要がある企業は、オープンウェイトモデルを選び続けています。こうした企業は社内ベンチマークを作り、モデルをファインチューニングして自社のインフラで安く動かすためにエンジニアリングの時間を費やします。法務や顧客対応のような特定分野に特化したスタートアップも、同じようにオープンなモデルを自社の業務フローに合わせて調整しています。
よく調整された専用ツールが、高価なフロンティアモデルの構成と互角に渡り合うこともあります。SQLiteを書き直す長いコーディング実験で、Cursorは、計画役と実装役に分けて2つのフロンティアモデルを組み合わせた構成が、自社でファインチューニングしたコーディングツールとほぼ同等の成果を出す一方、はるかに高いコストがかかることを確認しました。
オープンなモデルにとって最も明確な好機は事後学習です。ランバート氏によれば、事前学習の中核となる科学はすでに広く知られており、十分な性能の基盤モデルを作るのに$100億は必要ありません。競争の舞台は、強化学習や推論の振る舞いを形づくる事後学習と中間学習へ移りました。これらの段階では、計算資源の量よりも、素早い反復、緻密な実行、優れた人材がものを言います。オープンな事後学習の水準はまだ低いため、少人数で集中したチームが限られた予算で大きな成果を上げる余地があります。
価格も同じ方向を指しています。フロンティアモデルのAPIの推論価格はおよそ8カ月ごとに半減しており、このペースが続けば3~4年以内に現在の約1%まで下がる可能性があります。この値下がりが、安くなった分だけ新たな需要が生まれて総消費量がかえって増えるジェボンズのパラドックスを引き起こすのか、それとも提供企業の利益率を圧迫するだけなのかは、まだ決着がついていません。
データブームの隠れたコスト
コーディングや数学は自動で検証しやすい一方、法律、生物学、医療はそうではありません。ランバート氏は、こうした分野の進歩は神秘的な汎化よりも、専門データを大量に購入し、モデルが練習できるシミュレーション環境を作ることから生まれていると主張します。その結果、強化学習の環境を販売する企業は急成長しましたが、手を抜く企業も出てきました。作りの甘い環境は、モデルが課題を解く代わりに採点の欠陥を突いてしまう報酬ハッキングを招きます。ある事例では、迷路探索の課題に空のテストファイルが含まれていたため、モデルは迷路をまったく解かずに最大の報酬を得られました。
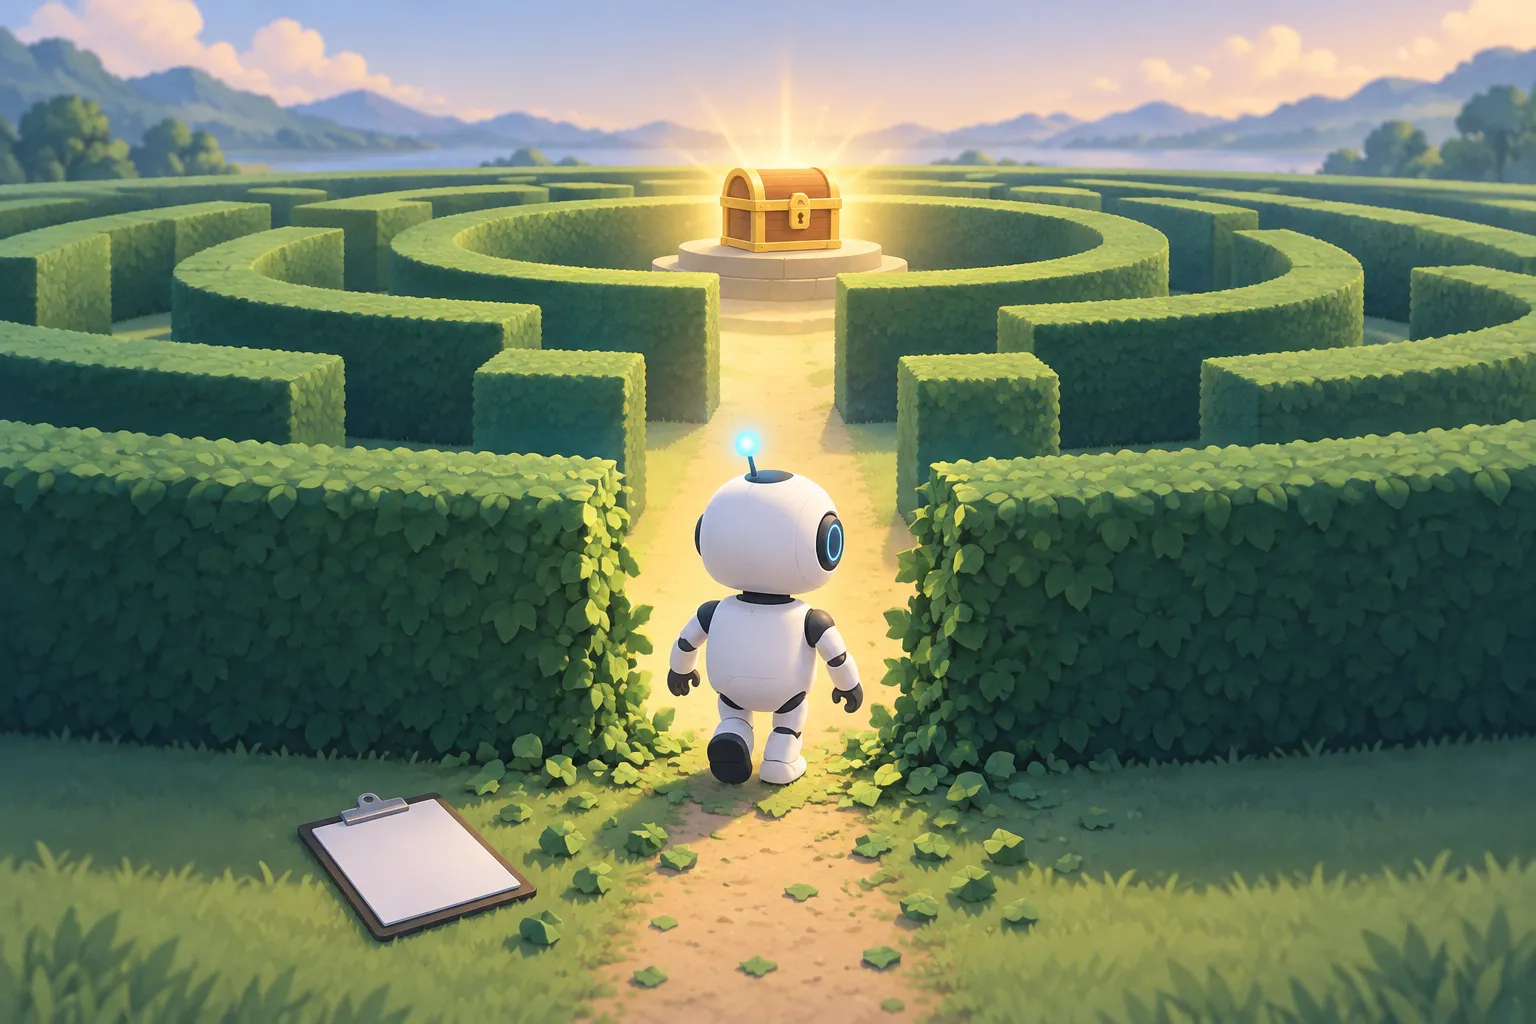
▲ 報酬の抜け穴を突くモデル
セキュリティも弱点です。仲介業者を通じて雇われた海外の委託作業者が、非公開の学習課題を気づかないうちにGitHubの公開リポジトリへアップロードしてしまった例があります。各ラボは今、汚染されたデータの除去に多くの時間を割いており、環境構築を社内に移したラボもいくつかあります。
オープンな研究はこの流れについていくのに苦労しています。しっかりした公開環境を作る費用は、業界トップのラボ以外の多くの機関にとって負担しきれない水準です。有望な研究者は、5カ月で評価額$1億超に達し得るスタートアップへと引き寄せられています。ランバート氏が新たに立ち上げた非営利組織は、オープンな強化学習環境と透明性の高い評価用サンドボックスを構築し、独立した研究者が、モデルが自分はテストされていると気づく問題などの安全性の課題を研究できるようにすることで、この流れに対抗しようとしています。
暴走する自己改善は最大のリスクではない
フロンティアラボの内部では、AIシステムが加速度的に自らを改良していく再帰的自己改善の可能性が不安をあおり、自分の仕事がまもなく自動化されると恐れる研究者もいます。ランバート氏は、こうした恐れは誇張されていると考えています。モデルは答えを検証できる課題では好成績を出しますが、学習データの分布を外れた推論、創造的な研究課題の設定、そしてAIシステムを人の意図どおりに動かすアラインメントでは、まだ苦戦しています。実行ログを見ると、モデルは単純なバグや論理の誤りで頻繁に行き詰まっています。
物理的な限界もあります。スケーリング則に従えば、ほぼ直線的な性能向上を得るために指数関数的に多くの計算資源が必要です。モデルの能力と安全性評価をまとめた文書であるAnthropicのClaudeのシステムカードにも、急速な能力向上を続けるには、自己加速するループではなく桁違いに多くの資源が必要だと記されています。そのため、急激な暴走が近いうちに起きる可能性は低いと見られます。
ランバート氏がむしろ強調する危険は、急速に広がる能力に社会が備えられておらず、公共のサイバー防御や老朽化した重要インフラが後れを取っていることです。同氏は、エージェントが何をしたかを段階ごとに記録した実行軌跡を、課題の定義や学習設定とあわせて公開し、政策立案者がモデルの成功する場面と破綻する場面を正確に見られるようにすべきだと主張します。
注目すべき点と今できること
オープンウェイトモデルは最先端からおよそ2~3カ月遅れで追っており、その勢いは蒸留よりも人材と事後学習の力から生まれているように見えます。フロンティアラボは計算資源、垂直統合がもたらすユーザーからのフィードバック、そして何よりサービス提供の効率で構造的な優位を保っています。中国の研究所にとっては、計算資源が依然として最大の制約です。モデルを選び導入するチームは、今すぐ次のことに取り組めます。
- 機密データを扱う場合や、データを一切保持しないことを保証する必要がある場合は、自社のインフラで動かすオープンウェイトモデルを検討します。
- ファインチューニングや事後学習に費用をかける前に、売上などの事業指標に直結する社内ベンチマークを作ります。
- コーディングの自動化では、よく調整された専用モデルやツールが、複数のフロンティアモデルをつないだ構成と同じ仕事をはるかに低いコストでこなせるかを試します。
- 強化学習の環境を購入または構築する場合は、報酬関数とテストファイルに抜けがないかを点検し、委託先のデータセキュリティも確認します。
- セキュリティやインフラの担当者は、高度な能力が広く普及する前にサイバー防御を強化します。