2026年5月、Anthropicがメインのコードリポジトリにマージした変更は1日平均2,500件でした。9月にはその数が3万件を超え、9月9日には1日で30,401件に達しました。急増をもたらしたのはClaudeです。Claudeはいまや研究のループを自ら回し、複雑なプログラムを最適化し、バックエンドサービスをゼロから構築しています。その結果、Gitベースのソース管理やCI(変更のたびに自動でビルドとテストを行う仕組み)のように人間のペースを前提に作られたツールが、同社最大のボトルネックになりました。Anthropicは10月13日に公開した技術解説で、7人のチームが新しいバージョン管理システムScionとコードレビューツールAntiqueを開発し、5か月でモノレポをGitから移行した経緯を説明しています。AIコーディングエージェントに大きく頼るチームは、いずれ同じ壁に突き当たるかもしれません。
Gitが作業量に合わなくなった理由
Gitは、コードは人が書くもので、作るのにコストがかかり、人による丁寧なレビューに値するという前提の上に成り立っています。また、分散型でもあります。クローン、つまりリポジトリを丸ごと複製したローカルのコピーは、それぞれが全履歴を保存し、diffを自分のマシンで計算し、オフラインでも動きます。これはオープンソースのプロジェクトや人間規模のチームには合っていますが、多くのプロジェクトのコードを1つのリポジトリに収めた巨大なモノレポで、機械が昼夜を問わず変更を作ってはテストする状況には向きません。
| 指標 | 規模 |
|---|---|
| mainブランチの履歴 | 100GB超 |
| 圧縮した作業コピー1つ | 25GB超 |
| 1日のCIチェックアウト数 | 約2,500万回 |
| すべてのチェックアウトで全体を取得した場合の1日の通信量 | 600PB超 |
チェックアウトとは、ジョブが作業できるようにリポジトリからコードを取り出す処理で、この1日の回数には開発者の環境、エージェントのサンドボックス、研究用ジョブは含まれていません。Anthropicは、シャロークローン、スパースチェックアウト、ブロブレスクローンなど、リポジトリの一部だけを取得する一般的な回避策を試し、社内のGitミラーサーバーを数百台運用しました。しかしマージが加速するにつれ、この構成はもろくなっていきました。ミラー用のシードスナップショットはmainブランチの先端に追いつけなくなり、部分的なクローンでは、diffやblame(各行を最後に変更したのがどの変更かを示す記録)の計算に大きなコストがかかるようになりました。
より根本的な問題は、使い手が変わったことです。従来のバージョン管理は、接続が途切れがちでオフラインでも作業する必要がある利用者を想定しています。一方、Anthropicのソース管理の主な利用者はエージェント、CIボット、計算ジョブで、常にオンラインです。分散型でオフラインの開発においてGitを強くしていた特性が、自動化された作業量のもとではかえって足かせになりました。Anthropicはバージョン管理を根本から考え直し、GoogleのPiperやMetaのSaplingといった大規模システムを参考にしました。Meta自身もかつて、自社のモノレポに対応するためにMercurialを大幅に作り替えています。
▲ リポジトリ全体を複製するコスト
Scionを支える原則
ScionはGitの前提の多くを逆転させています。
- 重い処理はサーバーが担う。 履歴、diff、blame、マージ、リベースは、正本を持つサーバーが処理します。クライアントは容量に上限のあるローカルキャッシュだけを持ち、ディスク上の変更に合わせて作業コピーを同期します。
- ソース管理をAPIにする。 CIジョブやツールは、リポジトリをダウンロードせずに、コミットの関係やファイルの履歴をリモートで問い合わせます。問題のある変更を突き止めて取り消すAnthropicの自動bisect・revertパイプラインも、この方法で障害を切り分けます。
- コミットは軽く、ロックがない。 コミットは変更分だけを積み上げ、ロックを取らないため、何百ものエージェントが順番待ちをせずに同時にコミットできます。コミット、リベース、マージはサーバー上で直接行われ、コミットのコストはリポジトリではなく変更の大きさに比例します。サーバー間の合意が必要なグローバルなブランチポインタは、mainのトランクとリリースブランチに限られます。
- システムは横に広がる。 リポジトリの完全なコピーを持つサーバーやストレージノードは1つもなく、Gitがオブジェクトの保存と転送に使う圧縮バンドルであるパックファイルもなくなりました。
- ローカルのコピーは任意。 作業コピーは既定でスパースです。仮想化されたチェックアウトは、ローカルのファイルシステム上にファイルを見せておき、プロセスが実際に読んだときだけ内容をダウンロードするので、ジョブが負担するのは使ったバイト分のコストだけです。diffだけが必要なジョブはAPIにメタデータを問い合わせ、書き込みジョブはチェックアウトなしで変更を送れます。
全体のツリーではなくチェンジセット
Scionの基本単位はチェンジセットです。これは先行書き込みログ、つまり変更を順番に記録していく追記専用の記録の1項目です。Gitのコミットはディレクトリ構造全体を表すツリーを指しますが、チェンジセットは最初の親と比べて変わったファイルだけを列挙し、それぞれをコンテンツアドレス、すなわちファイルの内容から導いたIDで参照します。author、committer、タイムスタンプ、メッセージ、親といったメタデータはGoogle Cloud Spannerに、ファイルの内容はGoogle Cloud Storageに置かれます。Scionはデータを追加するだけで、差分ではなく変更されない完全なファイルを保存するため、パックファイルも分散ロックもサーバー間の調整も要らず、長い差分の連なりからファイルを組み立て直す手間もかかりません。
authorとcommitterの欄を分けることで、変更を求めた人やシステムと、実際にその変更を行ったエージェントを記録します。ある行を最後に編集したのは誰かといった、チェンジセット単体では答えられない問いには、サーバーが計算する派生データで対応します。blameの構造、パスごとの履歴、コミットグラフをたどるためのスキップリストなどです。各値は親のチェンジセットから再帰的に定義され、前もって計算することも必要なときに計算することもでき、APIの裏側に隠されています。そのためAnthropicは、コピー検出などのインデックスをクライアントのコードを変えずに追加できます。
必要な分だけ取得する
クライアントはパックファイルの交渉をする代わりに、ローカルの保存領域を確認し、足りないツリーのノードをルートから順に要求したうえで、必要なファイルの内容だけを取得します。数ギガバイトの応答の代わりに小さな要求を重ねるため、取得は途中から再開でき、キャッシュもしやすくなります。キャッシュは3層です。
- scion-daemonは、開発者のマシンとCIノードごとに動き、そのマシン上のすべてのプロセスにデータを提供します。
- scion-cacheは地域ごとに置かれ、すぐに書き込める形式のオブジェクトをメモリから送ります。
- scion-serverは正本を持つ層で、キャッシュにない要求が来るとSpannerからメタデータを、Cloud Storageからファイルの内容を読み出します。
3つの層はどれも同じRPCプロトコル(あるプログラムが別のマシン上の機能を呼び出す仕組み)を使いますが、層の間の規則を厳格に守ることで、地域キャッシュが止まっても正本のサーバーに要求が殺到しないようにしています。コミットされたデータは変わらないため、どのサーバーやキャッシュも互いに確認せずに応答できます。Scionの導入も段階的でした。最初はメタデータサービスとしてのみ使われ、専用のクライアントと転送の仕組みは後から加わりました。
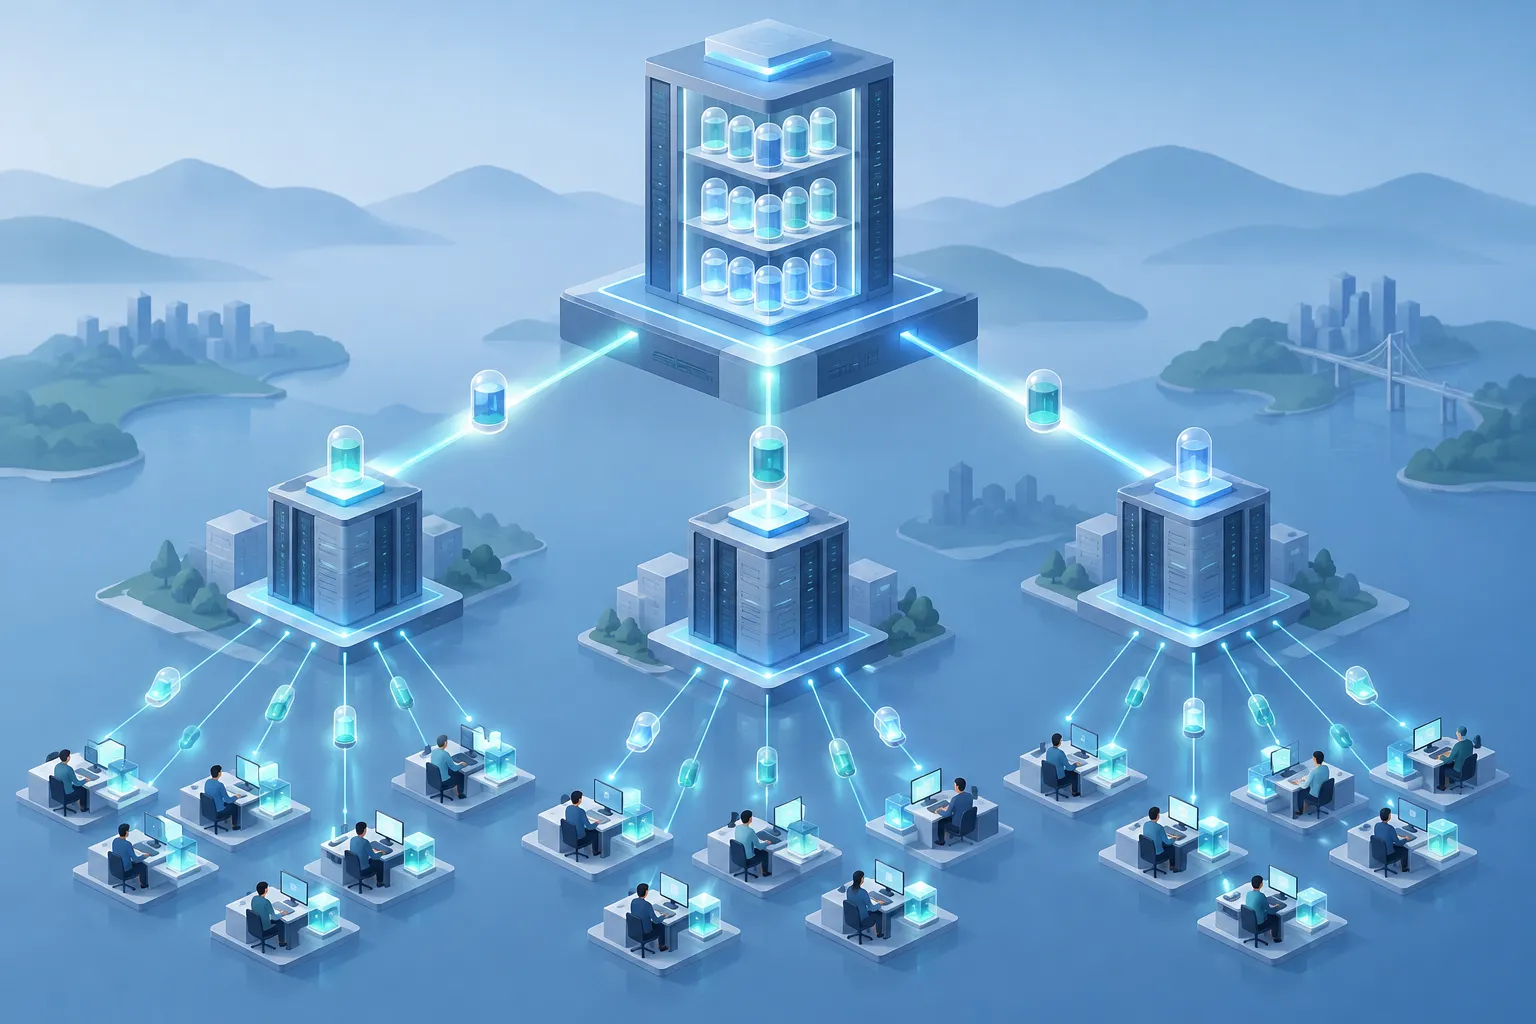
▲ Scionの3層キャッシュ
成果
Anthropicによると、キャッシュのヒット率は99%を超え、CPUとメモリの使用規模は従来のGitミラー構成の200分の1になりました。この切り替えでCIのCPU容量の25%が空き、チェックアウトは数分から数秒に縮みました。
| 操作 | Git | Scion | 高速化 |
|---|---|---|---|
| 最新コードの取得 | 87秒 | 3.5秒 | 25倍 |
| チェックアウト | 15秒 | 1.1秒 | 14倍 |
| ステータス確認 | 3.9秒 | 19ミリ秒 | 207倍 |
| diff | 407ミリ秒 | 67ミリ秒 | 6.1倍 |
| 新しいエージェント用worktreeの作成 | 7.1分 | 5.1秒 | 84倍 |
最初の3つの数値は開発者の環境で測ったもので、worktreeは同じリポジトリにひも付いた別の作業ディレクトリです。節約できた時間は、1日あたりエージェント時間で1,000時間超、マシン時間で約17万5,000時間に上ります。
7人で5か月を実現した方法
7人のチームは、1日にマージされるコードが10倍に増えるなかで、ScionとAntiqueを開発し、関連する社内システム6つほどを移行しました。社内のコード検索、ソース管理向けのアクセス管理、レビュー済みの大量のコードを取り込むツールも用意し、モノレポ内の機密性の高いディレクトリを守るきめ細かなアクセスルールも設けました。こうした移行には、かつては大きな部署が何年もかけていました。
作業の多くを担ったのはClaudeです。
- Claude Mythos Previewは、Gitの履歴をScionに取り込むパイプラインの手書きの試作品を、人の指示なしに書き直しました。新しい版はメモリ使用量が20分の1になり、4倍速く動き、暗黙の順序の規則もすべて守りました。
- Claudeは、外部システムから切り離して動くハーメチックなシミュレーションテスト、ランダムな入力を与えてバグを探すファザー、レート制限の仕組みを作り、ScionをAnthropicで最も徹底的にテストされたコードベースの1つにしました。
- Claudeは、データベースのインデックスが効いていなかった祖先クエリの細かな最適化点も見つけました。通常なら性能の専門家が数日から数週間かけて調整する作業です。
エンジニアに残る仕事
Anthropicによると、エンジニアは今も欠かせませんが、その仕事はアーキテクチャ、つまりシステム間の制約とその間のトレードオフへと一段上に移りました。重要な役目の1つは、エージェントが中核の規則を破ったりシステムを迂回したりする案を出したときに、Claudeに「ノー」と言うことです。移行中には、複数のClaudeエージェントが、Antiqueに問い合わせずにGitのログを走査してプルリクエストの履歴を再構築しようとしたことがありました。エージェント同士の敵対的なレビューは防御的な過剰設計も生み、仮定のレビュー指摘に応えるための余分な検証コードが書かれました。人によるレビューは今では文法ではなく意図と設計の妥当性を確かめ、Antiqueは意味に基づくルールによって、レビュー担当者が表面的な編集を読み飛ばせるようにしています。
Slackの専用チャンネルに置いたClaudeエージェントは、scion-daemon、scion-cache、Antiqueのマージキューといったコンポーネントのテレメトリーも見守っています。Anthropicはこれらを「スーパーファン」と呼び、複数のログやグラフにまたがる微妙な異常を、標準のアラートよりうまく見つけると評価しています。
まずマージし、すばやく検証する
開発の慣行も変わりました。例えばマージキューです。マージキューは変更を並べ、取り込む前にテストする仕組みです。CIの実行中にリポジトリ全体をロックするキューは、何千ものエージェントの変更が一度に届くと手に負えないボトルネックになります。Anthropicはこれをやめました。今は同時に届く変更を受け入れ、マージ後とデプロイ前に自動で検証し、マージの競合はClaudeにすばやく解消させています。
この方法は、マージボタンそのものからリスクを取り除くという、より広い考え方に沿っているようです。人が見る前に自動チェックで変更を検証し、段階的なロールアウト、少数のユーザーに先に届けるカナリアリリース、即時のロールバックによって、問題が起きたときの被害を抑えます。マージ前の手続きをいくら重ねても壊れた変更をすべて防ぐことはできないため、エージェントの規模では、すばやい復旧に投資するほうが現実的な選択に見えます。
Scionを社内にとどめる理由
Anthropicは、ScionはGitの汎用的な代替ではないとしています。何千人ものエンジニアと大量のエージェントが共有する巨大なモノレポを対象にしているからです。導入すれば、コードレビュー、検索、ビルドとデプロイのパイプライン全体でGitを捨てることになります。また、AIモデルが処理し課金の単位とするトークンへのAnthropic社内の支出は、ほとんどの企業がインフラ用ツールに正当化できる水準をはるかに超えています。代わりに同社は、標準のRPCプロトコルとネゴシエーションの仕組みでGitをサーバー側から近代化し、通常のGitクライアントがGitHubやGitLabと併用できるようにすることを提案しています。Anthropicは、ほとんどのチームはすぐにはこの限界に達しないものの、AIで大量のコードを生成するチームはいずれ達し、この問題は6か月から12か月のうちに業界で一般的になると見ています。
今やるべきこと
エージェントが人やツールの処理能力を超える速さでコードを書くようになると、ボトルネックはコードを書くことからソース管理とCIへ移ります。Scionはサーバー側の計算、ロックのないコミット、必要に応じた取得、マージ後の検証でこれに対処しました。独自のScionが必要なチームはまだ少ないものの、次の手順は取り組む価値があります。
- GitがCIにかけるコストを測る。 ある小さなスタートアップがCIの履歴を調べたところ、約46万5,000回のチェックアウトで、Gitの準備だけにランナー時間が1,000時間近く、マシン時間にして約42日分使われ、待つだけで$350 ~ $600のコストがかかっていました。
- フルクローンを強制しない。 diffやメタデータだけが必要なジョブは、スパースチェックアウトや仮想ファイルシステムを使い、読むファイルだけを取得できます。
- 依頼した人と実行したエージェントを記録する。 変更を求めた人と、それを行ったエージェントを分けて残します。
- 関門より復旧に投資する。 マージ前の手間を増やすより、マージ後のテスト、段階的なロールアウト、すばやいリバートを重視します。
- レビュー役のエージェントを抑える。 エージェントには推測に基づく防御策や余分な検証層を加えないよう指示し、人のレビューは意図と設計に集中させます。
標準のツールが自社の規模で実際に破綻するまでは、自前のツールに置き換えるべきではありません。とはいえ推論のコストは急速に下がっており、1年ほどのうちには一般的なソフトウェア企業でも、自社の作業量に合わせたソース管理の層を手頃なコストで作れるようになるかもしれません。まずは自分たちのボトルネックがどこへ移りつつあるのかを測ることから始めましょう。