AIエージェント(複数の手順からなる作業を自律的にこなすAIプログラム)を動かす方法の一つに、ターミナルの道具として扱うのをやめ、社員のように会社のSlackワークスペースに席を用意するやり方があります。この構成では、それぞれ人の名前とプロフィール写真、肩書き(CEO、プロダクト、開発、マーケティング、営業)を持つ5つのエージェントが、Slackのスレッドでタスクを引き受け、仕様書やコードを書き、プルリクエストをレビューし、互いの成果物にフィードバックを残します。人はWebダッシュボードから仕事を割り振り、結果をSlackで確認します。うまく回る鍵は二つあるようです。新しい社員を迎えるように各エージェントをオンボーディングすること、そしてSlackとAIモデルの間に自前のサーバーを置くことです。
ターミナルよりチャットのワークスペースが向く理由
Claude CodeのようなコマンドラインツールだけでAIエージェントを動かすこともできますが、どこか距離を感じます。作業はまとまりを欠き、会社がどこまで進んでいるかを一目で把握できず、整った会社を運営している感覚もありません。エージェントをSlackやDiscordのようなチームチャットアプリに移すと、実際の会社と同じ動き方になります。メンバーがチャンネルで調整し、結果を報告し、仕事を引き継ぐのです。
典型的な引き継ぎは次のとおりです。プロダクト担当のエージェントが、Binance REST APIからBTC、ETH、SOLの価格を取得するウォッチリストアプリの仕様書を書きます。開発担当のエージェントがそれを実装し、プルリクエスト(レビューを受けるために提出するコード変更の提案)を作成します。その間、CEO担当のエージェントは過去1か月分のチームの業務概要を確認し、リーダー担当やプロダクト担当のエージェントと活動ログを照らし合わせます。
人の名前やアバター、肩書きは単なる飾りではありません。複数のエージェントが同じスレッドで話していても、誰が何を担当しているかがすぐに分かります。同じ仕組みは個人でも使えます。家計管理、バイブコーディング(作りたいものをAIに説明してソフトウェアを作る手法)、リサーチ、健康、ワークフロー、コンテンツのチャンネルを分けたプライベートなワークスペースは、「第二の脳」として働きます。
この考え方を突き詰めると、将来の企業はより少ない人数で、厳選された少数の専門エージェントを抱える形になるかもしれません。ただし実際には、この構成は人とエージェントが並んで働くハイブリッド型で運用されています。
人を迎えるようにエージェントを迎える
仕組みも指示もないまま業務に放り込まれたエージェントは、研修を受けていない新人と同じく、失敗する可能性が高いでしょう。各エージェントには、人が初日に受け取るのと同じもの、つまり会社の文脈、明確なミッション、具体的な職務記述書が必要です。
- 会社の文脈: ビジネスモデルや目標、運営ルールをClaudeとの音声会話で話し、その書き起こしを文脈ドキュメントとして保存します。手早く作れる方法です。
- 職務記述書: 各エージェントの責任、越えてはならない範囲、提出すべき成果物を定めます。
- スキル: 繰り返し使う手順を、作業の進め方を正確に指示するファイルであるスキルにします。
- 記憶: うまくいった点と間違えた点をエージェントに伝え、そのフィードバックを保存して次の実行前に確認させます。
これらはすべて、コンピューター上のフォルダーとMarkdownファイルにまとめます。典型的な構成は次のとおりです。
| 項目 | 中身 |
|---|---|
| contextフォルダー | ビジネスモデル、目標、運営ルール |
| エージェントごとのフォルダー(developer、leader、research、task-creator、testerなど) | そのエージェントの作業場所とSKILL.md |
| skillsフォルダーとmemoryフォルダー | 再利用できるスキルと蓄積した教訓 |
| ROLES.md | 全エージェントの人物像、責任、他のエージェントへの問い合わせルール、報告系統 |
| SKILL.md | 割り当てられた仕事を進める手順 |
| MEMORY.md | フィードバック、修正内容、過去の失敗 |
スキルは、ClaudeのSkill Creatorで作ることも、手作業でタスクをこなしながら画面を録画し、各手順を口頭で説明して作ることもできます。Claudeのスキル録画機能は、クリック、入力、音声での説明を記録し、繰り返し使えるスキルに変えます。たとえばFramer MotionとReactでスライド資料を作る様子を録画すれば、presentation-appという名前のスキルができます。
フィードバックは一度設定すれば終わりではなく、続けていく仕事です。人と同じように、エージェントも訓練と修正を通じて上達します。MEMORY.mdはこうした教訓を別々の実行にまたがって引き継ぐため、エージェントは同じ失敗を繰り返しません。
▲ 新入社員のようなAIエージェントのオンボーディング
7ステップの構築
チームをSlackにつなぐ作業は7ステップです。バックエンドのコードを書く必要がありますが、特にバックエンドの経験が浅い場合は、Claude Codeを使うと大幅に時間を節約できます。
| ステップ | やること | 注意点 |
|---|---|---|
| 1. アプリを作る | Slackの開発者向けサイトでCreate New Appを押し、エージェントの名前とワークスペースを決める | 誰が見ても分かる名前にする |
| 2. 権限とイベントを設定する | OAuth & Permissionsでボットトークンのスコープを追加し、Event Subscriptionsをオンにして、ワークスペースにインストールする | ボットトークンは非公開にする |
| 3. サーバーを立てる | Node.js、Python、GoでSlackからのリクエストを受けるHTTPSサーバーを作る | Signing Secretでリクエストを検証する |
| 4. モデルをつなぐ | AnthropicかOpenAIでAPIキーを取得し、サーバーにつなぐ | キーはコードに書かず、環境変数に保存する |
| 5. 返答を戻す | モデルの回答を元のスレッドか指定したチャンネルに送る | 状態と文脈はサーバーに管理させる |
| 6. デプロイしてテストする | Vercelなどのプラットフォームにデプロイして公開URLを取得し、チャンネルでボットをメンションする | デプロイ設定にも環境変数を入力する |
| 7. 保守する | エージェントが失敗したら、エラーログをClaude Codeに渡して診断と修正を任せる | 各役割に使うモデルを見直す |
ステップ2では、少なくともapp_mentions:read、assistant:write、channels:history、chat:write、groups:history、im:historyのボットトークンスコープを有効にします。Event Subscriptionsを使うとサーバーがメッセージイベントを受け取れるようになり、誰かが呼びかけたときにボットが動き出します。アプリをインストールすると、xoxb-で始まるBot User OAuth Tokenが発行されます。これは社員証のように扱ってください。漏れれば、その社員証を盗まれたのと同じです。
ステップ3のサーバーは、何かが起きたときに指定のWebアドレスへ自動で送られる通知であるSlackのWebhookを受け取り、モデルを呼び出す処理に渡します。Slack CLIのエージェント用テンプレートから始めることもでき、各リクエストが本当にSlackから届いたものかどうかは、Slackがその確認のために発行する秘密の値であるSigning Secretで確かめます。ステップ4ではOpenAIのGPTモデルも使えますが、この構成ではエージェントの仕事にClaudeを優先して使います。APIキーは公開リポジトリやクライアント側のスクリプトに書かず、サーバーの環境変数に保存します。
ステップ7が重要なのは、エージェントが文脈を見失ったり、指示を無視したり、予期しない実行時エラーを起こしたりすることがあるからです。エラーログをClaude Codeに貼り付け、問題の特定と修正を任せます。ある例では、リサーチ担当エージェントのツール出力が、モデルが一度に扱えるテキストの量であるコンテキストウィンドウからあふれ、「Autocompact is thrashing」というエラーが出ました。Claude Codeはリサーチ担当エージェントのコードを読み、原因を突き止めました。ログさえ渡せば、エージェントが遭遇する技術的なエラーの多くはClaude Codeで直せるとみられます。
ノーコードツールではなく独自のコードを使う理由
視覚的なブロックをつないで自動化を組み立てるノーコードツールは、壊れやすい傾向があります。複数のエージェントが互いにやり取りし、メンバーが増え続ける場合にも限界に突き当たります。独自のバックエンドなら、そうした限界にぶつからずに拡張を続けられます。
生のSlackイベントをモデルのプロバイダーへ直接送るのも避けましょう。自前のサーバーを間に置けば、状態、文脈、独自の記憶を自分で管理でき、基盤となるインフラも自分のものになり、いつでも別のAIプロバイダーに切り替えられます。
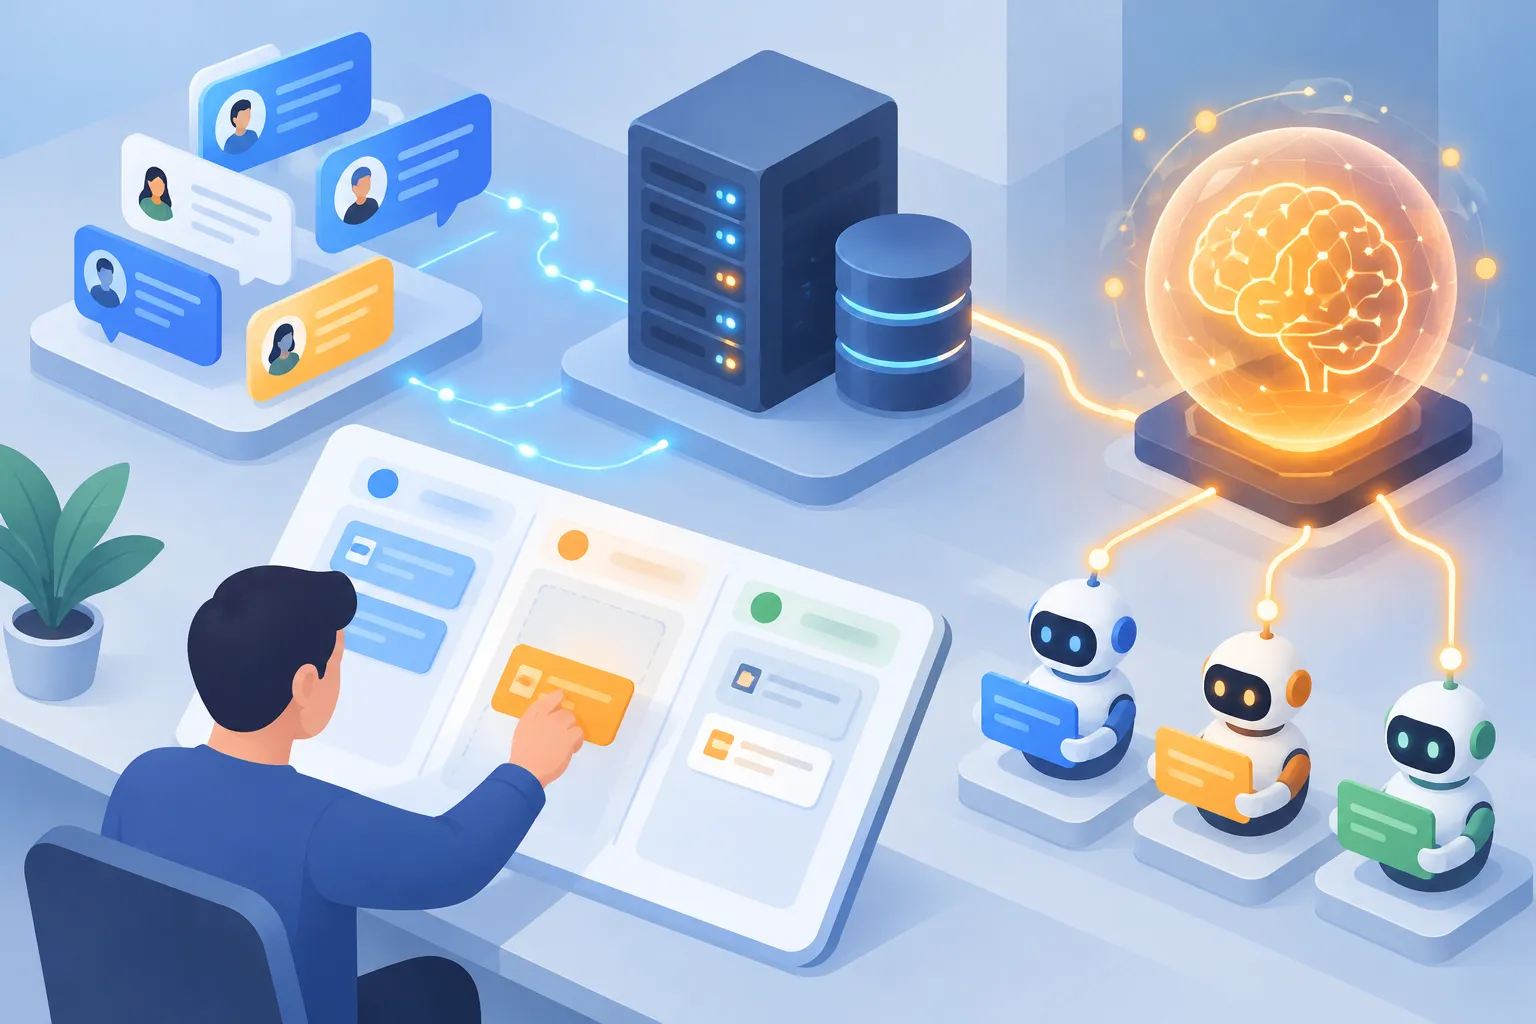
▲ Slack、自前のサーバー、AIモデル
役割に合わせてモデルを選ぶ
すべてのエージェントに最も強力なモデルが必要なわけではありません。単純な反復作業を最上位の推論モデルで動かすと、APIのトークン予算がすぐに尽きます。トークンとは、AIプロバイダーが料金を計算するときの単位となるテキストの区切りです。判断が重要な場面には強いモデルを、量が多く単純な作業には軽いモデルを割り当てます。
| 役割 | モデルの例 | 主な仕事 |
|---|---|---|
| CEOエージェント | Fable 5.1 | 戦略、経営判断、コーディング支援 |
| プロダクト、開発、マーケティング、営業のエージェント | Claude Opus 5.5、Claude Sonnet 5.5、Claude Haiku 5.5 | 役割に応じて割り当て |
| 反復的な単純作業 | Claude Sonnet 5.5、Claude Haiku 5.5 | 量が多く複雑でない作業 |
この構成では、戦略的な推論、経営の役割、コーディングにはFable 5.1が最も賢い選択肢だとみなしています。OpenAIのGPT-5.6 Solも、コーディングや他のエージェントの調整で同じ役割を担えます。
データベースとダッシュボードで規模を広げる
一人で試しているうちは、ローカルフォルダーのファイルで記憶を管理すれば十分です。チーム全体がエージェントに頼るようになったら、その記憶をPostgreSQLのようなクラウド上のリレーショナルデータベースに移しましょう。エージェントのプロフィール、記憶のログ、過去の文脈をセッションをまたいで使えるようになります。その代わり、データベースはフォルダーより中身を見て回りにくく、保守にも少し手間がかかります。
サーバーの上にWebダッシュボードを載せれば、コードを書かない同僚も仕事を割り振れます。タスクを作るときは、期待する成果物、必要なスキル、担当エージェント、優先度と期限、結果を投稿するSlackチャンネルを入力します。
たとえばマーケティング担当のエージェントに、ローンチ文案作成のスキルを付けて次のタスクを送れます。ダークモード機能のローンチ用フックを3つ書き、Xで最近投稿されたダークモードのローンチ投稿から特に優れたものを3つ探してヒントにし、フックをレビュー用に投稿する、というものです。タスクが送られると、エージェントたちは役割に沿って作業し、Slackのスレッドで連携します。
ダッシュボードはチームの状況も記録します。オンラインのエージェント数、完了したタスクと失敗したタスク、成功率、エージェント間の引き継ぎ回数、エージェントごとの処理量、14日間の日別タスク数のグラフです。サンプルのダッシュボードでは7日間で完了69件、失敗4件と表示されていますが、これは社内情報を守るために手を加えたデモデータで、実際の成果を示す数字ではありません。
方向を決めるのは人、単純作業はエージェント
この構成を運用している会社には30人の社員がいて、エージェントと一つのSlackワークスペースを共有しています。人はセンス、創造的な判断、編集面のフィードバックを担います。エージェントはWebスクレイピングや繰り返しの下書きといった付加価値の低い作業を引き受けます。社員はSlackでエージェントに直接話しかけることも、ダッシュボードからタスクを送ることもできます。
この体制をうまく回すための習慣がいくつかあります。
- エージェントを社員のように扱います。実際のタスクと具体的なフィードバックを与えれば、そのフィードバックが記憶ファイルに反映され、仕事ぶりは次第に良くなります。
- 初日から完璧な仕事を期待しないでください。人が主導するフィードバックを繰り返すことで成果は良くなります。
- エージェントのコードを書く前にワークフローを図にします。視覚的なマインドマップにすると、各ステップに必要なスキルと仕事の受け渡し地点が分かります。
- 最初はSlackのボットエージェントを少数だけ用意し、ワークフローを磨いてからチームを広げます。
要点と始め方
Slackのエージェントチームの成否は、配線よりも、エージェントの運営の仕方、つまり与える文脈、役割、記憶にかかっているようです。自前のサーバーは文脈を守り、モデルを自由に切り替えられる余地を残します。役割に合わせたモデル選びはコストを抑えます。始めるには次の手順を踏みましょう。
- 繰り返し発生するワークフローを一つ図にし、エージェントに任せられるステップと、各ステップに必要なスキルを書き込みます。
- エージェントを少数選び、それぞれに名前、肩書き、職務記述書を与えます。
- 会社の文脈ドキュメント、ROLES.md、役割ごとのSKILL.md、MEMORY.mdを書きます。
- 上記の7ステップでSlackと自前のサーバーをつなぎ、ボットトークンとAPIキーは環境変数に保管します。
- 戦略とコーディングは上位モデルに、反復作業はClaude Haiku 5.5かClaude Sonnet 5.5に任せます。
- 結果が出るたびにMEMORY.mdにフィードバックを記録し、ワークフローが安定してからエージェントを増やします。