OpenAI已经把一整套自动化组件分散部署到ChatGPT的多项功能中,合在一起,它们覆盖的正是Zapier等平台以单一月度订阅出售的那块领域。ChatGPT Sites充当全天候在线的服务器,MCP Events和应用触发器负责启动工作流,定时任务(Scheduled Tasks)执行具体工作,Gmail、Slack等已连接应用则是接触真实数据的“手”。这些组件是分别发布的,这似乎正是很少有用户意识到它们构成一个完整系统的原因。对一家典型的小企业来说,实际效果是:一次表单提交或一封进来的邮件,现在就能在ChatGPT内部触发一个后台任务,既不需要单独订阅中间件,也不需要有人守在键盘前。主要的限制在于,目前只有少数第三方应用能够发送这类唤醒事件,而且运行并非即时完成。
任何自动化都离不开的四个部分
无论来自哪家厂商,每一套自动化都需要同样的四个组件:一台全天候监听的服务器;一个在事情发生时触发的触发器;一个保存指令并执行它们的工作器;以及伸进已连接应用、读写数据的“手”。Zapier一类的平台把这四者打包成一款产品,按整套收费。而OpenAI现在把每一项都做成了ChatGPT内部的独立功能。
| 组件 | 作用 | 对应的ChatGPT功能 |
|---|---|---|
| 服务器 | 保持在线,监听入站信号 | ChatGPT Sites,托管在Cloudflare Workers上,配有D1数据库(文档标注为10 GB)和R2对象存储 |
| 触发器 | 启动工作流 | 原生应用触发器(Gmail、Slack、GitHub,8月推出,限符合条件的套餐)与MCP Events(2026年9月29日DevDay上宣布) |
| 工作器 | 保存提示词和技能,被唤醒后运行 | 定时任务 |
| 手 | 在外部应用内执行操作 | 已连接应用插件:Gmail、Google Drive、Docs、Sheets、Calendar、Slack、GitHub |
ChatGPT Sites值得多看一眼,因为它很容易被误认为只是一个用来做小游戏或仪表盘的简易建站工具。实际上它是一台由OpenAI付费托管、带有持久化存储和数据库的服务器。OpenAI的文档指出,用Plugin Creator构建的插件,其底层MCP服务器可以直接托管在一个Site上,而不必放在Vercel或Supabase之类的外部平台。无论一个Site对外展示的是什么界面,它背后都可以接收webhook、校验并存储记录,再向ChatGPT发出信号。
从被动到主动:MCP Events如何运作
MCP即模型上下文协议(Model Context Protocol),是让ChatGPT调用已连接应用中工具的标准。在普通的工具调用里,是ChatGPT发问、应用作答:查一条线索,存一个结果。MCP Events把方向反了过来:由应用向ChatGPT发送入站通知,宣告某件事发生了变化,比如来了一条新的表单提交;这条通知随即唤醒一个早已加载好指令、处于等待状态的定时任务。
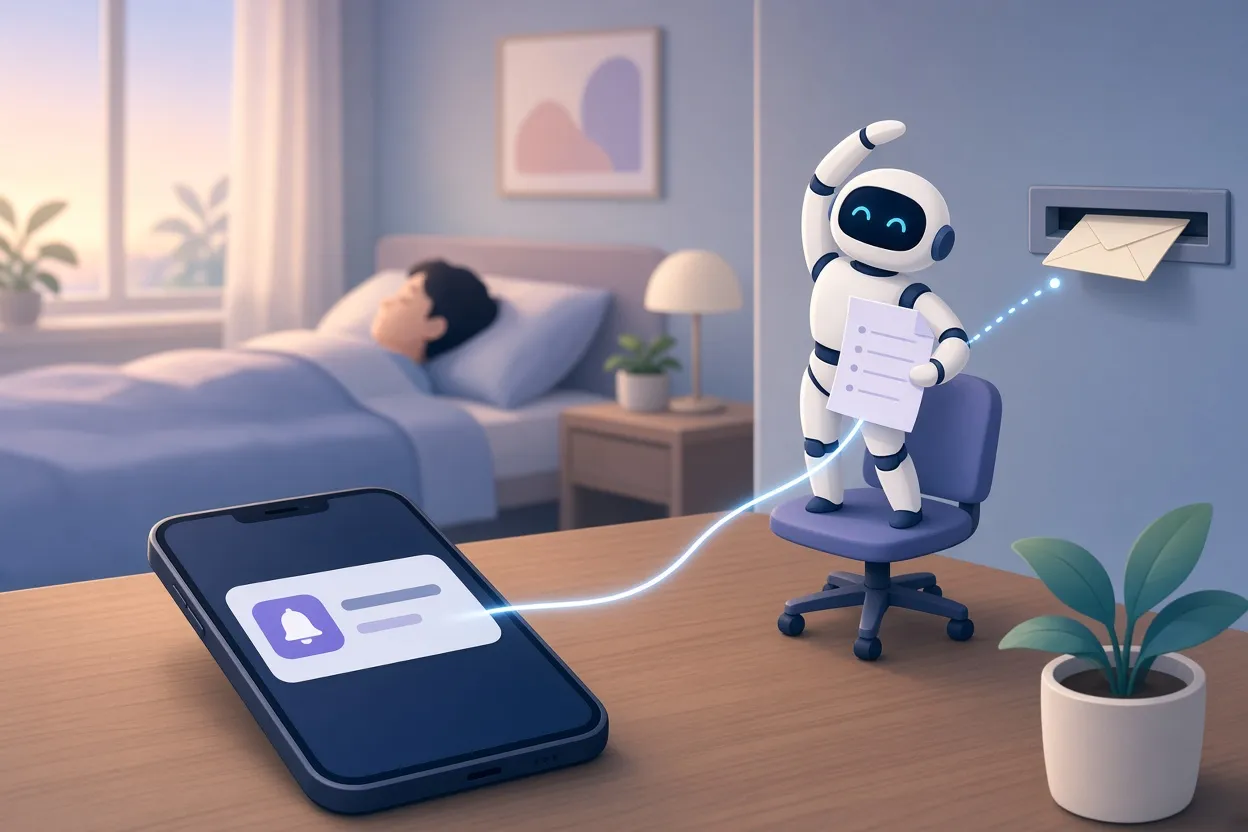
▲ MCP Event唤醒后台任务
用智能手机来类比,这个模型就很好记:ChatGPT是手机,插件是装好的应用,工具调用相当于用户打开应用查看信息,而MCP Events就是推送通知。这个类比还能解释一个常见的配置错误:装好插件并不等于它就能主动行事,正如手机上装了应用并不自动获得通知权限。用户必须在ChatGPT中创建事件订阅,在插件设置里为该插件开启通知,并告诉模型收到提醒时该运行哪个任务。ChatGPT的插件设置会把这些权限连同工具风险等级一起列出,其中包括一个允许低风险工具的控制项。
结果就是一个在用户睡觉或离开时仍在工作的ChatGPT,而不是一个只会等待文字或语音提示的ChatGPT。
一条线索接收工作流的逐步拆解
一个实际运行的例子能说明各部分如何衔接。某网站向所有填写Google表单的人提供一份个性化的AI入门指南,表单需填写姓名、邮箱、业务角色以及希望获得哪方面的帮助。从这里开始,整条链路无需人工介入:
- 潜在客户提交Google表单。
- 一段小型Google Apps Script脚本接收这次提交,把数据转发到托管在ChatGPT Site上的后端应用,该应用运行在一个Cloudflare Worker上。
- 后端保存线索,按业务规则校验各字段,并向数据库写入一条日志。
- 后端通过已有的订阅向ChatGPT发送事件通知。
- 一个基于事件的定时任务被唤醒,读取保存好的指令,对该Site的插件发起MCP工具调用,读取线索详情并更新记录。
- ChatGPT使用已连接的Gmail工具,把定制的入门指南发给这位潜在客户。
有一个设计要点值得注意:Apps Script从不直接与ChatGPT对话,它只和Site打交道,由Site负责MCP交接。让原始webhook先经过一个负责校验和记录的后端,而不是直接送进聊天提示词,能让整个系统保持可控、可审计。
这条流程的管理仪表盘在11月2日的一次快照中记录了:收到10个事件,9次ChatGPT确认,4次已验证的邮件发送,0次失败。日志中的发送耗时从101.9秒到402.0秒不等,邮件工作流完整跑一遍大约需要9分钟。这些是单一配置下的数字,并非基准测试。
第二个例子完全不需要自定义站点,只用原生触发器。一个以管理品牌合作为名的定时任务会在Gmail每收到一封新邮件时触发,运行保存好的提示词和技能,直接在收件箱里打上Creator Hooks、Customers、Sales pitches、Sponsorship等标签。
别把所有请求都送给模型
有了ChatGPT这个随叫随到的工作器,并不意味着每个请求都该交给它。这些配置遵循一条指导原则:凡是可预测的规则能做的事,绝不消耗AI算力。一个网站聊天挂件用三个层级演示了这一点。
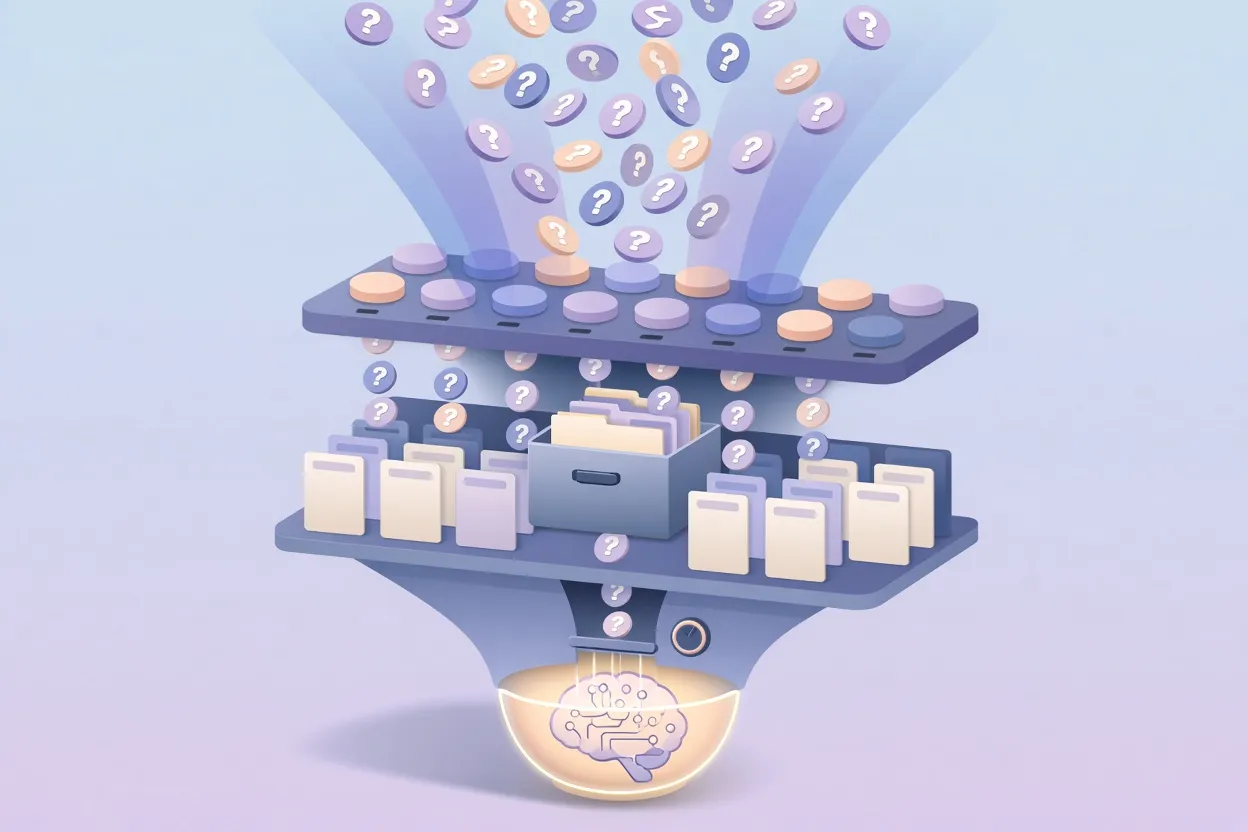
▲ 模型之前的三层分流
| 层级 | 触发条件 | 由谁作答 | 成本 |
|---|---|---|---|
| 1 | 访客点击预设的常见问题 | 本地数据库,即时响应 | 不调用模型 |
| 2 | 访客输入的问题与此前已回答过的问题匹配 | 已存答案,即时响应 | 不调用模型 |
| 3 | 问题与任何内容都不匹配 | ChatGPT,仅限给出经批准的答案、礼貌引导,或留待人工跟进 | 调用模型,受频率上限约束 |
该挂件的安全配置加载了24个经批准的FAQ主题和285种受支持的提问措辞,这正是大多数问题到不了第3层的原因。它还设置了每小时10个、每天40个原生事件的上限,以及每天最多60次回调尝试,使恶意或粗心的访客无法耗尽AI用量额度。同一份配置还声明了对IP和MAC地址的零存储策略。
这种混合模式可以说是本文最值得借鉴的思路:确定性规则和缓存答案承担大流量,模型只处理新出现的情况,而且即便如此也只在狭窄的授权范围内行事。
眼下还有哪些掣肘
最大的瓶颈是普及程度。Shipmail、Bird和Twelfth.ai已经原生发布MCP Events,覆盖邮件投递触发、通讯类webhook,以及对竞品价格和项目变动的监控。但小企业最依赖的几大类应用,包括表单、CRM、日历、电商店铺、社交媒体、社区软件、支付处理商和客服工单系统,尚未跟上。在它们跟上之前,仍需要Apps Script加Site后端这样的桥接,而这恰恰是自动化平台本来就是为了消除的那类胶水工作。一旦某款应用原生支持MCP Events,桥接就消失了:把应用连到ChatGPT,开启通知,定义任务即可。
在替换掉一款付费工具之前,还有几项限制值得了解:
- 运行并非即时。上面的邮件工作流端到端大约需要9分钟。
- 托管在ChatGPT Sites上的计划任务,在测试中大约每小时执行一次。
- 文档记载的MCP Events可用范围为:ChatGPT网页版的工作聊天、选择了Cloud的桌面应用,以及Dots。
- 整套功能分散在Sites、应用触发器、MCP Events、定时任务和插件之中,Cloudflare Worker这一层又被抽象掉了,因此Site与其插件之间的关系起初可能令人困惑。
高阶自动化从业者和开发者多半会继续使用专门的企业级工具。需要亚分钟级延迟、高频调度,或者要连接尚不支持事件的应用的工作流,看起来仍是独立平台及依托其上的代理机构的地盘。
可以从中得到什么
OpenAI已经把服务器、触发器、工作器和“手”都装进了ChatGPT。对收件箱分拣、表单驱动的跟进、网站聊天这类常见的小企业流程而言,这可能让单独订阅中间件的理由不复存在。目前的缺口是真实存在的:发出MCP Events的应用很少,一个周期要花几分钟,每小时一次的调度也限制了Sites独立完成的工作。
如果你已经同时为ChatGPT和一款自动化工具付费,一条稳妥的路径是盘点现有工作流并加以分类。从Gmail、Slack或GitHub发起的流程,今天就能迁移到原生触发器和定时任务上。从表单或其他尚不支持的应用发起的流程,如果你愿意维护一段小小的信使脚本,可以经由Site后端运行,否则就留在原处,等服务商加入事件支持。无论哪种情况,都应把规则和已存答案放在模型前面,限制事件到达模型的频率,并把指令保存为提示词和技能,而不是临时的聊天消息。对延迟敏感或尚不支持的部分,继续留在付费平台上,并随着更多应用采用MCP Events,重新审视这一划分。


