在Mintlify为客户运营的开发者文档网站上,大多数访问者已经不再是人。如今,AI智能体约占这些网站流量的80%,一年前这一比例约为15%;直接来自人类浏览器的请求只剩约五分之一。照常理推断,接下来似乎就该把文档改造成写给机器看的样子。Mintlify首席执行官的主张却恰恰相反:文档仍应围绕人类的理解来设计,再在其上叠加对智能体友好的功能。本文梳理这一建议背后的逻辑,以及开发API和开发者工具的团队现在可以做些什么。
变化背后的数字
Mintlify为2万多家企业提供文档和知识库服务,其网络每月吸引超过1亿名访问者。在这样的规模上发生的变化,很难被当作小众趋势一笔带过。
| 指标 | 数字 |
|---|---|
| 文档运行在Mintlify上的企业 | 超过2万家 |
| Mintlify支持的网站每月访问者 | 超过1亿名 |
| 一年前AI智能体的流量占比 | 约15% |
| 目前AI智能体的流量占比 | 约80% |
| 直接来自人类浏览器的请求 | 约20% |
这样的数字迫使人们回到一个基本问题:文档究竟是写给谁看的?这位首席执行官表示,智能体占比达到80%,从根本上改变了软件公司构思和打造产品的方式。
不过,人类读者并没有消失。即便智能体流量增长了几个数量级,访问文档网站的人数绝对值仍在上升。进入科技行业的开发者比以往任何时候都多,他们依然需要为人编写的内容。人类在流量中已成为少数,但从绝对数量看,这仍是一个不断壮大的读者群。
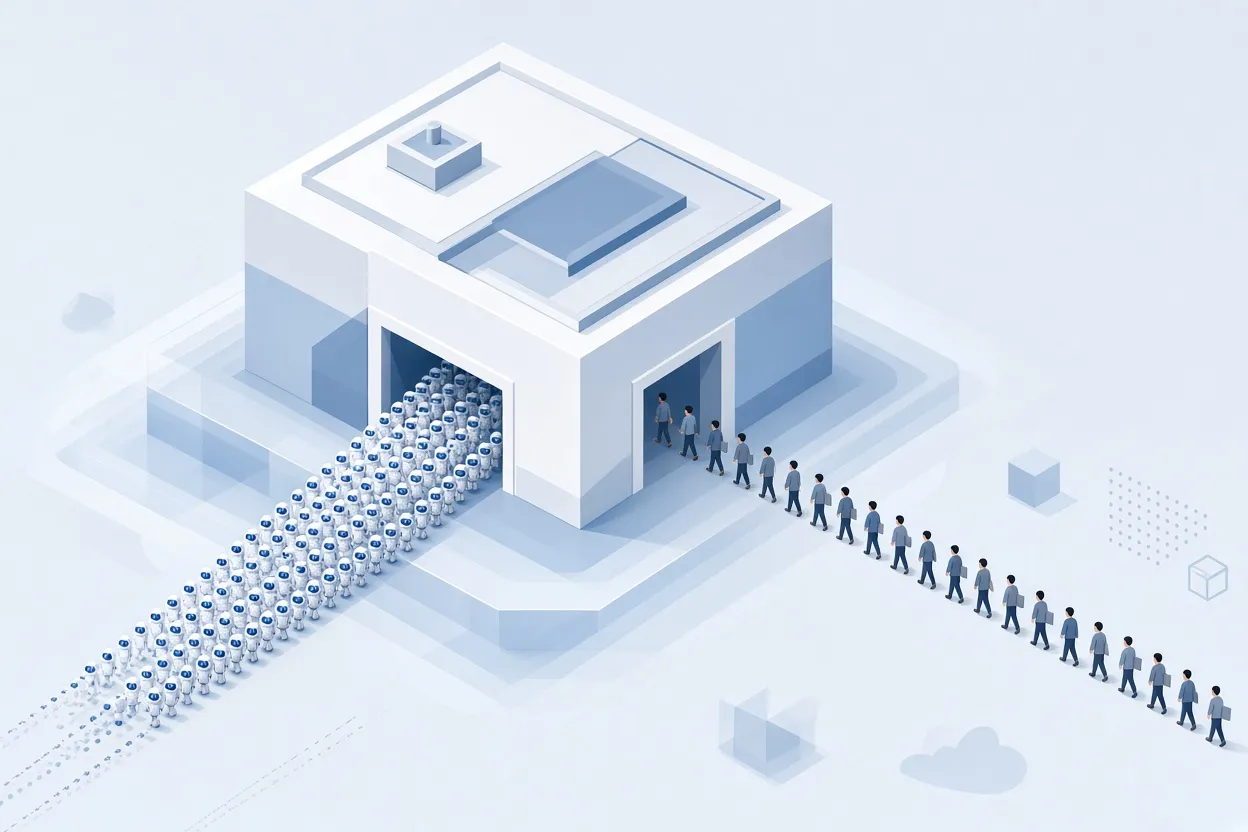
▲ 同时增长的智能体与人类访问者
只面向智能体的文档为何适得其反
面对80%这个数字,一些企业可能会想停止在人类阅读体验上的投入。最极端的做法,是只为智能体准备一个巨大的原始Markdown文件,并把聊天窗口作为唯一入口。这位首席执行官称之为一种常见的过度反应。
实际上,只提供面向智能体的文档或只提供聊天式文档的产品,会让人很难判断产品究竟能做什么。由此会引发一连串连锁反应:
- 工程师浏览文档也无法弄清产品的功能。
- 他们不去试用,也不会向同事推荐。
- Reddit、开发者论坛和博客上很少积累正面评价。
- 依赖这些公开讨论的AI智能体同样不会推荐该产品。
最后一步或许最不容易被察觉。智能体本身没有偏好,它们反映的是人类开发者社区的共识,并经过训练数据和所检索的搜索索引过滤。因此,生成式引擎优化(GEO),即让产品出现在AI生成的回答和推荐中的工作,取决于人类开发者在公开场合说了什么。在这位首席执行官看来,赢得这些开发者的支持依然是首要任务。
此外还有一个问题:智能体究竟为谁服务。智能体代表人行事,而不是独立的经济主体。智能体要做出有用的工作,人首先得知道该问什么、该如何编写提示词。要信任结果,人还需要透明的来源、可供验证的链接以及能够自行核查的信息。这位首席执行官把放弃面向人类的文档比作放弃书本:在生成式AI时代,人们依然在读书、浏览网站。
代码交给智能体,技术栈仍由人来选
对照智能体如今承担的工作和人仍在做的决定,就能理解为什么文档必须继续说服人类。
| 工作类型 | 示例 | 由谁负责 |
|---|---|---|
| 底层实现 | 样板代码、端点查询、细小的语法细节 | 已大量由AI编程智能体自动完成 |
| 高层决策 | 选择Supabase、ClickHouse或AWS等核心基础设施 | 由人类工程负责人最终拍板 |
基础设施的选择涉及资金投入、性能取舍和长期业务后果,因此人们仍坚持亲自决定。据这位首席执行官介绍,包括Anthropic的Claude团队在内,多家前沿AI实验室团队的反馈也指向同一方向:一旦涉及资金或关键承诺,智能体仍会向人寻求判断。
在生成应用基本结构的脚手架阶段,一些供应商选择已经逐渐淡出人们的视线。例如,Lovable可能会自行决定为应用接入Supabase数据库,并把费用合并到一张账单里。如果让Claude Code在不连接GitHub或任何其他账号的情况下构建一个可运行的应用,项目最终可能会被部署到一个公开的Vercel网址上。智能体还常常在预先设定的指令、提示词和harness(驾驭智能体运行的软件外壳)下工作,而这些设定会偏向特定的供应商和托管配置。
即便如此,这位首席执行官并不认为开发者平台会沦为无名的底层管道。一旦原型发展为团队或企业级项目,仍需要有人主动选择,并在Vercel这样的托管服务商那里开设付费账户。商业软件既需要有人为账单负责,也需要一家让此人信任的供应商。未来,配备数字钱包和预设支出上限的智能体或许能跳过这一步,但就目前而言,由人做决定的环节依然存在。
适合智能体的文档究竟是什么样
不少工程团队找到Mintlify,希望获得一些复杂的架构技巧,让文档便于智能体读取。也有团队担心,用Docusaurus这类较早的框架搭建的文档,在智能体工作流中无法被顺利解析。这位首席执行官的回答很简单:把文档写得更好。
原因在于智能体的阅读方式。大语言模型(LLM)以及基于它构建的智能体,吸收技术信息的方式从根本上与人类工程师相同,只是速度快得多、读得多得多。它们依靠上下文线索、直观的章节层级和清晰的概念组织来浏览API,并生成正确的实现。
这就是把所有内容一股脑儿丢给它们会适得其反的原因。把文档转换成巨大的原始JSON文件,或者交出整个未经整理的代码仓库,都无济于事。Mintlify的研究发现,与分段清晰的内容相比,篇幅庞大、缺乏结构、疏于维护或被截断的文档会严重拖累智能体的表现。智能体理解得更少,产生的幻觉代码也更多,也就是看似合理、实则错误的代码。
llms.txt是一种为语言模型概括网站内容的纯文本文件,Model Context Protocol(MCP)服务器则把AI模型连接到外部工具和数据,这类标准都很有用。不过,团队常常把它们当作灵丹妙药,而它们无法弥补不准确、缺失或过时的内容。
| 不要这样做 | 改为这样做 |
|---|---|
| 发布一个巨大的Markdown或JSON文件 | 把文档拆分为清晰、条理分明的章节 |
| 把整个代码库交给智能体 | 提供整洁的文档和经过验证的代码示例 |
| 只依赖llms.txt或MCP服务器 | 先确认内容准确且最新 |
| 只提供聊天界面 | 保留便于人快速浏览的快速入门和图示 |
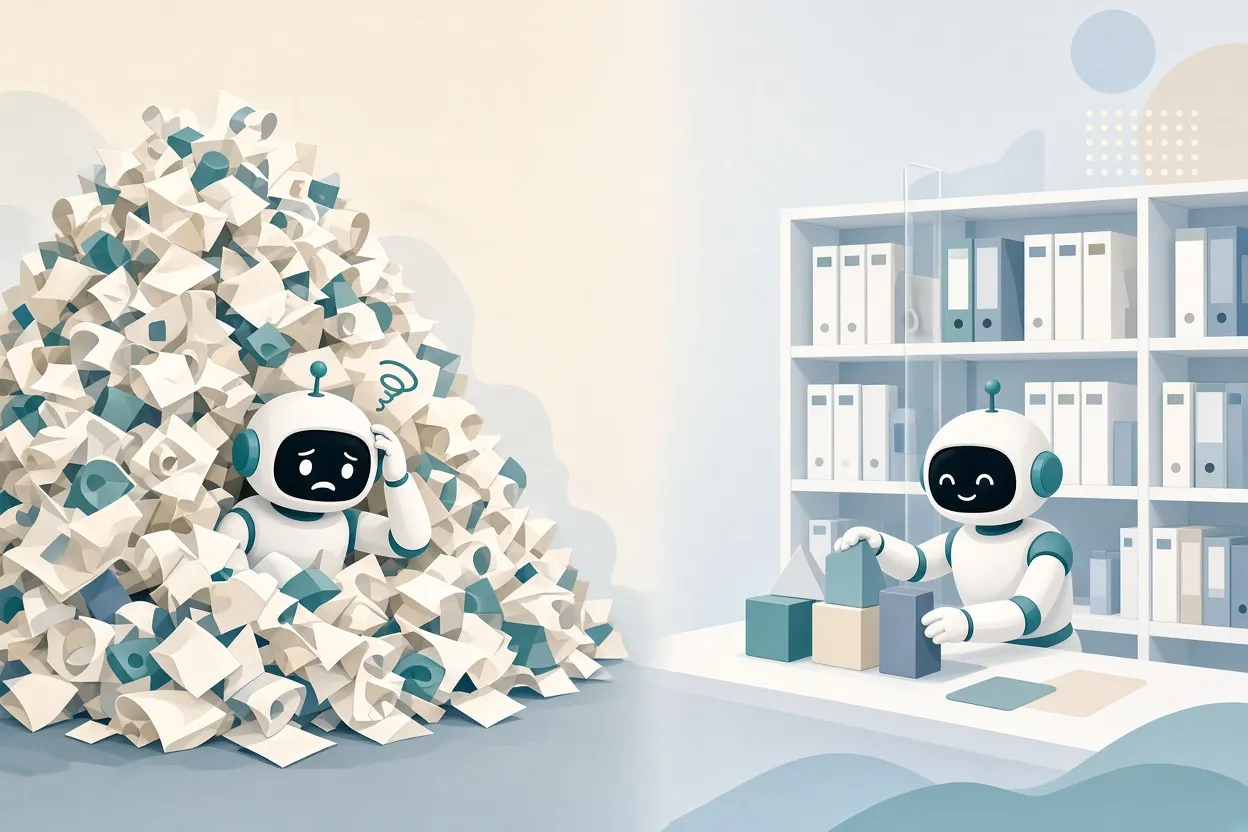
▲ 整包倾倒与分段文档的差别
初稿交给智能体,方向由人把握
过去一年里,由谁来写文档也发生了变化。工程团队正以创纪录的速度发布更新、新的SDK(软件开发工具包)和API变更,技术写作者几乎不可能靠手工让文档保持最新。智能体正在成为主要的起草者和维护者。
这位首席执行官认为,这并不意味着技术写作者或开发者关系(DevRel)人员会被淘汰。代码完全按字面执行,因此仍需要人来阐明产品的用途以及整体系统的设计。而且,智能体会大量阅读文档来为用户构建应用,清楚说明产品行为、SDK集成步骤和使用场景比以往任何时候都更重要。
工作重心正从逐句撰写转向把握方向:
- 筛选和整理客户案例
- 定义边界情况
- 指导智能体的产出
展望一年后,这位首席执行官预计文档工作将变得更加自主,人则承担监督和把握方向的角色。Mintlify正在开发可自动更新的文档:智能体会监控代码仓库、发现变更,并在更新内容不明确时向工程师提出有针对性的澄清问题。目的是让文档与实际发布的软件保持同步。
现在该做什么
智能体如今或许已是开发者文档的最大读者群,但好文档的标准几乎没有改变。便于人阅读的文档同样适合智能体,而人类开发者推荐什么,也会影响智能体推荐什么。对于开发API或开发者工具的团队,可以参考以下实用清单:
- 准备快速入门、图示和经过验证的代码示例,让人能迅速评估产品。
- 把文档拆分为分段清晰的章节,让层级和上下文线索一目了然,并写明使用场景和SDK集成步骤。
- 先确认内容准确且最新,再加上llms.txt和MCP服务器等面向智能体的功能层。
- 让来源和参考资料清晰可见,方便人核查智能体的输出。
- 持续投入,在论坛、Reddit和博客上赢得开发者的支持。
- 让智能体起草和更新文档,把人的时间用在产品意图、客户案例和边界情况上。
智能体占到80%这一数字,与其说是开始为机器写作的信号,不如说表明文档质量如今同时左右着人和智能体的选择。