Yutori的Navigator n2表明,评估计算机操作智能体时,需要同时考量成本和可靠性。这款270亿参数模型在五项计算机操作基准测试中的四项排名第一,在OSWorld-v2上的单任务API成本约为$1.46。它结合了基于视觉的计算机操作、代码执行和直接调用服务,并通过递归训练流程将智能体的失败案例转化为新任务。
基准测试数据说明了什么
在OSWorld-v2上,Navigator n2的部分准确率得分为65.2%,以微小差距位居第二。该基准测试包含估计需要人工花费一到两小时完成的桌面任务。公布的成本对比将n2与Claude 3.5 Sonnet、Claude Opus和GPT-4o等前沿模型列在一起:
| OSWorld-v2对比 | 公布的结果 |
|---|---|
| Navigator n2 | 单任务API成本约$1.46;部分准确率为65.2% |
| 对比的前沿模型 | 单任务API成本约$15至$40多 |
在准确率相当的情况下,对比中的前沿模型成本约为n2的10倍。在相同的成本预算下,n2的任务完成准确率则达到它们的三倍以上。这些是基准测试结果对比,并不保证每次部署都能达到相同的成本或成功率。尤其需要注意的是,$1.46指单任务API成本,而非训练模型所需的算力成本。
Yutori列出的Navigator n2 API价格为:每百万输入token $0.50,每百万缓存输入token $0.05,每百万输出token $4.00。token是模型处理文本的单位。这些费率也是估算工作负载成本的依据,但对于可能执行许多操作的智能体,基准测试中的单任务成本是更直接的对比指标。
为计算机操作选择合适的方法
Navigator n2是一款计算机操作智能体:它不仅能浏览网页,还能跨桌面软件和浏览器工作。其核心设计是在同一任务中切换操作方法。它可以查看并操作图形用户界面(GUI),编写并运行Python或shell命令来处理结构化工作,也可以在服务提供直接的软件连接时使用应用程序编程接口(API)。
当网站没有可用的API,或信息只存在于像素中时,这种区分尤为重要。一个涉及50至60页扫描版年度报告的任务展示了不同方法如何分工。由于PDF没有文本层,Navigator n2先通过图形界面查看以图像形式呈现的财务表格。随后,它使用终端和Python脚本,将数据与计算结果整理到Excel工作簿中。最后,它在LibreOffice Calc中打开文件,目视比对电子表格与扫描报告。
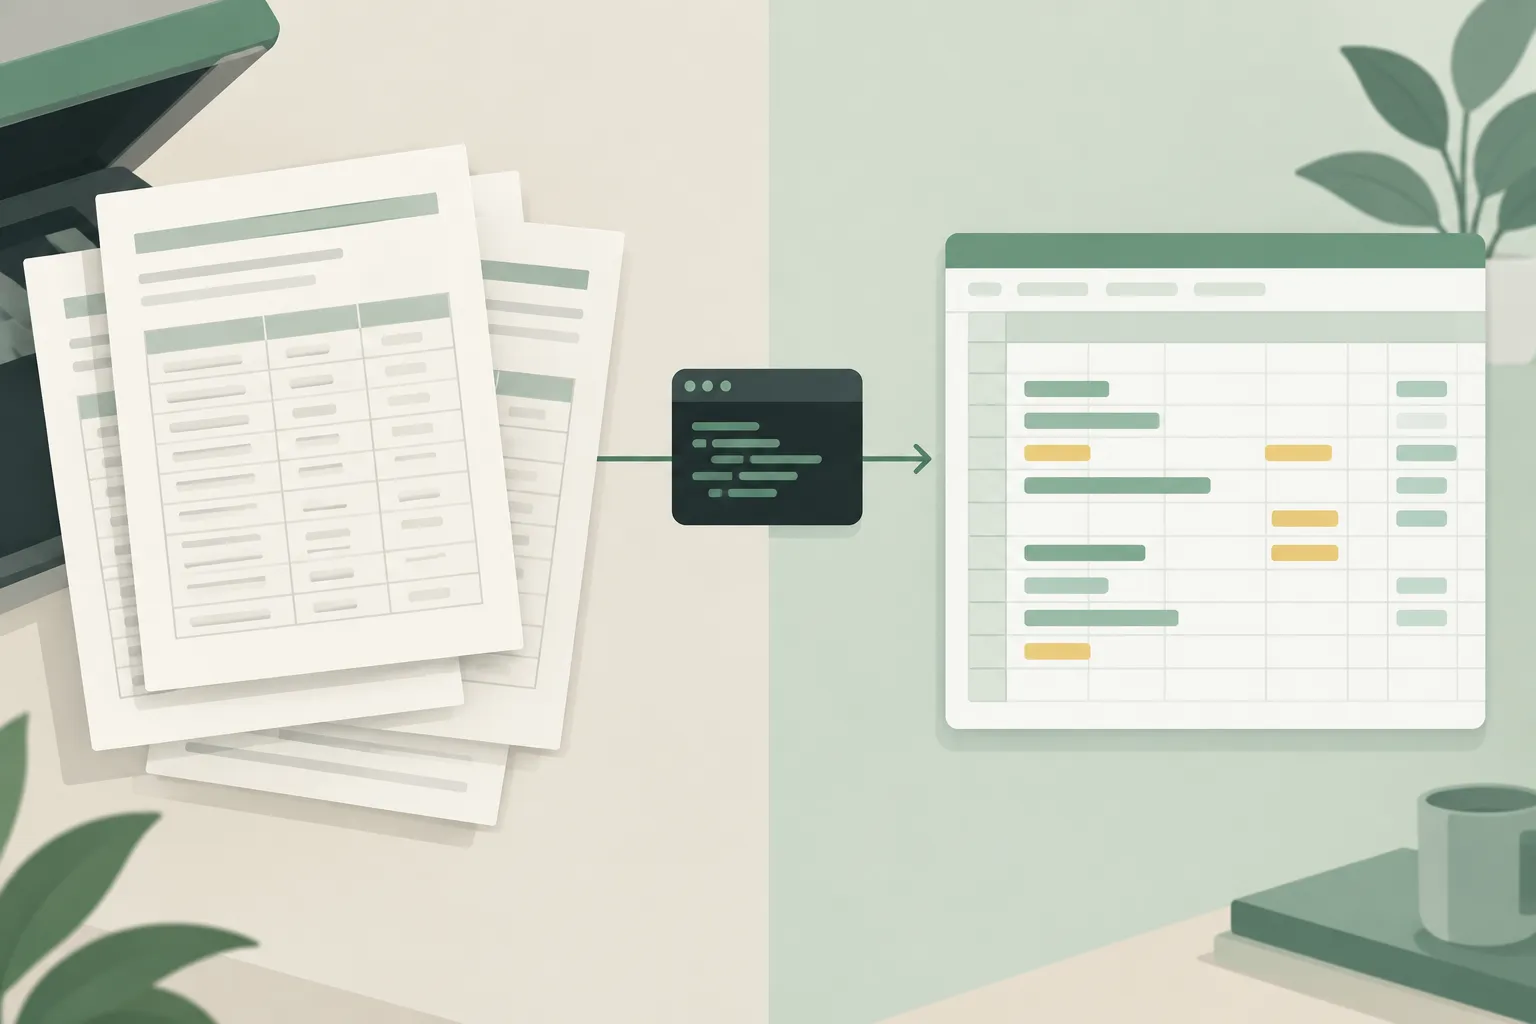
▲ 从扫描报告到电子表格
用代码制作工作簿避免了在图形界面中逐个单元格录入,但任务开头和结尾仍需要目视检查。同样的灵活性也适用于网页界面:Navigator n2同时利用屏幕像素和结构化页面数据,因此即使页面没有提供可用的无障碍访问条目,它也能识别可见控件。重点不是完全取消点击,而是只在任务确实需要时才点击。
围绕真实失败案例建立训练循环
公布的成本和性能结果不只是执行策略的产物。Yutori在递归数据流水线的各个环节使用计算机操作智能体和编程智能体,而不只是让它们运行训练完成的模型。在数周内,这条流水线围绕数百款桌面和浏览器应用,生成了超过1万个经过验证的任务及环境。
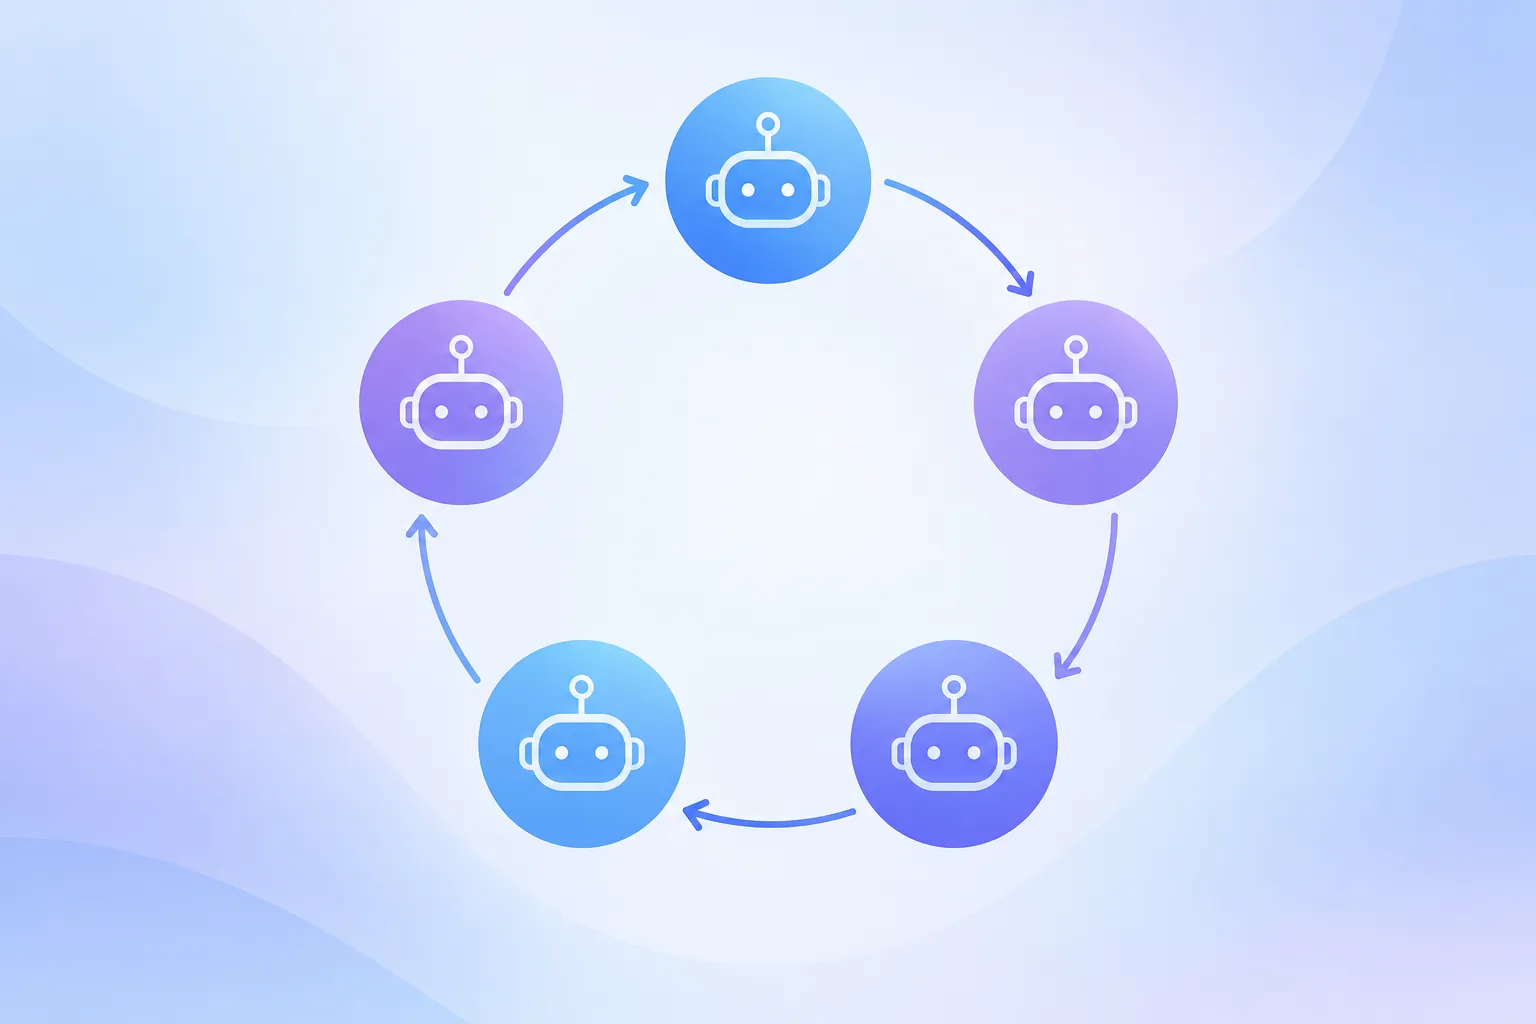
▲ 递归任务与训练闭环
这一循环包含五个相互衔接的阶段:
- **任务创建:**智能体探索真实的虚拟机环境,并创建任务,同时编写脚本检查预期结果是否达成。虚拟机是一种基于软件的计算机,在这里用作任务环境。
- **压力测试:**通过多次尝试,检查这些验证脚本是否会误判通过、误判失败,环境是否存在缺陷,以及能否在未实现任务意图的情况下通过测试。
- **模型训练:**成功完成的任务为微调提供样本;强化学习则通过进一步尝试测试并改进模型行为。
- **失败分析:**智能体汇总已完成尝试中的错误,找出反复出现的能力短板,例如电子表格脚本编写能力不足或幻灯片格式处理不佳。
- **下一轮生成:**根据这些短板确定下一批任务和验证脚本。
验证环节尤其重要。如果有缺陷的测试把未完成的结果判为成功,训练就可能强化错误行为。因此,审核成功的任务运行结果并剔除存疑样本,可能比尽可能增加样本数量更重要。
从偶尔成功到稳定完成
Yutori交替使用两种训练方法。拒绝采样微调(RFT)从大量任务运行中挑选成功尝试用于训练。它用于培养基础能力并提高pass@k,即多次尝试中至少成功一次的概率。当初期任务太难、无法产生成功尝试时,在提示词中加入简短提示可以帮助生成样本,但之后仍需仔细审核。
强化学习(RL)旨在将这种潜力转化为更强的pass@1表现,即首次尝试就成功。它还让智能体接触意外弹窗、程序崩溃和延迟,从而学习如何恢复。Yutori在这一阶段保留难度居中的任务,剔除模型总能完成和从未完成的任务。介于两者之间的任务能提供更有用的学习反馈。
在强化学习阶段,Yutori使用Miles框架实施异步组相对策略优化(GRPO)。在这一设置下,任务尝试与模型更新并行进行,同时对训练所用尝试的滞后程度设限。动态采样会随着模型能力提高调整任务组合。Yutori还使用fp16这种16位数值格式进行训练,以匹配推理时的配置,避免训练与部署之间出现精度不一致。
采用智能体前应检查什么
有价值的评估不应止于单项基准测试得分。开发者和企业可以先比较达到所需质量标准时完成一项任务的成本,再检查智能体是否选用了合理的工具、能否从错误中恢复。较低的token费率本身并不能说明整个工作流的成本。
任务类型同样重要。提供API的服务可能适合直接调用API;数据转换可能适合使用脚本;面对扫描材料或没有API的网站,图形界面操作可能不可避免。对于能够购物或提交表单的智能体,支出上限和明确的审批边界值得重视。对意外发生的自主购买行为应由谁负责,仍是一个未解决的问题;网站也可能设置反机器人防护措施,影响自动化工作流能否运行。
核心结论
Navigator n2的结果表明,专用模型可能在高难度计算机操作任务中具备竞争力,同时降低基准测试报告的单任务成本。其训练循环提供多样且经过验证的任务;其执行策略则让它根据需要选用图形界面、代码或API。部署前,应在实际需要的工作流中测试这一组合,衡量单任务成本、任务结果、工具选择和错误恢复能力,而不只是看基准测试排名。