Anthropic이 Claude 학습용 데이터를 확보하기 위해 종이책을 대량으로 사들인 뒤 책등을 잘라 낱장으로 스캔하고 원본은 폐기한 내부 사업, 이른바 'Project Panama'가 알려지면서 AI 업계의 데이터 확보 방식이 다시 도마에 올랐습니다. 2025년 6월 미국 법원은 합법적으로 구매한 책을 스캔해 학습에 쓰는 것을 fair use(공정 이용)로 인정했습니다. 그런데도 이 일이 많은 사람에게 불편하게 다가오는 이유는, 법적 판단과 별개로 '희귀본과 절판본이 데이터로 바뀌는 순간 무엇이 사라지는가'라는 질문이 남기 때문입니다. 이 글에서는 Project Panama의 경위와 법원 판단을 정리하고, 2022년 이전에 인쇄된 책이 왜 AI 기업에 특별히 귀한 자원이 되었는지, 그리고 이 과정이 창작 생태계에 어떤 신호를 보내는지 짚어 봅니다.
창고에서 벌어지는 일: 자르고, 스캔하고, 버린다
작업 방식 자체는 단순합니다. 창고에 설치된 전용 기계가 두꺼운 책의 접착된 책등을 잘라 내고, 분리된 낱장을 빠른 속도로 스캔합니다. 글자가 디지털 텍스트로 바뀌어 대형 언어 모델의 학습 데이터에 흡수되고 나면, 종이는 재활용 통으로 향합니다. 이 공정이 고서와 희귀본에도 똑같이 적용된다는 점이 논란의 출발점입니다.
이 방식이 가능해진 법적 배경에는 Google의 도서 스캔 사업이 있습니다. 2015년 10월 미국 항소법원은 Google의 도서 스캔 프로젝트를 합법이라고 판단했고, 이 판례가 지금 AI 기업들이 기대는 기준선이 되었습니다. 최근 18개월 동안 법원은 저작권법을 폭넓게 해석해, 기업이 상업적 기계 학습을 위해 물리적 책을 파괴하는 것까지 허용하는 방향으로 판결해 왔습니다. AI 기업의 수요로 고서 구매가 급증했다는 보도도 잇따랐습니다.
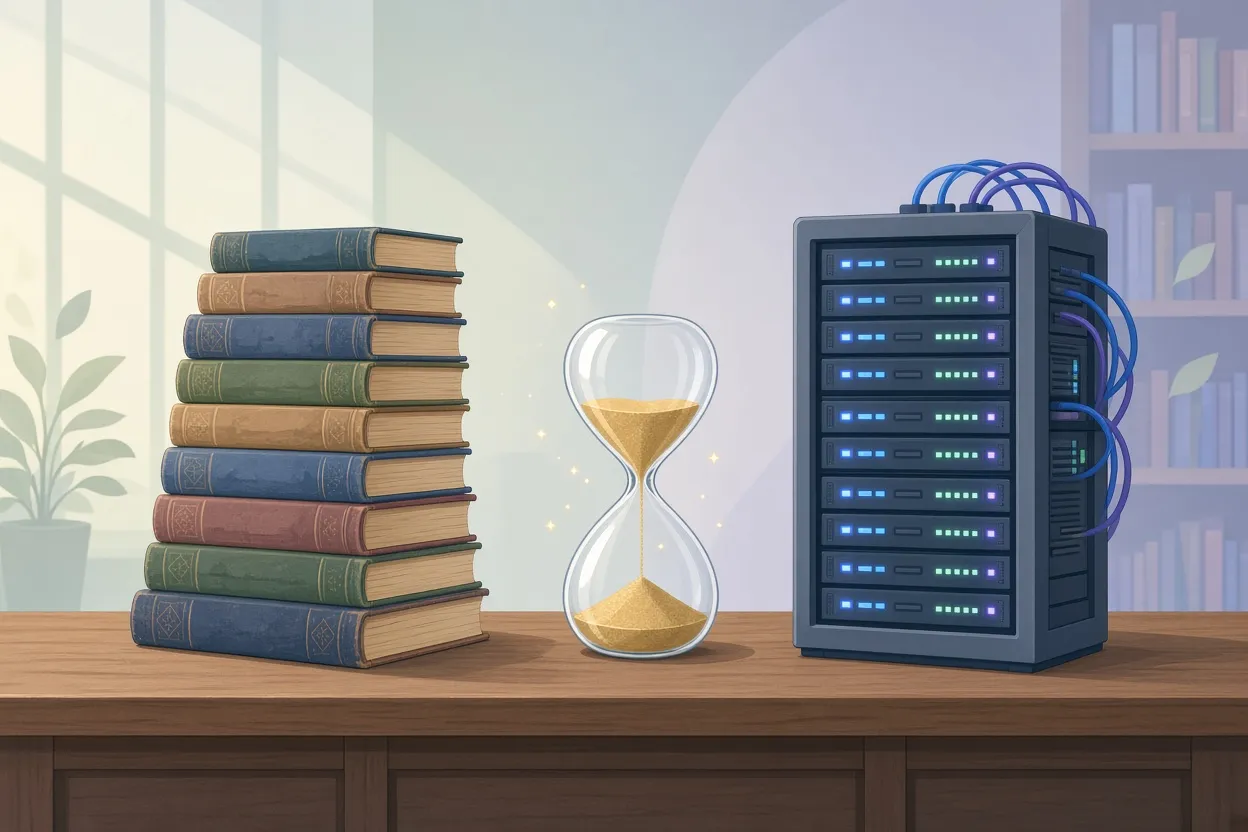
▲ 종이책에서 학습 데이터로
Project Panama: 왜 2022년 이전 책인가
Anthropic은 2024년 초 대량의 책을 확보해 디지털화하는 것을 목표로 Project Panama를 시작했습니다. 이 사업을 이끌기 위해 Google Books에서 파트너십을 총괄했던 인물을 영입했다는 점에서, 처음부터 Google의 경험을 참고한 기획이었다고 볼 수 있습니다.
눈여겨볼 대목은 책을 고르는 기준입니다. Project Panama는 2022년 이전에 인쇄된 책을 우선했습니다. 2022년은 ChatGPT가 등장한 해입니다. 그 이전에 인쇄된 책은 AI가 생성한 문장이 섞여 들어갔을 가능성이 없는, 사람이 처음부터 끝까지 쓴 글이라는 것이 보장됩니다. 업계에서는 AI가 만든 저품질 텍스트를 'slop'이라고 부르는데, 모델이 다른 모델의 산출물을 학습하는 일을 피하려면 이런 오염이 없는 원천 자료가 필요합니다. 종이책, 그중에서도 ChatGPT 이전에 나온 책은 그 조건을 가장 확실하게 충족하는 자원입니다.
여기서 역설이 생깁니다. 사람의 손으로만 쓰였다는 바로 그 가치 때문에 책이 귀해졌는데, 그 가치를 뽑아내는 과정에서 책 자체는 사라집니다.
| 구분 | 내용 |
|---|---|
| 시작 시점 | 2024년 초 |
| 대상 | 2022년(ChatGPT 등장) 이전에 인쇄된 책 |
| 선정 이유 | AI 생성 텍스트가 섞이지 않은 순수한 사람의 글 |
| 처리 방식 | 대량 구매 후 책등 절단, 낱장 스캔, 원본 폐기 |
| 책임자 | Google Books 파트너십 총괄 출신 영입 |
법원이 그은 선: 구매한 책은 되고, 해적판은 안 된다
작가 Andrea Bartz, Charles Graeber, Kirk Wallace Johnson은 AI 학습에 자신들의 책이 쓰였다며 Anthropic을 저작권 침해로 제소했습니다. 2025년 6월에 나온 판결은 둘로 갈렸습니다.
- 합법적으로 구매한 종이책을 스캔해 학습에 쓴 것은 fair use로 보호됩니다. 책에 담긴 사상 자체는 보존되었다는 것이 근거였습니다.
- 반면 약 700만 권의 해적판 책을 학습에 사용한 것은 위법으로 판단했습니다.
해적판 사용에 대해 Anthropic은 $15억 규모의 합의금을 부담하게 되었습니다. 이 금액은 AI 학습 과정에서 벌어진 지식재산 침해에 대한 일종의 '기준 가격'이 되었다고 볼 수 있습니다. OpenAI, Meta, Google, Midjourney 등을 상대로 수십 건의 저작권 소송이 진행 중인데, 이들 소송이 모두 이 합의금을 참조점으로 삼게 되면서 frontier lab(최첨단 모델을 개발하는 소수의 AI 연구소)들에는 지급 능력 자체가 흔들릴 수 있는 위험 요인이 되었습니다.
다만 이 판결이 남긴 구도는 분명합니다. 기업이 책을 사서 스캔하고 학습하는 것은 fair use이지만, 개인이 디지털 사본을 공유하면 불법 복제로 처벌받습니다. 같은 저작물을 두고 자본력에 따라 허용 범위가 달라지는 것처럼 보이는 이 구도가, 판결이 합법이라고 말했는데도 불편함이 가시지 않는 첫 번째 이유로 보입니다.
데이터가 된 뒤에 남는 것과 사라지는 것
두 번째 이유는 더 근본적입니다. 법원은 '사상이 보존되었다'고 봤지만, 책은 사상만으로 이루어진 물건이 아닙니다. 희귀본이나 절판본의 경우 스캔이 끝난 뒤 폐기되는 그 한 권이 세상에 남은 마지막 원본일 수 있습니다. 텍스트는 서버에 남더라도 종이, 판형, 인쇄 상태, 소장 이력 같은 물리적 기록은 함께 사라집니다.
이 과정을 농작물 수확에 빗대는 시각이 있습니다. 코코넛은 수확해도 다시 자라지만, 인간의 지식과 그 기록물은 한번 사라지면 다시 자라지 않는다는 것입니다. 이런 관점에서는 파괴적 스캔을 역사 속 권위주의 정권의 분서와 비교하기도 합니다. 겉모습은 다르지만, 지식의 통제권이 소수의 사적 기업에 집중된다는 점에서 닮았다는 해석입니다. 이는 강한 가치 판단이 담긴 비유이고, 법원의 판단과는 결이 다릅니다. 하지만 이 비유가 나오는 이유 자체는 짚어 볼 만합니다.
AI 기업들은 모델이 사람 학생처럼 책을 읽고 배운다고 설명해 왔습니다. 이에 대해 실제 공정은 학생의 독서라기보다 원자재를 투입해 제품을 뽑아내는 산업 조립 라인에 가깝다는 반론이 있습니다. 학생은 책을 읽고 나서 책을 버리지 않지만, 이 공정은 읽는 순간 책을 소모합니다. 어느 쪽 설명이 더 적절한지는 독자마다 판단이 다를 수 있지만, 적어도 '학습'이라는 말이 두 가지 매우 다른 과정을 가리키고 있다는 점은 분명해 보입니다.
▲ 구매 도서와 해적판의 법적 차이
창작 시장에 보내는 신호: Getty Images의 사례
책만의 문제가 아닙니다. Getty Images는 수십 년에 걸쳐 워터마크로 보호되는 세계적인 사진 arXiv와 라이선스 카탈로그를 구축해 왔습니다. 이 회사는 Stability AI가 자사 카탈로그를 긁어모아 이미지 생성 모델을 학습시켰다며 소송을 제기했습니다. 그러나 저작권을 지키기 위해 싸우는 동안 시장이 먼저 바뀌었습니다. 디자이너와 기업 고객이 전통적인 스톡 이미지 구매에서 값싼 생성 AI 대안으로 빠르게 옮겨 갔고, Getty Images는 2026년 10월 미국 파산법 11장에 따른 회생 절차에 들어갔습니다.
이 사례는 두 가지를 보여 줍니다. 하나는 저작권 소송에서 이기든 지든, 생성 AI가 시장 수요 자체를 바꾸면 창작물 arXiv의 사업 모델이 버티기 어렵다는 점입니다. 다른 하나는 수십 년에 걸친 선별과 보존 작업이 산업 규모의 scraping(웹이나 데이터베이스에서 자료를 자동으로 긁어모으는 일) 앞에서 쉽게 가치를 잃을 수 있다는 점입니다.
책과 사진을 함께 놓고 보면 하나의 패턴이 드러납니다. 작가는 자기 책의 마지막 사본이 어떻게 처리되는지 통제하지 못하고, 사진가는 수익과 출처 표시를 잃습니다. 창작자의 작업물이 보상 없이 상업 모델의 성능 향상에 쓰이는 구조가 굳어지면, 앞으로 새로운 창작을 할 동기가 줄어든다는 우려가 나옵니다. 그 결과 경제적 힘과 정보에 대한 영향력이 소수의 기술 기업에 집중될 수 있다는 것이 이 관점의 핵심 경고입니다.
앞으로 지켜볼 것과 독자가 할 일
현재 진행 중인 항소는 미국 연방대법원까지 갈 수 있습니다. 대법원이 frontier lab들에 막대한 금전적 책임을 지우는 방향으로 갈지, 아니면 기업의 대규모 데이터 수집을 그대로 승인하는 방향으로 갈지는 아직 알 수 없습니다. 어느 쪽이든 AI 산업의 비용 구조와 창작자의 권리에 큰 영향을 미칠 결정입니다.
정리하면 이렇습니다. 구매한 책을 스캔하는 것은 현재 미국 법원 기준으로 합법이지만, 해적판 사용은 $15억이라는 비싼 대가를 치르게 되었습니다. 2022년 이전 책은 AI 오염이 없는 사람의 글이라는 점에서 귀해졌고, 바로 그 이유로 희귀본과 절판본이 데이터로 바뀌며 원본이 사라지고 있습니다. 법적 허용과 윤리적 수용은 같은 말이 아니며, 그 간극이 이 사안을 불편하게 만듭니다.
독자가 할 수 있는 일은 다음과 같습니다.
- AI 관련 저작권 판결, 특히 대법원 심리 여부를 지켜봅니다. $15억 합의금 같은 기준이 AI 기업과 관련 투자의 지급 능력에 미치는 영향이 큽니다.
- 2022년 말 이전에 만들어진 글과 자료는 AI 생성 텍스트가 섞이지 않았다는 점에서 데이터로서도, 기록물로서도 독자적인 가치가 있다는 점을 인식합니다.
- 창작이나 사업을 한다면 생성 모델이 쉽게 흉내 낼 수 없는 전문성과 지식재산 쪽으로 무게를 옮기고, 자신의 작업물과 개념에 대한 기록을 공개적으로 남겨 둡니다.
- 사람의 기여가 공정하게 보상받는 법적 구조가 필요하다는 논의에 관심을 갖고 참여합니다.
지식이 디지털로 보존된다는 말과 지식의 원본이 보존된다는 말은 다릅니다. 이 둘의 차이를 어떻게 다룰지가 앞으로 AI 윤리 논의의 중요한 축이 될 것으로 보입니다.