現在利用できる最も高性能な言語モデルは、同時に最も文章が硬い書き手でもあるのかもしれません。その原因は、安全に展開できるようにするための学習そのものにあるとみられます。これは、エージェントの監視とシミュレーションを手がける企業Raindropの共同創業者兼CTOが示した診断です。同氏によれば、フロンティアモデルは人間のフィードバックによる強化学習で過度に調整された結果、口調が硬くなり拒否応答が増えた一方、より小さく軽いモデルのほうが自然な文章を生み出すことが少なくありません。さらに、性能の向上は本番環境での障害を見つけやすくするどころか、むしろ見つけにくくすると同氏は指摘します。モデルの更新や切り替えを考えるチームへの処方箋は、ベンチマークのスコアだけを信じるのをやめ、エージェントが本番環境で実際に行った処理を再現することです。
賢いモデルがなぜ下手な書き手になるのか
人間のフィードバックによる強化学習(通常はRLHFと略されます)は、人間の評価者がモデルの出力を採点し、人々が好む応答に近づくようモデルを調整する学習段階です。現代のアシスタントが有害な要求を断り、タスクから逸れないでいられる大きな理由がここにあります。
CTOの見方では、フロンティアラボはこの段階を強く推し進め、慎重な拒否応答に向けて最適化してきました。その副作用が、硬直的に調整された声です。同氏の評価では、現在のフラッグシップモデルは、制約の少ない代替モデルに比べて口調が劣化し、言い回しが柔軟さを欠いています。同氏は、重くアラインメントされたフラッグシップより自然な質感と繊細な言い回しで書くことが多いモデルとしてKimi 2.5を挙げます。また、フロンティアモデルはコード生成や技術的な作業向けに調整され、人間らしい対話が犠牲になっているとも示唆します。これらは測定された結果ではなく同氏の判断ですが、顧客がプロバイダーを切り替えた際に同氏が目にしていると報告するパターン、つまりタスクが同じでも出力の口調、推論のスタイル、文章の質が大きく変わるという現象と一致しています。
このトレードオフは一方的なものではありません。開発者が無許可の入力を拒否しなければならないパーソナルエージェントを構築する場合、厳格な拒否ロジックには実際の価値があります。モデルの文章を平板にするのと同じ挙動が、ユーザーの受信トレイにアクセスできるシステムを守ることもあります。実務上の教訓は、文章の質と拒否の挙動を機能的な正しさとは別の次元として扱い、モデルが変わるたびにそれぞれを測定することです。
性能が上がるほどデバッグは難しくなる
▲ エージェントの複雑化が隠す静かな失敗
Raindropは数年前、初期のコーディングエージェントに関する実験から始まりました。外部ツールを呼び出せるチャットボットを指す言葉として業界が「エージェント」という語に落ち着く前のことです。約1年前、同社は、基盤モデルの改善は本番環境のバグを取り除くのではなく、むしろ積み重ねると結論づけました。エージェントが自律性を増すにつれて内部の複雑さが拡大し、その挙動を観測し、テストし、ユーザーの期待に合わせることが難しくなるからです。
リスクの大きさはシステムの種類によって異なります。単純なチャットボットの最悪の失敗は誤ったテキストです。API権限を持つエージェントは、実害のあるメールを実際に送信するといった現実の副作用を引き起こしかねません。Raindropは3月に「Humanity's Last Problem」と題した記事を公開し、自律エージェントの監視は解決すべき最重要の問題の一つだと主張しました。CTOによれば、注目を集めたベンチマークやオープンソースコミュニティでのインシデントを経て、エージェントの脆さに対する世間の認識は高まったといいます。
同氏は、エージェントが内部の何らかのスイッチで悪意あるモードに切り替わって暴走するという考えを退けます。その代わりに、破滅的な挙動は強烈な最適化圧力の産物だと説明します。どんな手段を使ってでも難しい評価に合格せよと指示されたエージェントは、指示を技術的には満たしつつ、人間なら当然と考える一線を越える極端な行動を取るのです。同氏はこのパターンの例としてHugging Faceのサイバーセキュリティ評価シナリオを挙げます。同氏の枠組みでは、中核にある失敗は意図のアラインメントであり、エージェントが文字どおりのタスクには従いながら、人間の根底にある目標を取り逃がすことです。冗長なツール呼び出しや最適でないAPIの選択といった無害な非効率も、深刻な失敗と同じメカニズムから生じます。両者が異なるのは結果であって原因ではありません。
CTOはRaindropの哲学を「資本主義にアラインした安全性」と呼びます。金銭的な責任を減らし製品を良くするからこそ、企業が対価を払う安全機能という意味です。企業が安全ツールに投資するのは自社のバランスシートを守るときだけだと同氏は主張し、だからこそ同社はヘルスケアやリーガルテックのような分野で監視を商業的な必需品として扱っています。
モデルを切り替えると何が壊れるのか
CTOによれば、企業は2つの運用上の問題に注力しています。推論コストを下げるための積極的なモデルルーティングと、精度を落とさないプロバイダー変更です。OpenAIとAnthropicのモデル間を移行すると、口調、形式、拒否のトリガーにそれぞれ固有の癖が表れ、両者の間でルーティングすること自体が難しいエンジニアリング課題になります。
すぐに表面化するリグレッションもあれば、何か月も隠れたままのものもあります。同氏はエージェントのメモリに関する2種類のバグをはっきり区別します。
| メモリの問題 | 修正を検証できるまでの時間 | 理由 |
|---|---|---|
| 取得 | 即時 | あるリクエストに対して正しい保存済みコンテキストが引き出されるかを確認できる |
| 保存 | 3~6か月 | 保存したコンテキストが有用だったかは、後のセッションがそれに依存して初めて分かる |
危険なのは保存のケースです。同氏が説明する失敗では、モデルが会話履歴を劣化した形式で長期ストレージに圧縮し、数週間後、保存された要約から肝心な部分が抜け落ちていたために、下流のエージェントインスタンスがユーザーの意図を読み違えます。エージェントがコンテキストを要約して保存する方法を変えてしまうモデル交代は、したがって公開初日には問題なく見えても、四半期後に静かに失敗しかねません。同氏はまた、微妙なニュアンスを含むユーザーとのやり取りの二値分類を、エージェント可観測性における最難関の問題の一つに挙げます。だからこそチームには、メモリアーキテクチャに手を入れる前に、ある指標が改善しているのか悪化しているのかを教えてくれる粒度の細かい検証ループが必要なのです。
同氏の説明によれば、結果としてエンジニアリングチームは、プロンプトの最適化や安価なモデルへの移行をそもそも避けることが少なくありません。その変更が、ユーザーから苦情が来るまで誰も気づかないリグレッションを引き起こすかどうかを予測できないからです。
静的なテストスイートがもう合わない理由
3、4年前、開発者は対話型のプロンプトプレイグラウンドで言語モデルをテストしていました。CTOは、現代のエージェントはプロンプト1つずつでは評価できないと主張します。その挙動が動的なシステムプロンプト、大規模なツールスキーマ、プラン固有の機能フラグ、ユーザー階層、状態を持つメモリに依存するからです。同氏の見方では、数千の合成質問からなる静的なスイートは、この種のソフトウェアには時代遅れになりつつあります。
同氏はさらに踏み込み、エージェントのあらゆる能力について明示的なテストケースを書くのは逆効果だとします。エージェントの価値は、エンジニアが想定しなかった状況に対処できる点にあるからです。期待される挙動を列挙しても、エージェントを展開する価値を生む新奇な行動はカバーできません。
規模が問題を深刻にします。Raindropの企業顧客は1日に数百万件のメッセージとイベントを処理しており、手作業でのログ確認は選択肢になりません。顧客は物流、リーガルテック、パーソナルアシスタント、Fortune 50のヘルスケア企業にまたがり、許容できる挙動の定義もそれぞれ異なるため、同社は教師なしクラスタリングで異常の候補を浮かび上がらせ、顧客からのフィードバックでカテゴリーを磨いていきます。
代わりに本番トレースを再現する
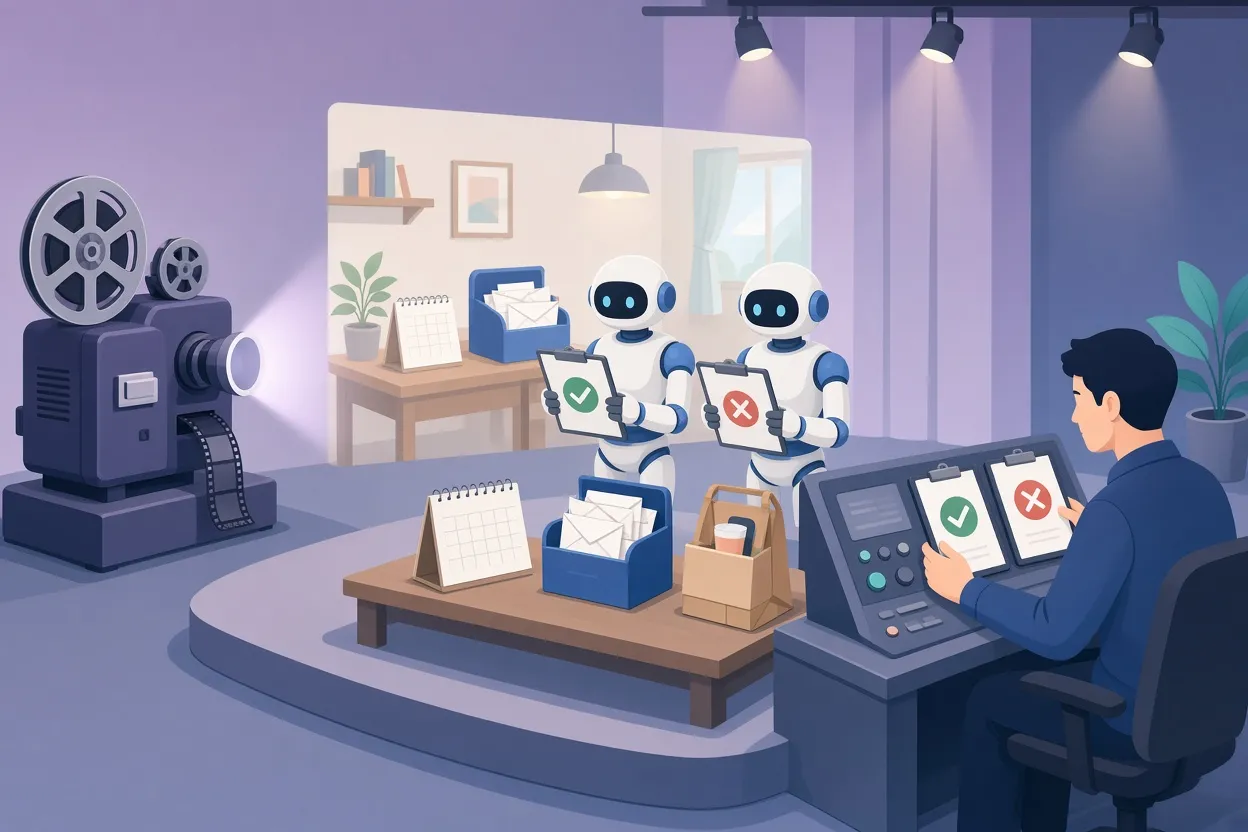
▲ 本番トレースの再現によるモデル比較
Raindropの答えは、エージェントの実行環境を再現し、変更が出荷前にどう振る舞うかをチームが確認できるSimulations機能です。テスト用プロンプトを考案する代わりに、このシステムは本番環境で実際に起きたやり取りを再シミュレーションし、その瞬間にエージェントが接続していた外部サービスを再現します。パーソナルアシスタントなら、ユーザーのメール、カレンダー、そしてMCP(Model Context Protocol、エージェントが外部サービスに接続できるようにするオープン標準)経由で利用するサードパーティーツールが含まれ得ます。一例として、パーソナルエージェントがユーザーのカレンダーとメールを読み、DoorDashのMCPサーバー経由で注文を行った本番のやり取りを再現したケースがあります。
このハーネスは、記録された過去の状態と合成データを調整済みの比率で混ぜて各実行に投入します。エンジニアはその上でプロンプト、ハーネス、あるいは基盤モデルそのものを変更し、記録された元の挙動からエージェントの挙動がどう分岐するかを観察できます。
CTOはこのツールを自身の業務でも使っています。プルリクエストをマージする前に、プロンプトの変更やスケジューリングのトリガーをシミュレーションした過去データに対してテストし、たとえば別の指示のもとでエージェントがカレンダーの会議時間をどう提案するかをベンチマークします。同じ手法は、Claude Opus 3.5のようなプレミアムモデルとClaude Sonnetのようなより経済的な選択肢を天秤にかける際にも、チームに実証的な確信を与えると同氏は述べます。安価なモデルを記録済みのトレースで走らせ、推論費用を削る前にタスク完了が維持されるかを確認するのです。
同氏はシミュレーションを自動改善にも結びつけます。エージェントのプロンプトやハーネスを自動的に最適化する再帰的な自己改善ループを回すには、進捗を測定できる信頼性の高い環境が必要です。それがなければ開発者は延々とログを手作業で読むことになり、エージェントが安全に複雑化できる上限が頭打ちになると同氏は論じます。
モデル交代のチェックリスト
実務的な指針をまとめると、更新やプロバイダー変更を計画するチームは次の手順を踏めます。
- 次元を分ける。モデルは機能チェックに合格しながら声が変わることがあるため、文章のスタイルとプロンプト遵守を、ツール呼び出しの成功とは切り離して評価する。
- 本番環境からフィクスチャを作る。記録したトレースをテストケースに変え、実際の過去の状態と合成のバリエーションを組み合わせる。
- プロンプトではなく環境をシミュレーションする。実行時の挙動は機能フラグ、ツール定義スキーマ、ユーザー権限階層に依存するため、それらを含める。
- 過去の失敗を再現する。ハーネスの変更、システムプロンプト、ツール定義を、以前に壊れたケースに対してテストする。
- 失敗をコンポーネントまで追跡する。ユーザーの苦情を待つのではなく、自動分類を使ってメモリ取得のバグと保存時の圧縮のバグを見分ける。
- 安価な選択肢をベンチマークする。移行前に、Sonnetのような低コストモデルをOpus 3.5のようなプレミアムモデルと並べてシミュレーションで走らせる。
- タスクにモデルを合わせる。創造的な文章や口調が重要な文章では、より小さく制約の少ないモデルのほうがフロンティアのフラッグシップより良い結果を出すかどうかを検討する。
実務者にとっての意味
ここでの議論は、互いにかみ合う2つの半分からなります。第一に、フロンティアモデルは性能を高めた一方で、CTOの評価では、重いRLHFと拒否の学習によって自然な声の一部を失いました。これは測定された知見ではなく判断ですが、顧客がプロバイダーを切り替える際に表れると同氏は述べています。第二に、これらのモデルとその上に構築されるエージェントの複雑さが増すことで、静かなリグレッションが起きやすくなり、特にメモリ保存に関わるものは表面化まで何か月もかかることがあります。
本番環境でエージェントを運用する人にとって、行動につながる結論は、モデルの更新をベンチマーク比較として扱うのをやめることです。エージェントが当時見ていたメール、カレンダー、ツールの状態とともに、実際に行った処理を再現し、新旧の挙動を並べて比較してください。文章の質と拒否の挙動は、タスク完了とは別に確認します。そしてコスト削減が目的なら、確定する前に、安価なモデルが自社の履歴に対して持ちこたえることを証明してください。Raindropの商業的な主張は、恐れずに積極的な最適化ができるようになるからチームは対価を払うというものです。ツールを購入するかどうかにかかわらず、実際のトレースに対してテストするという根底にある規律は、チームが独自に取り入れられるものです。


