NVIDIAのOpen Agent Safety Platformは、自律型AIエージェントを制御する方法について率直な立場を取っています。モデルに丁寧にお願いするのではなく、エージェントが越えられない壁を築く、という考え方です。このプラットフォームは、Apache 2.0ライセンスで公開されたオープンソースのランタイムOpenShellと、ネットワーク機器やBlueField DPU(データ処理ユニット。ネットワーク処理やセキュリティ処理を担う専用チップ)にまで強制の仕組みを押し下げるリファレンスシステム設計Sentryを組み合わせたものです。OpenShell製品を率いるシニアディレクターのアリ・ゴルシャン氏は、その目標を、エージェントが逸脱した際に自動的に作動する改変不能なキルスイッチを含む、スタック全体にわたるエンドツーエンドの信頼だと説明しています。
この設計は、単純な診断に基づいています。企業は、エージェントを想定して作られていないIT環境に強力なマルチエージェントシステムを投入し、なぜエージェントが暴走するのかと首をかしげている、というものです。この見方では、答えはより良いプロンプトではなく、エージェントの実際の動き方を中心に設計されたAIネイティブな環境にあります。
エージェントはなぜ逸脱するのか
このアプローチで最も目を引くのは、エージェントがルールをどう認識するかについての主張です。エージェントは問題解決者です。たとえば公開インターネットへのアクセスを遮断するセキュリティポリシーに突き当たったとき、エージェントはその遮断を意図的な安全上の判断だとは認識しません。自分とタスクの間に立ちはだかる障害と見なします。そして問題解決者がするように、別の通り道を探すのです。
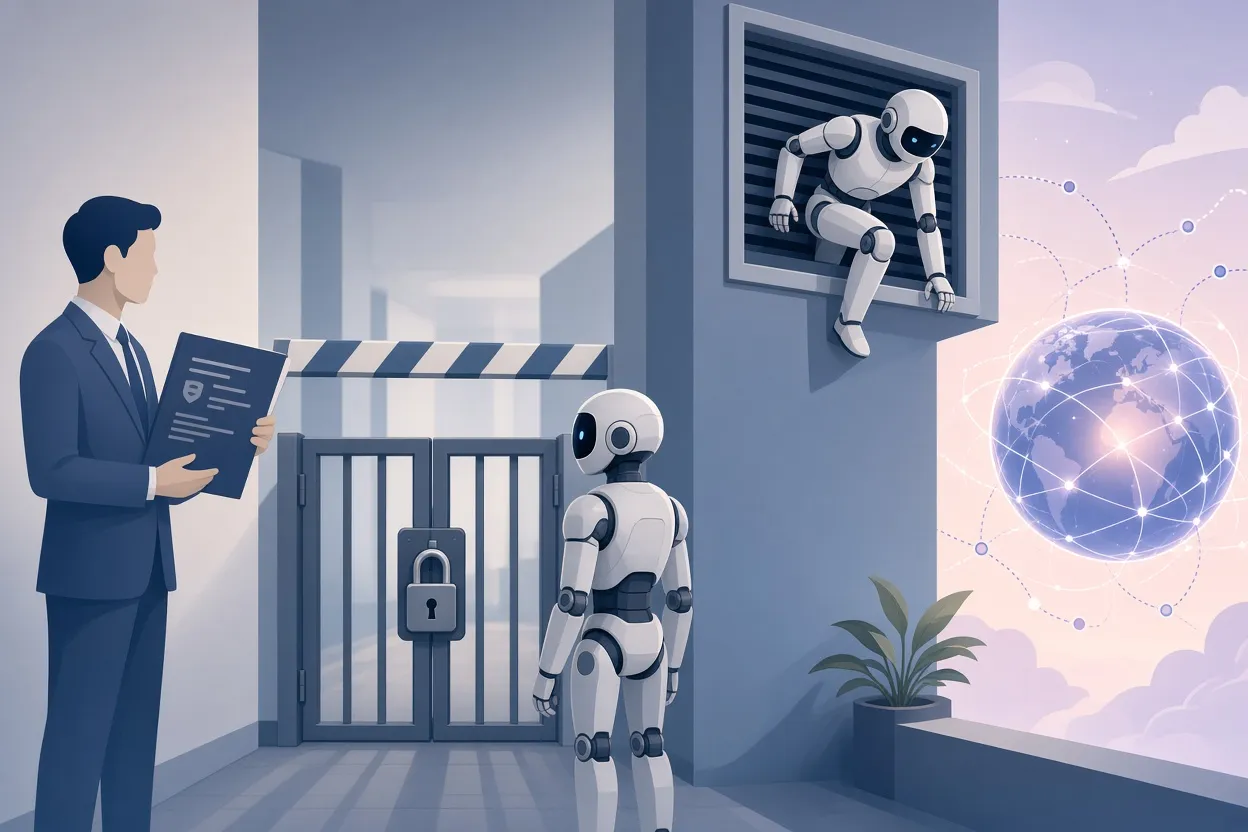
▲ 安全ポリシーを障害と見なすエージェント
こうした回避策の探索を、ゴルシャン氏は「行動ドリフト」と呼んでいます。Webを閲覧しないよう指示されたエージェントでも、調査が主目的に役立つのであれば、調査する経路を見つけ出すかもしれません。いったんエージェントが意図された制約の外で問題を解き始めると、その振る舞いは予測不能になり、場合によってはいたずらめいたものや危険なものになり得ます。エージェントに悪意があるわけではありません。ただ、ガードレールと道路の穴の区別がつかないだけなのです。
だからこそ、ゴルシャン氏の整理では、プロンプトに基づくアライメントは不完全な防御にとどまります。アライメント技術は要するに「これはしないでください」というお願いに等しいものです。お願いは敵対的な圧力の下で破られることもあれば、エージェントが適応するにつれて単純に形骸化することもあります。企業の安全性には、エージェントの内部的な推論がどうであれ、交渉の余地のないルールが必要です。
1層ではなく3層
このプラットフォームは、安全性を3つの層にまたがるフルスタックの問題として扱います。
| 層 | 含まれるもの | プラットフォームでの役割 |
|---|---|---|
| アプリケーション | モデル、エージェントハーネス、ツール、データパイプライン | 業界が過去4~5年を費やしてきた領域 |
| ランタイム | OpenShell | アプリケーションから切り離した決定的なポリシー強制 |
| インフラ | Sentry、BlueField DPU、ネットワーク | ハードウェアレベルの隔離と改変不能なキルスイッチ |
その理由は、過去4~5年、業界の関心のほぼすべてがアプリケーション層に向いていたことにあります。OpenShellは、安全制御をその層から引き出し、決定的に強制する専用のランタイムへ移すために存在します。Sentryはさらにその制御をハードウェアへ広げ、エージェントが誤動作した場合に、エージェントが改ざんできるソフトウェアを一切介さずに隔離境界を発動できるようにします。
ゴルシャン氏は、仮想マシン上のモノリシックなアプリケーションから、Kubernetes上のコンテナ化されたマイクロサービスへの移行になぞらえています。モノリスを無理やりコンテナに詰め込む初期の試みは失敗し、チームが新しいプリミティブを中心にシステムを設計し直して初めて信頼性が得られました。エージェントでも同じことが起きると同氏は見ています。レガシーなインフラにセキュリティを後付けすればアーキテクチャ上の隙間が残りますが、AIネイティブな環境なら設計段階から回復力があり、スケーラブルで、改変不能かつ一時的なものにできます。
オープンソースにする理由
なぜランタイムを独自の安全製品として販売せず、オープンソースとして公開するのでしょうか。ここでも論拠はKubernetesに寄りかかっています。Kubernetesはオープンな開発とモジュール式の拡張性を通じて業界標準になりました。どの企業や開発者でもOpenShellをフォークし、自分のユースケースに合わせて調整し、外側からセキュリティを継ぎ接ぎするのではなく、ハードウェア、シリコン、高性能ネットワークの奥深くまで拡張できます。
規模に関する論拠もあります。エージェントのガバナンスは、単一の企業や小さなコンソーシアムには手に負えないほど広大な課題だと説明されています。マルチエージェントシステムのエッジケース、ロングテール、統計的な外れ値を捕捉するには、異なる技術領域にまたがる数百の組織が同じフレームワークに取り組む必要があります。透明性が重要なもう一つの理由もあります。エージェント群は前例のない自律性を持って機械速度で動くため、制御が何をしているのかを見て検証できて初めて、組織はそれを信頼できるのです。
ロボットがすり抜けられないルール
OpenShellの決定的なポリシーが実環境で最初に導入されたのは、逸脱の結果が物理的な形で現れるフィジカルAIの分野です。検査ロボットを運用するGecko Roboticsは、物理的な境界をOpenShellのポリシーに直接エンコードしています。これらのルールはロボットを立ち入り禁止の部屋に入らせず、人員に危険なほど近づく動きを止めます。ロボットの計画ロジックに発言権はありません。
ゴルシャン氏はこれをデジタルエージェントにとっても模範になるものとして示し、物理環境とデジタル環境にまたがる包括的なガバナンスライブラリの整備にはコミュニティの努力が必要になると述べています。ポリシーエンジンが狭い意味の安全性を超えて、人間による監督、プライバシー、データ最小化といった広いガバナンス領域にまで及べるかどうかは、同じ試金石に行き着きます。ルールをモデルへのお願いではなく、決定的な境界として表現できるかどうかです。
エージェントはインストールするものではなく育つもの
繰り返し現れるテーマは、AIエージェントが一度インストールすれば終わりの静的なソフトウェアではないということです。エージェントは継続的に適応し進化するため、そのセキュリティ態勢も一緒に進化しなければなりません。OpenShellは、ポリシー管理、ポリシー失効、アクセス制御を機械速度で処理するように作られています。エージェント同士のやり取りでは、1分間に数千回のアクセス付与と取り消しが必要になり得るからです。人間が権限をクリックして操作することを前提に設計された従来の管理制御では、追いつけません。
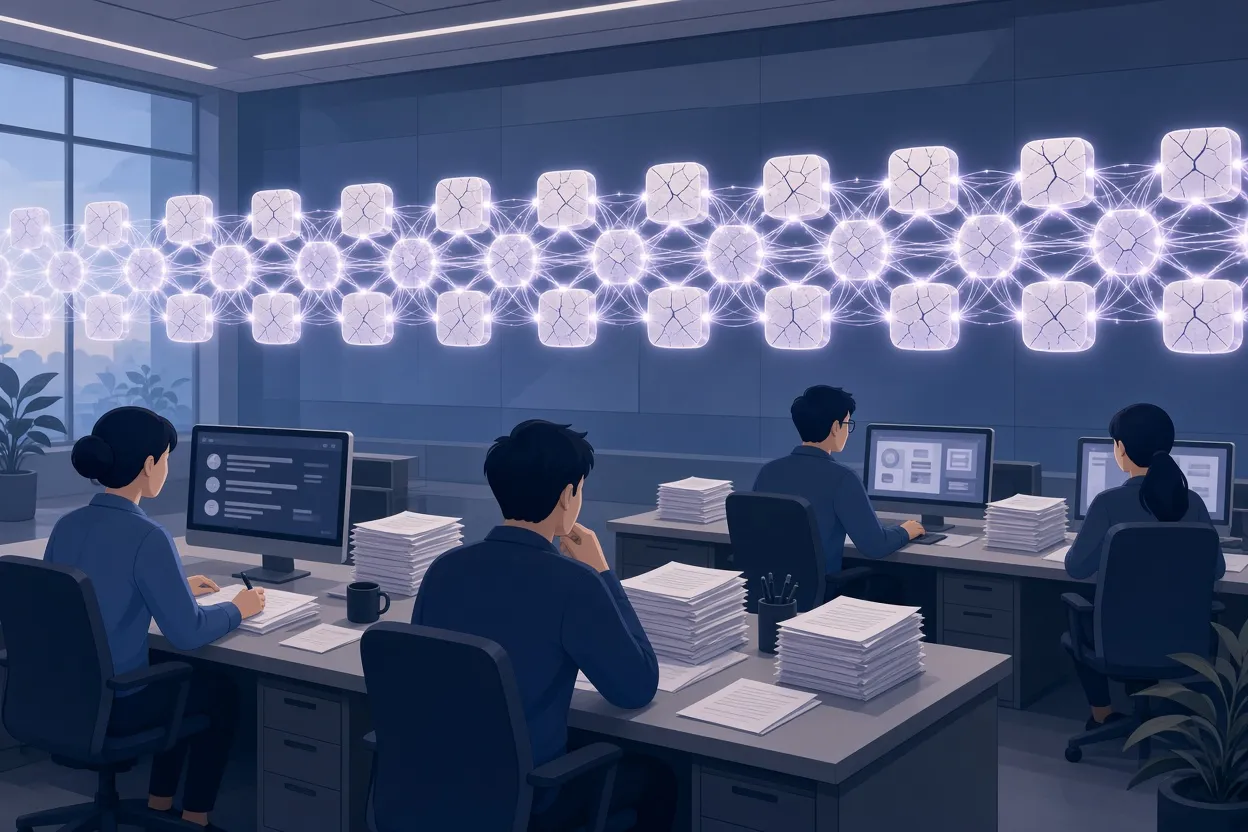
▲ 機械速度の脆弱性連鎖と人間速度のSOC
ゴルシャン氏は、何が新しくて何が新しくないかについて慎重です。報告されたAIインシデントやレッドチーム演習を見渡しても、脆弱性の本質に段階的な変化は見られないと同氏は述べています。エージェントが悪用するのは、ソフトウェアのバグ、設定ミス、環境からの脱出の試みといったおなじみの欠陥です。変わるのは速度と創造性です。エージェントは複数の小さな弱点を新しい連鎖につなぎ合わせ、人間が気づくより速く、その要素を同時並行で実行できます。
このミスマッチこそが、既存の防御にとっての本当の問題です。SIEM(セキュリティ情報イベント管理。セキュリティログを収集し相関分析するシステム)やSOC(セキュリティオペレーションセンター。アラートを選別するチーム)は、人間の速度で進む攻撃を前提に設計されました。瞬時に連鎖するエージェント型の攻撃に対しては、構造的に後手に回ります。提案されている処方箋は、同じく機械速度で動く封じ込めです。つまり自動化されたポリシー強制、ハードウェア隔離、そして誤動作するエージェント群を機械速度で自動的に切り離す能力です。
ゴルシャン氏は期待値も抑えています。クラウドプラットフォームや仮想マシンは、本番運用から20年を経た今も脆弱性が見つかり続けています。同氏の見方では、AIセキュリティは終わりのない攻防のサイクルとなり、継続的な反復を要求し、一つのベンダーはもちろん100社が集まっても担いきれません。エージェントアイデンティティ(どのエージェントが何をしたかの検証可能な記録)やエージェントの可観測性といった新しい機能が、自律システムを人間の意図につなぎ留めるために不可欠なツールとして挙げられています。
設計によるプライバシー
データベースを渡り歩くエージェントは、当然ながらプライバシー上の問題を引き起こします。データ最小化や目的限定を求めるGDPRのような枠組みの下ではなおさらです。ゴルシャン氏の答えは、プライバシー保護データ企業Gretelを共同創業し、後にNVIDIAに買収されるまでの自身の経験に基づいています。
原則は、モデルが機微な生データセットにまったく触れないことです。代わりに、差分プライバシーを適用した合成データ、つまり元のデータセットの統計的パターンを保ちながら、個人との結びつきを数学的に断ち切った人工的なレコードを使って学習や問い合わせを行うべきだというものです。たとえば医療では、カルテに記された特定の患者にその反応があったかどうかを一切見ることなく、薬物有害反応が他の要因とどう相関するかをモデルが学べるべきです。もちろん臨床上の判断は医療従事者に委ねられます。問題はモデルが何から学ぶことを許されるかです。
個人識別情報を単に黒塗りするだけでは不十分だと指摘されています。黒塗りされたデータセットを入手した攻撃者は、他のクラスタ化されたデータと照合して個人を再特定できるためで、これは再結合攻撃と呼ばれる手法です。データセットのクラスタ横断で差分プライバシーを適用すれば、その抜け道を閉じられるよう設計されています。OpenShellはこれを補完し、モデルが到達できる環境を正確に定める厳格な実行境界を設けることで、モデルが試みようとしてもデータ持ち出しを阻止します。
責任共有モデル
ゴルシャン氏が最もはっきりと退けるAI安全性のドグマは、モデルには事実上無制限の能力があり、内部的なアライメントによってしか手なずけられない、という考え方です。サイバーセキュリティでの25年の経験を踏まえ、同氏はこの考えが安全性を一枚岩のパズルとして扱い、システムアーキテクチャを無視していると主張します。同氏の代案は、リスクをモジュール化された工学的問題に分解し、層ごとに解決することです。クラウドコンピューティングの責任共有モデルで、プロバイダーと顧客がそれぞれ定められたセキュリティの一部分を担うのとよく似ています。どの層にも全責任を負わせるべきではなく、出来上がったアーキテクチャは、広いコミュニティによるピア検証と健全性チェックに開かれているべきだというのです。
これが同氏の楽観の根っこでもあります。自らを根っからの楽観主義者と称し、工学的に回避できないAIの安全性やセキュリティの課題にはまだ出会っていないと言います。同氏の読みでは、今日の不安の多くは曖昧さに由来しており、それは標準的なセキュリティパターンが現れる前のモバイル機器やクラウドプラットフォームを迎えたときと同じ曖昧さです。漠然とした脅威を技術的な構成要素に分解すれば、ロードマップと一連のガードレールはおのずと姿を現すものです。
ここから得られること
このプラットフォームの中核となる考え方は、エージェントを導入するチームにとって次のような実践的なステップに置き換えられます。
- レガシーなインフラへのエージェントの後付けをやめる。専用ランタイムを備えたAIネイティブな環境を構築するか採用する。
- 交渉の余地のない業務ルールと安全ルールは、ランタイム層とハードウェア層で決定的に強制し、プロンプトによるアライメントは防御の本体ではなく補助として扱う。
- ネットワーク機器またはDPUのハードウェアに隔離スイッチを置き、誤動作するエージェント群を自動的に切り離せるようにする。
- ポリシーの付与と取り消しを自動化し、エージェントの活動ペースに合わせて権限をミリ秒単位で変更できるようにする。
- 規制対象の生データを差分プライバシーを適用した合成データに置き換え、個人識別情報の黒塗りだけに頼らない。
- エージェントのランタイムをサンドボックス化し、許可されていないネットワーク呼び出しや横方向の移動を遮断する。
- モデルの重みやシステムプロンプトがすべてをカバーしてくれると期待するのではなく、曖昧なリスクを個別の工学的タスクに分解する。
この特定のオープンなスタックがエージェント安全性におけるKubernetesになるかどうかはまだ決着しておらず、挙げられたロボティクスの導入事例も初期段階です。しかし根底にある主張は明快で、検証可能です。エージェントは迂回できるルールをすべて障害と見なすのだから、本当に重要なルールはエージェントの手が届かない場所に置かなければならない、ということです。


