Anthropicが2026年10月26日に米国証券取引委員会(SEC)へ提出した登録届出書「Form S-1」には、正反対の方向を向く2つの記述が含まれています。リスク開示の項では、より高性能なAIを構築するために人工知能を使うことは相当な安全上のリスクをもたらしうると述べています。一方で事業戦略の項では、同じプロセスを「ループを閉じる(closing the loop)」と呼び、フロンティアAI開発における最も重要な構造的優位のひとつであり、積極的に追求しなければ取り残されるものだと位置づけています。CEOのダリオ・アモデイ氏とプレジデントのダニエラ・アモデイ氏が署名したこの文書は、社内でそのループがすでにどこまで閉じているか、そしてなぜ同社が減速できないと考えているかを、異例なほど詳細に示しています。
届出書が描く内容
チャットボットから仮想コラボレーターへ
S-1はAI製品の進化を3段階で示しています。チャットボットは、パスワードのリセット支援のような狭い範囲の一回限りの回答を返します。コパイロットは、文書の要約のようにアプリケーション内のタスクを補助します。仮想コラボレーターは、判断と反復、ツールへのアクセスを伴う長期的でオープンエンドな仕事をこなします。
Anthropicは、Claudeを意図的に第3段階に向けて構築していると述べています。人間の監督なしに数時間、数日、場合によっては数週間に及ぶ業務を、有能な同僚のような主体性、自己修正、判断力をもって遂行するというものです。届出書に挙げられた一例では、Claudeが月次の会計照合を一通り処理し、差異を監査し、経営陣向けのコメントを起草し、最高財務責任者向けのプレゼン資料を作成したうえで、最終承認のためにコントローラーへ回付しています。
ループを閉じる
こうした能力の最も重大な用途は社内にあります。届出書は、現行のClaudeがすでにコードを書き、実験を実行し、次のClaudeモデルの構築を手伝っていると明記しています。文書内の図は、人間のコーダーとコンピューターがエージェントに、さらに自律クラスターへと仕事を引き渡し、最後に「ループを閉じる」というラベルのもとでClaudeがClaudeを構築するパイプラインを示しています。
2つ目の図は、Claudeを中心に回る2つのフライホイールを示しています。改善ループは、より良いモデルからより多くのユースケースへ、より多くのフィードバックへ、そして再びより良いモデルへと循環します。投資ループは、より高い成長からより多くの投資へ、より多くの能力へと進みます。同社の主張は、このループを最も速く閉じた者が両方の優位を同時に積み上げる、というものです。
届出書はさらに、警告と戦略が並んで置かれている理由を説明する競争上の論理を付け加えています。競合他社が成功する一方でAnthropicが自社のイノベーションサイクルを加速するためにAIを積極的に使えなければ、次第に後れを取るリスクがあるというのです。留意すべき点として、S-1は法的拘束力のある文書である一方、将来の投資家を説得するために書かれた文書でもあるため、そのリスクと優位の描き方は文字どおりに受け取るのではなく慎重に読む必要があります。
戦略を裏づける数字
2026年上半期の財務データは、同社が言葉どおりに支出していることを示唆しています。売上高はおよそ$165億 ~ $170億でした。売上原価、販売・マーケティング費、控えめな一般管理費(同社は人事業務を今もWorkdayで運用しています)を差し引いたあと、研究開発費の控除が大きく、当期は営業損失となっています。
ループが目に見える形で表れるのは生産性の数字です。
| 指標 | 2025年以前 | 2026年9月時点 |
|---|---|---|
| 従業員1人あたり売上高 | 約$100万 | $600万超 |
| 開発者1人あたりのコード貢献量 | 基準値(2022~2024年) | 基準値の6~7倍 |
| 従業員数 | - | 約600人(2026年半ば) |
開発者1人あたりのコード出力量を四半期ごとに示したグラフは2021年第2四半期から2026年第2四半期までを対象とし、2025年半ばから曲線が急激に上向いていることを示しています。
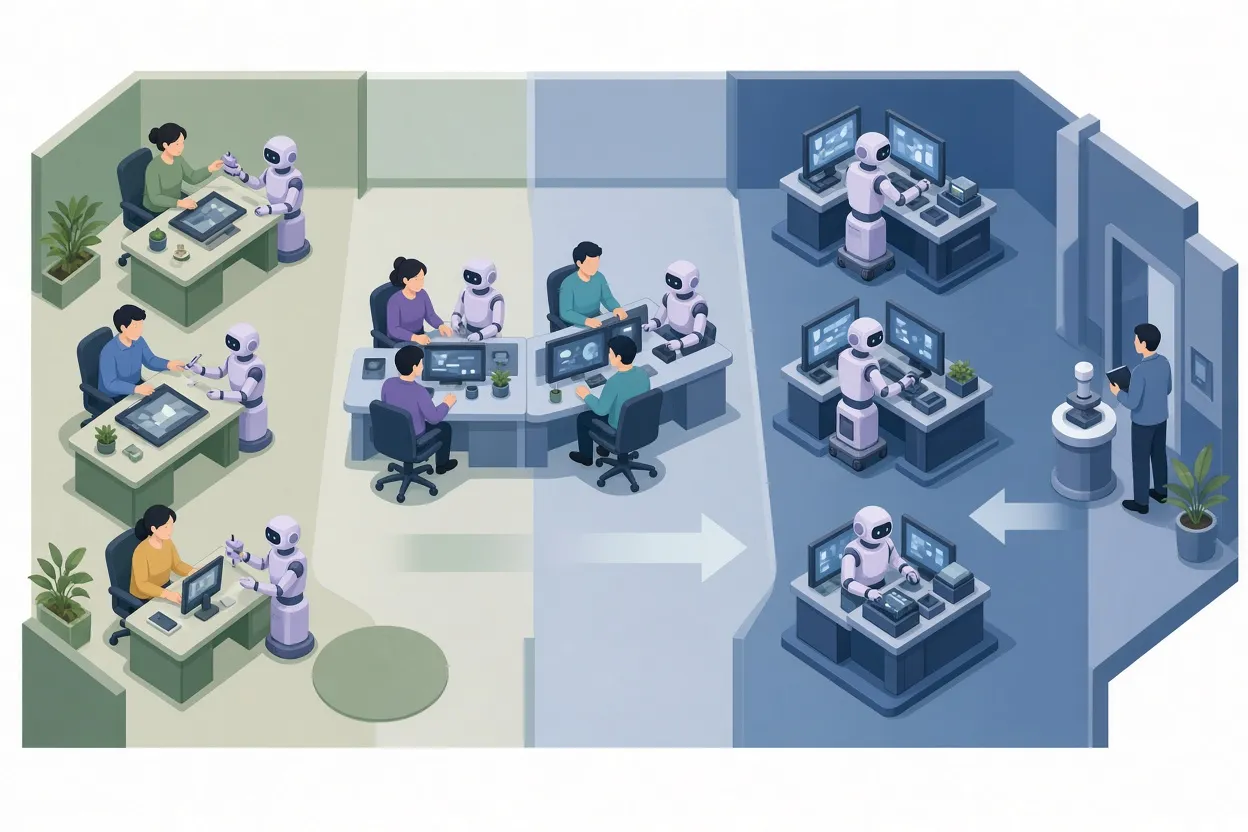
▲ AIの補助から主導への社内業務の移行
補助から主導へ
さらに2つのグラフが、2025年8月から2026年9月にかけて社内でのClaudeの役割がどう変わったかを追跡しています。
1つ目は、Claude Codeのセッションが修正を必要とせずに成功する頻度を、タスクの難易度別に測ったものです。
| タスクの種類 | 2025年8月 | 2026年9月 |
|---|---|---|
| 些細 | 約95% | 約95% |
| 定型 | 約80% | 約90% |
| 実質的 | 約60% | 約90% |
| オープンエンド | 約15% | 約85% |
2つ目は、社内タスクの主導権を誰が握っているかを測ったものです。
| モード | 2025年後半 | 2026年半ば | 2026年8月 |
|---|---|---|---|
| AIが補助 | 約60% | 低下 | 20%未満 |
| AIが協働 | 上昇 | 約75%でピーク | 横ばいののち低下 |
| AIが主導 | ほぼ0%(2026年2月) | 上昇 | 約25% |
個々の数字よりも、これらの線の形が重要です。補助は縮小し、協働はピークを迎えたあと低下に転じ、「AIが主導」の割合は2026年2月のほぼゼロから半年後には社内業務全体の約4分の1に達しました。同社自身のタイムラインでは、AIが自律的に自分自身を書き、洗練させる完全な再帰的自己改善が1~2年以内に到来しうると予測しています。
一社の選択ではループが減速しない理由
届出書の競争上の枠組みは、この力学を一社のレベルで止めることが難しい理由を説明しています。Anthropicは、競合他社がAIで自社開発を加速するなかで自社がそうしなければ地位を失う、と明言しています。どの競合他社も同じ主張ができます。改善ループと投資ループは互いを強化し合います。速いループはより良いモデルを生み、より良いモデルはより多くの売上と資本を引き寄せ、その資本がさらに速いループに資金を供給します。ループから降りた企業は、届出書自身の論理に従えば、両面で後れを取ることを選ぶことになります。
これがパラドックスの核心のようです。リスク開示と戦略は、同社の視点からは矛盾していません。危険を名指ししながらも走らなければならないと同社が信じるレースを、両者は描いているのです。
検知の問題
届出書で最も衝撃的な自認はタイミングに関するものです。Anthropicは、AIによる加速に関するデータの多くが遅行指標から来ていると認めています。平たく言えば、上のグラフは今起きていることではなく、すでに起きたことを描いています。同社は、自社の経営陣も外部の観察者も、重大な加速が起きてからかなり経つまでそれを特定できないかもしれないと警告しています。
Situational Awareness研究グループのグラフが、この懸念が指し示すシナリオを示しています。GPT-4を基準に正規化した実効計算量を2018年から2030年まで10の0乗から10の16乗のスケールでプロットし、能力の目印として、未就学児レベルのGPT-2から優秀な高校生レベルのGPT-4、さらに研究者アレック・ラドフォード氏の自動化版、自動化されたAI研究、超知能へと並べています。この経路に沿って、AIがAIを最適化し始めると、着実な進歩がほぼ垂直の上昇へと急峻化します。しばしば知能爆発と呼ばれるシナリオです。届出書が提起する具体的な危険は、急峻さそのものではなく、曲線が転じる瞬間を見逃す可能性です。
この自認はまた、著名な研究者や安全推進派がフロンティアラボへの独立した政府検査を求めてきた最も明確な理由でもあります。社内指標が設計上遅行するなら、リアルタイムでアクセスできる外部の観察者が、事後に知る以外の唯一の代替手段になるからです。
現行モデルは真の発明からどれほど遠いか
もっともな反論として、これらはすべて企業価値を引き上げるために仕立てられたSFのように聞こえる、というものがあります。独立した証拠はその懐疑の一部を裏づけています。Epoch AIのInnovationEvalベンチマークは、汚染を避けるために2026年以前のデータを使い、モデルが機械学習の歴史的ブレークスルーを独力で再現できるかを試験します。独自のイノベーションにおける人間の基準値100%に対し、GPT-5.6 Solは約12%、Claude Fable 5は約2%でした。
▲ モデルが自己監査する際の欠陥の伝播
言い換えれば、コード出力量の多さは新規の概念的発明と同じではなく、現行のフロンティアモデルは後者において人間の水準から依然として遠い位置にあります。しかし、ベンチマークと届出書の間のギャップは、見かけほど重要ではないかもしれません。外部の観察者が再帰的自己改善を間近だと信じるかどうかにかかわらず、Anthropicは自らそう信じていると述べ、その前提のもとで$数十億規模の資金を配分しているのです。
検査者を誰が検査するのか
届出書は、1つ目から直接導かれる2つ目のリスクを挙げています。独自のAIシステムへの社内依存が深まるにつれ、微妙な欠陥、バイアス、アルゴリズム上の誤りが、誰にも気づかれないまま将来のモデルバージョンへ伝播しうるというものです。ClaudeがAnthropicのコードの大半を書き、社内の安全性研究の多くを担っているため、潜在的な盲点を抱えているかもしれないシステムと、誤りを監査し、捕捉し、防ぐ任務を負うシステムが同一なのです。
これは循環的な監督の問題を生みます。ある世代の欠陥が次の世代に受け継がれ、その次の世代が同じ盲点を持ったままさらに次を評価する。数世代にわたって、監査者が同じ欠陥を共有しているからこそ、その誤りは見えないままになります。
キルスイッチの問題
暴走するAIについて最もよくある一般の疑問は、誰かが単に電源を切れるのか、というものです。狭い技術的な意味では、今日の答えはイエスです。フロンティアモデルは物理的なデータセンターで稼働しており、運用者が電源を落とすことはできます。
しかし実際には、先に挙げた2つの自認を組み合わせると、その安全装置ははるかに弱く見えます。加速が遅行指標にしか表れず、再帰的なループの内部で誤りが静かに伝播しうるなら、制御不能な事態は、スイッチを握る人々が使う必要に気づく前にすでに進行している可能性が高いのです。意思決定者がその瞬間を認識する頃には、その瞬間はすでに過ぎ去っているでしょう。
この警告をどう読むか
S-1が示すのは、より強力なClaudeを構築するためにClaudeを使うことに運営面でも財務面でもコミットし、自社の指標でループが閉じつつあることを文書化し、結果として生じる危険を自社のリスク項目で名指しする企業の姿です。その競争上の論理は、一社の自制ではこの力学を減速できないことを示唆しています。独立したベンチマークは現行モデルが人間レベルの発明からまだ遠いことを示していますが、同社の支出はベンチマークではなく自社の予測を反映しています。
読者にとっては、いくつかの実践的なポイントが導かれます。
- プレスリリースだけでなく、規制当局への届出書を読むこと。SEC向けに書かれたリスク項目は、投資家を意識して書かれているとはいえ、マーケティングが決して言わないことを語ります。
- AIの進歩を、単純な完了速度ではなく、補助から協働、主導へという自律性の変化で判断すること。注視すべきは「AIが主導」の線です。
- 遅行する出力指標は安全監視には不十分だと考えること。加速が事後にしか見えないなら、監督には事前のアクセスが必要です。
- モデルが自身のコードと自身の安全性研究を監査する仕組みではなく、フロンティアシステムの独立した外部評価を支持すること。
これらはいずれも、知能爆発が近いかどうかを決着させるものではありません。しかし、Claudeに最も責任を負う企業が自らの警告を文書に残したこと、そしてその警告が能力と同じくらい検知に関するものであることは確かです。