如何拆分和汇总工作,可能与选用哪款AI模型同样重要。开发桌面编程应用EvoX Agent的EvoMap用563道编程和逻辑题做了一项基准测试:单个AI智能体独自解题时,正确率为26%;而在智能体集群模式下,多个智能体各自承担一份相互隔离的工作,最后再汇总结果,在使用相同底层模型的情况下,正确率达到71%。模型的权重和参数没有任何改动,改变的只是任务的分配方式,以及上下文(模型一次读取的对话和资料)的管理方式。
单个智能体为何难以应对多项任务
让一个智能体连续处理多项任务时,它的对话历史会不断增长。到第四项任务时,它仍然背负着第一到第三项任务的全部内容。这些冗余信息会挤掉真正重要的细节,导致智能体遗漏信息或凭空编造内容。这种上下文污染,正是单个智能体在任务量增大时准确率下降的主要原因。
常见的解决办法是由一个主管智能体把工作分派给子智能体(各自负责一项子任务的辅助智能体),再对它们的结果进行总结。但在同一项基准测试中,子智能体共找到373个正确答案,经语言模型总结合并后只剩下217个,折合正确率为39%。总结本质上是压缩信息,正确答案似乎就在压缩中丢失了。
| 架构 | 基准测试正确率 | 实际情况 |
|---|---|---|
| 单个智能体 | 26% | 先前任务的上下文不断堆积 |
| 子智能体加大语言模型总结合并 | 39% | 373个正确答案中仅217个在合并后保留 |
| 智能体集群 | 71% | 每项任务使用干净的上下文,结果由代码合并 |
集群保持准确率的两项设计
EvoX Agent的集群模式基于两个思路。第一,每项子任务都在各自干净的上下文中运行,每个智能体只看到完成自己那部分工作所需的信息。第二,结果由确定性代码合并,即对相同输入总是产生相同输出的代码,而不是由语言模型撰写总结。这样,正确答案不会在合并过程中因改写而丢失。
如果要自行设计多智能体架构,在把汇总工作交给模型之前,不妨先尝试基于代码的合并。需要注意的是,上述正确率来自EvoMap自己的基准测试,因此最好验证一下自己的工作负载是否也会出现类似差距。
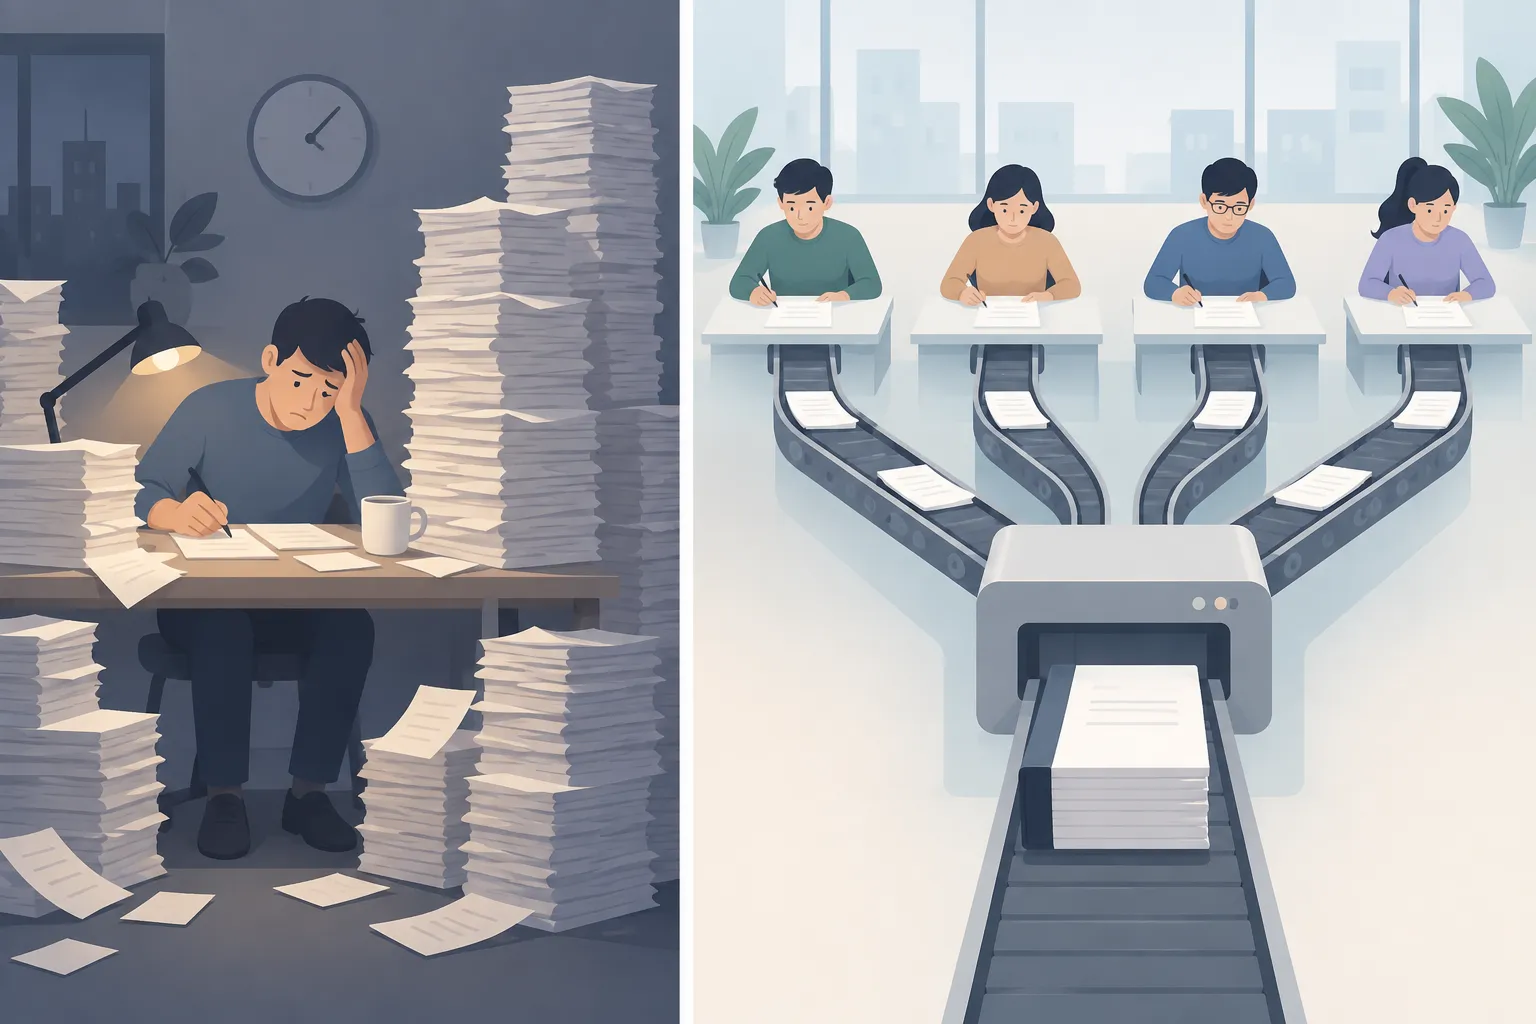
▲ 堆积的上下文与拆分的任务
在真实应用上比较集群与顺序执行
为了检验日常开发中的差异,测试同时给一款印尼语单词闪卡网页应用分配了四项工作:
- 用node:test编写单元测试
- 用tsc进行代码规范检查和类型检查
- 在docs/API.md中编写文档
- 按WCAG 2.2 AA标准审查无障碍性
开启集群模式后,EvoX Agent先拟定了一份协调计划,其中设定了文件归属规则,规定哪个智能体可以修改哪些文件,以免并行工作的智能体产生相互冲突的修改。计划获批后,四个智能体同时开工,共修改了7个文件,用时约7至8分钟。
随后,同一个项目被复制一份,在关闭集群模式的情况下按顺序逐项执行相同的工作。
| 指标 | 集群执行 | 顺序执行 |
|---|---|---|
| 完成用时 | 约7至8分钟 | 约为集群的2.5倍 |
| 消耗的上下文token | 约8.4万 | 约12.9万 |
token是AI模型处理文本的单位,用量越大,通常意味着成本越高、响应越慢。顺序执行会把每项已完成任务的历史带入下一项任务,因此提示词(发送给模型的指令和上下文)不断膨胀,推理速度随之变慢。
100个智能体,一场生存游戏
在一项规模更大的实验中,集群被扩展到100个并行工作单元。实验场景是一款名为Arena的生存游戏:100个物种生活在一张二维网格上,可以进食、移动、繁殖和攻击。一条提示词被拆分为100项任务,每个智能体在自己专属的上下文中,用JavaScript为一个物种编写行为代码,完全看不到其他智能体的代码或策略。全部100个物种脚本的生成和验证用时约20分钟,若逐个完成,可能需要数小时。
| 世代 | 2000回合后存活的物种 | 攻击次数 |
|---|---|---|
| 第一代 | 64 | 12886 |
| 第二代 | 99 | 0 |
第二代的做法是:提炼表现最好的存活物种的行为原则,反馈给AI,让它设计出避免战斗的改进觅食策略。以上一轮优胜者的规则培育新一轮输出,再结合大规模并行生成,看来是迭代优化复杂模拟和优化问题的一种高效方法。
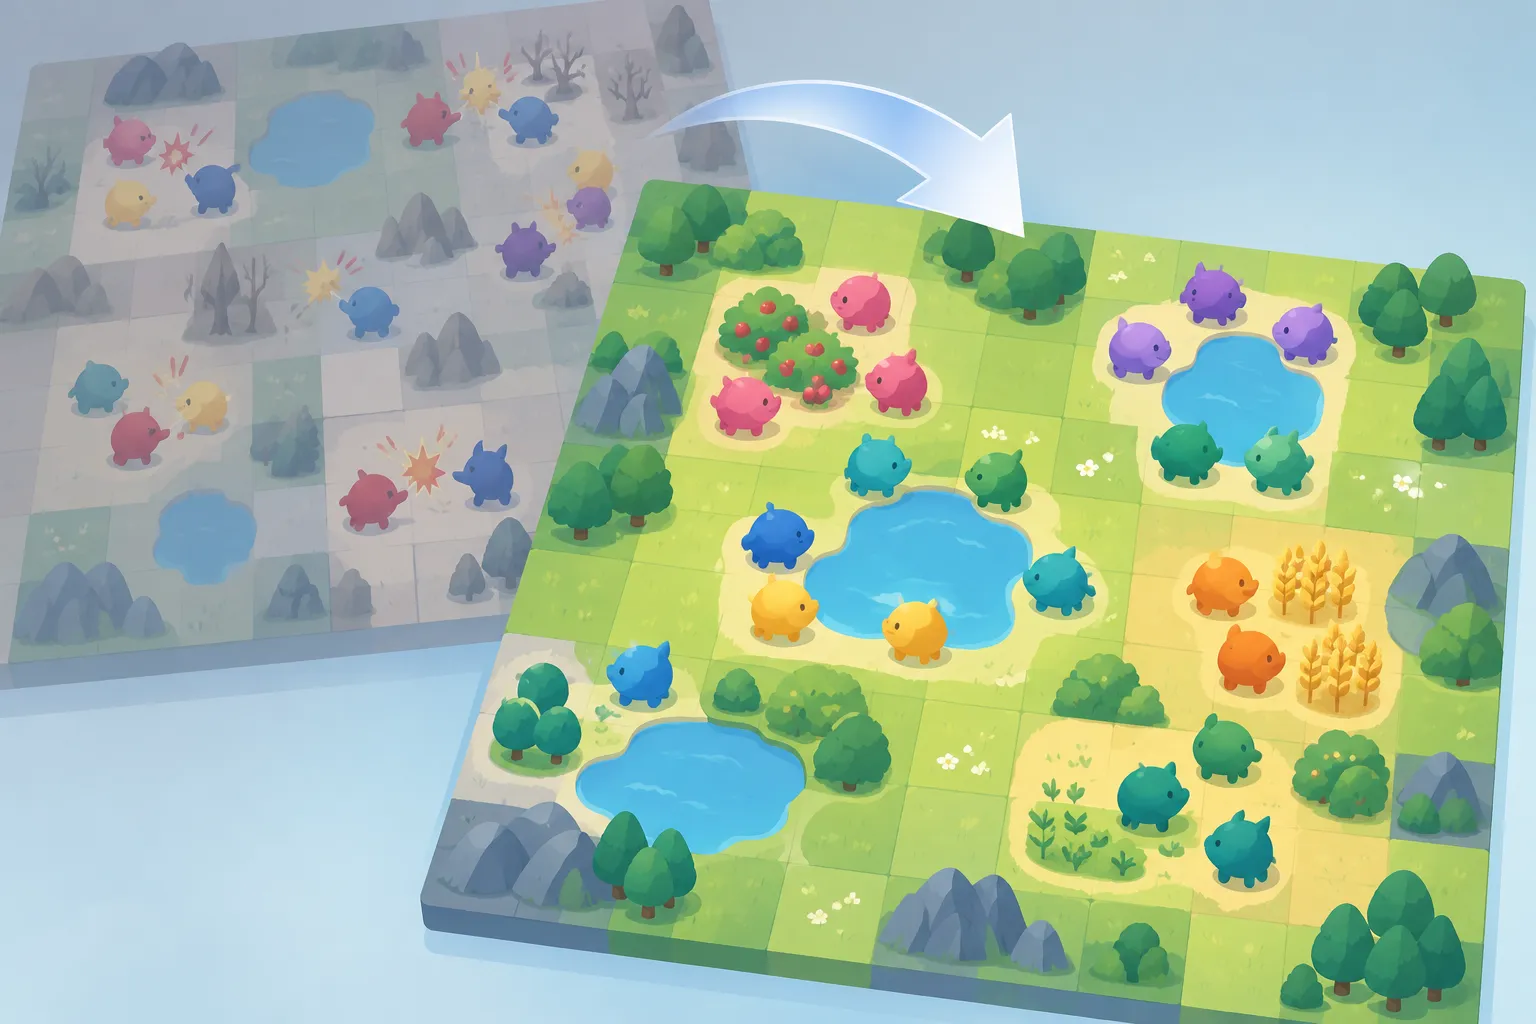
▲ 100个智能体打造的生存游戏
自我进化:复用已经奏效的做法
EvoX Agent还内置自我进化系统,能把成功的工作转化为可复用的能力。整个过程分为五个阶段:Observe记录请求和终端操作,Discover提取新的信号,Reuse or Improve判断是否改进现有能力,Validate为运行结果打分,Solidify把经过验证的流程保存下来供日后使用。
- 基因(gene)是小型的确定性流程,例如执行某种特定的SQL查询模式,或读取项目的数据库结构。
- 胶囊(capsule)是某项任务从头到尾的完整解决方案,与性能指标、置信度分数、成本、token用量以及可重放的执行路径一并保存。
- Events日志是不可篡改的记录,涵盖智能体做出的每一次修改、修复和新增能力。
EvoMap声称,系统学会代码仓库或对话历史中的常见模式后,通过复用已知方案而不是重新推导,可将token用量减少约31%。这一数字当场无法完全验证,但学习循环本身在测试中运行顺畅。由于涉及基因、胶囊、变异等术语,这套系统起初可能让人感觉不太好理解。
上手设置
EvoX Agent是一款面向macOS和Windows的桌面应用,基础功能与Codex、Claude Code等编程智能体相当:为代码库建立索引、编写代码、执行命令以及修复未通过的测试。新账户可获得1500个免费试用积分,价值约$15。设置过程中,可以从Claude Code和Codex导入会话、记忆和设置。
| 模式 | 用途 | 示例 |
|---|---|---|
| Chat | 交互式提问与推理 | 评估闪卡应用是否应从莱特纳盒子改用SM-2间隔重复算法 |
| Cowork | 文档、计划与报告 | 分析卡片数据,生成一页包含图表和表格的PDF进度报告 |
| Code | 代码修改、测试与部署 | 添加统计API端点和界面统计栏,用npm test检查后通过Vercel CLI部署 |
以下几项设置值得留意:
- 自动切换模型会按难度分配任务,把经济型任务交给DeepSeek V4 Flash等较便宜的模型,把均衡型工作交给GPT-5.6 Terra或Kimi K3等模型。
- 模型连接支持OpenAI、Anthropic和Gemini的API,以及Ollama、LM Studio等本地模型服务器。连接在英伟达DGX Spark上运行的本地模型,即可省去云端算力费用。
- 审批模式可在Confirm steps(每一步都先询问)、Smart(只在高风险操作前询问)和Full auto之间选择。Full auto最好只用于可信项目,以及不会删除或覆盖任何内容的工作。
- Connections允许通过Slack、Discord、Telegram、WhatsApp、Microsoft Teams等即时通讯应用向智能体发送指令,还可以扫描二维码绑定手机,离开电脑时也能查看任务进展。
把工作分给多个智能体之前要确认什么
把大量任务堆给一个智能体,累积的上下文会同时拖累准确率和速度。集群为每项任务提供干净的上下文,并用代码合并结果,从而缓解这一问题。无论使用哪种工具,在把工作分给多个智能体时,都值得采用以下做法:
- 对于涉及多个文件或多个关注点的提示词,先确认能否拆分成相互独立的任务。
- 在指令中明确文件归属,确保并行的智能体不会编辑同一个文件。
- 合并结果时,优先使用基于代码的合并,而不是由模型撰写的总结。
- 某次输出效果好时,提炼其中的原则,并纳入下一轮生成。
- 全自动执行只用于可以撤销的工作,敏感操作保留逐步审批。
- 在依赖厂商公布的准确率和token节省数据之前,先用自己的一小部分工作进行测试。