OpenAI新推出的Decisions API不写答案,只做选择。把文本或图片连同一份固定的候选答案列表发过去,它会在约150毫秒内返回每个选项的概率,而且没有需要付费的输出token。从能发现走神的专注计时器到视频粗剪工具,用7个实际项目来检验,可以清楚看到这种快速、低价的分类器在哪些场合胜过聊天模型,又在哪些地方力有不逮。
决策模型与聊天模型有何不同
标准语言模型逐个token生成答案。token是模型读写文本的小单位,每多一个token,延迟和成本都会增加。Decisions API完全跳过了生成过程。它在模型的一次计算中为一组预先设定的选项打分,因此输出token为零。
一个客服示例可以说明其原理。把“I was charged twice for my order(我的订单被重复扣款)”这条消息与Billing、Technical、Shipping、Other四个选项一起发送,API会以100%的置信度返回Billing。答案永远是你给出的选项之一。
同样的机制还能驱动一个无需人工操作、自动玩开源第一人称射击游戏的机器人。截图和坐标数据与移动选项(前进、后退、横移)以及动作选项(射击、换弹、跳跃)配对,机器人每秒做出多次此类判断,每次成本不到一美分。
OpenAI自己公布的数据如下:
| 指标 | Decisions API | 常规gpt-6-luna调用 |
|---|---|---|
| 典型延迟 | 约150毫秒 | 约1.6秒 |
| 价格 | 每百万输入token $0.10 | 按生成的token计费 |
| 输出token | 无 | 有 |
输出token、缓存读取和缓存写入均不收费。
先行一步的对手
这种方式并非OpenAI首创。由一位前OpenAI研究员创立的TypeSafe AI于2026年9月15日发布了Jev,并将其定位为首个公开的“System One”模型,即为即时分类和结构化概率而打造、而非缓慢深思熟虑的模型。早期用户把它用于高吞吐量的分拣工作,例如分流数千封客服邮件,或按建筑风格、与高速公路的距离为房产房源打标签。
| 项目 | OpenAI Decisions API | TypeSafe AI Jev |
|---|---|---|
| 每百万输入token价格 | $0.10 | $0.042 |
| 输入类型 | 文本和图片 | 仅文本 |
| 主要规格 | 直接读取截图和照片 | 请求上下文64k token |
Jev的价格不到一半,但看不见图像。Decisions API可以接收图片和实时桌面屏幕截图,这正是实时视觉机器人得以实现的关键。对视觉输入的支持似乎是两者之间的决定性差别。
准备工作
- 在OpenAI开发者平台创建API密钥。API用量与ChatGPT订阅分开计费。
- 想不写代码先试一试,可以在同一平台的Decisions Playground中尝试输入和选项列表。
- 要开发应用,可以向Claude Code或Codex等编程智能体描述需求,并把API密钥放在本地.env文件中。
▲ 屏幕与语音输入的即时判断
7个项目及其结果
1. 能发现你走神的专注计时器
这款桌面应用为25分钟的Pomodoro计时器加上了屏幕感知能力。输入目标,比如编程,应用每隔几秒截取所有已连接的显示器画面,并询问Decisions API屏幕内容是否仍符合该目标。偏离任务超过一分钟,它就会通过文本转语音发出提醒。在X上浏览广告时,悬浮球变成橙色,并用语音催促回去写代码;回到工作后,它又缩回原样。一个入门级项目有了视觉和即时分类能力,就变成了主动的监督工具。
2. 无延迟的macOS语音控制
按住一键通按键说话,语音转文本功能会把命令转成文字。随后Decisions API从一份动作列表中选出一项:启动或退出应用、切换应用,或控制浏览器标签页和导航。Claude用约15分钟做出了这个Electron应用,命令的处理时间约为120至280毫秒。按住右侧Option键说出“Open Arc”或“Open Google Chrome”,应用几乎瞬间切换。
开发过程带来两点经验。当动作被组织成多层嵌套结构时,“quit Spotify”的置信度只有67%。把选项拍平成单一列表后,置信度和速度都恢复了。此外,这个应用需要在macOS系统设置中同时获得辅助功能和输入监控两项权限。
3. 清理X信息流中的广告和诱饵帖
一个Chrome扩展把每条帖子的文字和图片发送给Decisions API,询问它是否为广告或低质量的互动诱饵帖,并把被标记的帖子折叠成可展开的细条。Claude大约用4分钟写好并在模拟信息流上完成测试。起初它判定过严,把企业的产品发布和使用了宣传性措辞的普通帖子也隐藏了。让模型专门查找帖子右上角的“Ad”标签,就能解决这个问题。
4. 自动模糊屏幕录像中的隐私信息
FFmpeg每半秒抽取一帧,Decisions API检查每一帧是否含有API密钥、电子邮件地址、电话号码和家庭住址等个人信息,工具再对定位到的位置进行模糊处理。用一段塞满虚假邮件和密钥的1分钟测试录像,得到如下结果:
| 指标 | 结果 |
|---|---|
| 检查的帧数 | 144 |
| 标记的帧数 | 84 |
| 流程总耗时 | 15.8秒,比实时播放快约4.6倍 |
| API成本 | $0.0732 |
此前的做法是把整个视频文件上传到Gemini扫描敏感数据,既慢又繁琐。
5. 用维基百科竞速测速度和成本
在维基百科竞速中,模型在每个页面选择最有希望的链接,从一篇文章跳转到相距甚远的目标文章。三位参赛者同台比拼:Decisions API、Jev,以及作为标准聊天模型的GPT-5.5。
| 路线 | Decisions API | Jev | GPT-5.5 |
|---|---|---|---|
| Banana到Moon landing | 3跳,2.9秒,$0.00327 | 3跳,7.3秒,$0.00272 | 2跳,8.9秒,$0.0944 |
| Taylor Swift到Photosynthesis | 3跳,1.2秒,$0.00242 | 3跳,2.0秒,$0.00179 | 3跳,16.3秒,$0.1277 |
| Pokémon到Roman Empire | 6跳,3.1秒,$0.00268 | 5跳,2.1秒,$0.00136 | 2跳,14.2秒,$0.0678 |
聊天模型有时能找到更短的路径,但专用决策模型每一步往往快约10倍,成本约为其二十分之一到五十分之一。
6. 一张照片算出卡路里
这个移动网页应用通过本地Wi-Fi在iPhone的Safari中打开,界面上只有一个拍照按钮。数据来自免费的USDA FoodData Central列表,Claude把它整理成172个类别、5,412种食品。关键的设计在于从不让模型推算卡路里。Decisions API只回答两个受限的选择题,即食物类别和份量,再通过一次后续调用确定具体食品。随后由普通代码根据数据库的标准重量表计算卡路里。
一张芝士汉堡照片约用1秒、花费$0.000054,被判定为488千卡。而一个裹着培根的8磅巨型墨西哥卷饼被归为特大号卷饼,结果只有964千卡。小、中、大、特大这类固定份量档位,没有推理模型就无法处理这种极端情况。
7. 在原始素材中找出废镜头
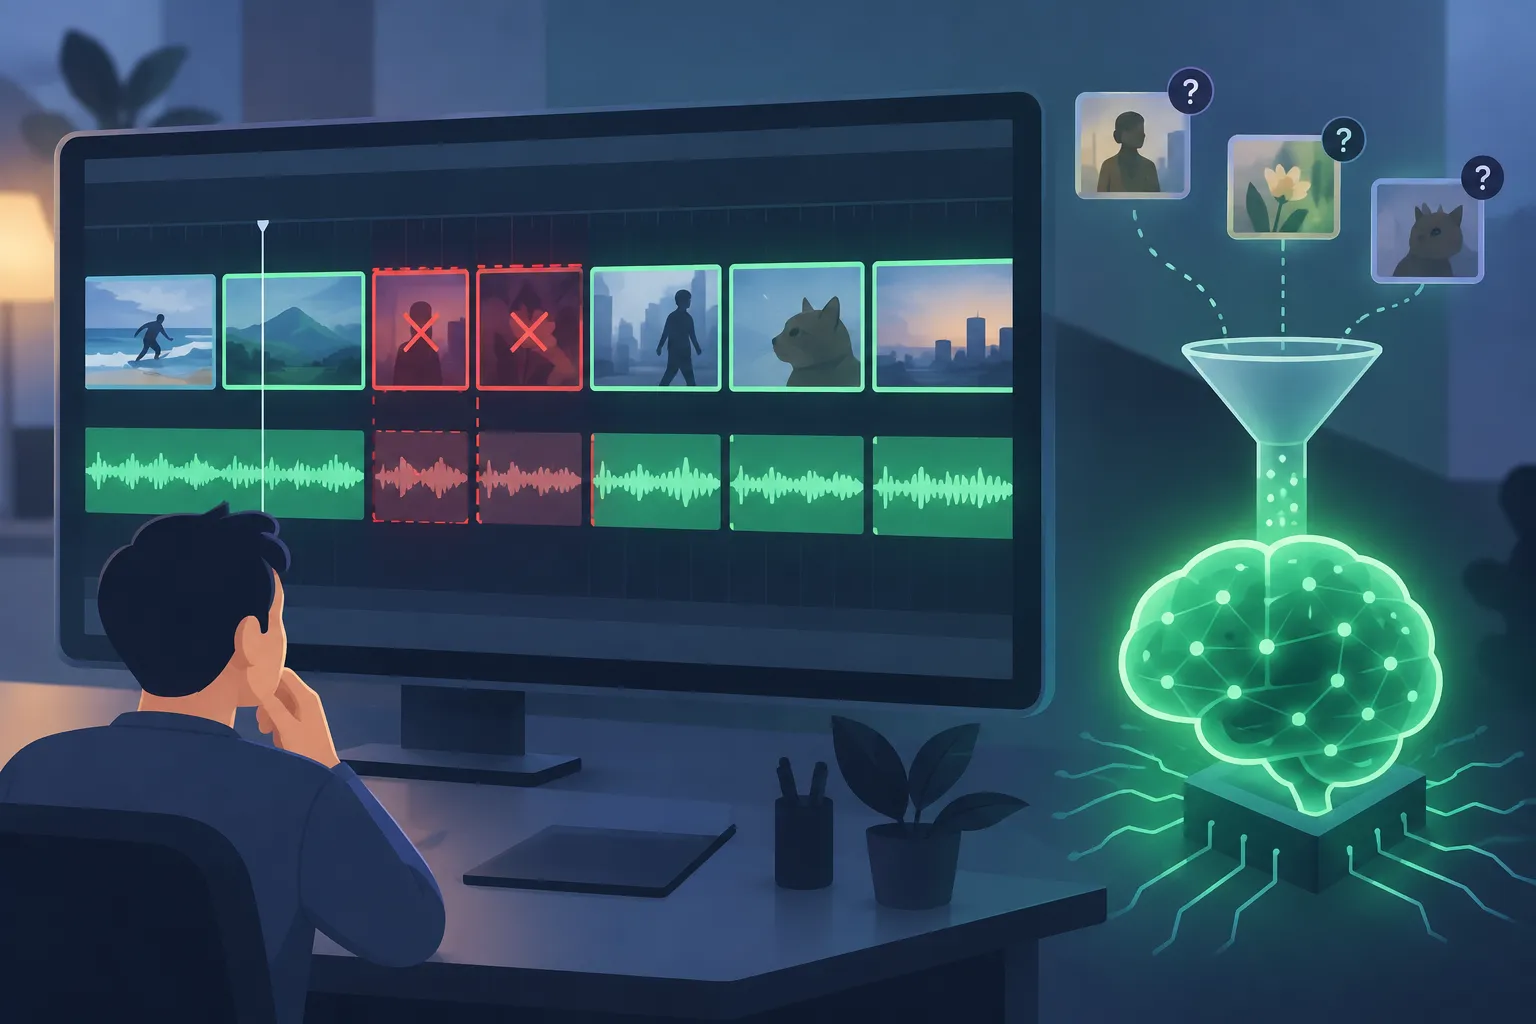
最后一个项目要从原始录像中剪掉口误、起头失败、重说和静音段。在Adobe Premiere Pro中用Opus 5.5剪辑,准确率可达约98%,但每支视频的API费用高达数百美元。因此,第一轮粗筛改由Decisions API承担。Whisper-1带时间戳转写音频,转写文本按句切分,每一行被归类为口误、起头失败、重说、剪辑提示或保留。
| 测试 | 结果 |
|---|---|
| 4分45秒的4K片段 | 1.3秒完成40次判断,7处废镜头全部找出,判断花费$0.0029,转写花费$0.029 |
| 4.25GB原始文件 | 提取音频0.2秒,转写5.7秒,判断1.7秒,标出54处静音和7处废镜头 |
在语句卡顿处,Whisper-1的速度和逐词时间戳的准确度都胜过本地运行的MLX Whisper模型。只把置信度低的行交给Opus这类更大的推理模型,就能形成分层且省钱的剪辑流程。Claude生成的浏览器剪辑界面杂乱难用,但功能正常。
▲ 大模型之前的低成本初筛
依赖它之前需要了解的局限
- 列表之外的事它做不了。让它在浏览器中输入文字,或打开一个没有对应动作的URL,这类语音命令都失败了,因为模型只会在给定的动作中做选择。
- 它会漏掉复杂边缘情况中的微妙差别。这类判断仍需要完整的推理模型。
- 嵌套的选项树会降低置信度。单一的扁平列表效果更好。
- 分类器可能判定过严。出现这种情况时,要像“Ad”标签那样,在提示词中写明需要查找的具体线索。
- 固定档位遇到极端值就会失灵,巨型卷饼就是例子。
从哪里开始
Decisions API适合需要快速、低成本地反复进行有限选择的工作:对屏幕或照片内容做出反应的实时工具、文本或视频帧的批量分拣,以及放在昂贵模型前面的低成本初筛。可以按以下步骤尝试:
- 从工作中挑一项答案落在少数固定类别里的任务,在Decisions Playground中把它作为选项列表来测试。
- 把选项放在单一的扁平列表中,不要做成嵌套的树。
- 让模型选择类别,让查询表和代码给出卡路里或价格等数字。
- 设定置信度阈值,只把低于阈值的条目交给更大的推理模型。
- 需要图像输入就用Decisions API;如果只做纯文本的批量分类且最看重成本,就与Jev一起比较。