Gemini 4是谷歌Gemini系列时隔许久的一次大版本更新。将Gemini 4 Argon High与其他模型放在同一任务上进行的早期对比测试,显示出明显的取舍。它测得的单次任务成本低于GPT-6 Sol Max和Claude Opus 5.5 High,而交互式3D生成结果则参差不齐:既有令人信服的悬索桥,也有几何结构破碎、操控不可靠的场景。这些例子可作为检验生成质量的初步参考,但并不能全面衡量这款模型的能力。
成本对比说明了什么
在一份针对使用工具的AI任务的排行榜上,Gemini 4 Argon High在46个模型中排名第8。该排名综合考虑任务完成情况、工具使用的可靠性以及模型按指令进行调整的难易程度等指标。Gemini 4 Argon High的净改进得分为+7.92%,排名第一的Claude Fable 5.1 Max为+14.55%。
该模型还位于排行榜的帕累托前沿上,即在测得的改进幅度与成本之间各自提供不同取舍的一组模型。Gemini模型一向以成本效率和价格竞争力著称,Argon High在成本与性能曲线上也处于中段。对于在价格与能力之间权衡的团队而言,这一位置有参考意义,但并不意味着每项任务都能取得好结果。
排行榜给出的过去14天单次任务成本中位数(约数)如下:
| 模型 | 单次任务成本中位数 |
|---|---|
| Gemini 4 Argon High | $0.80-0.90 |
| GPT-6 Sol Max | $1.30 |
| Claude Opus 5.5 High | $3.00-4.00或更高 |
按此对比,Gemini 4 Argon High的成本比GPT-6 Sol Max低约三分之一,比Claude Opus 5.5 High低约70%。GPT-6 Luna等更便宜的选择位于成本轴更低的一端,这使Argon High处在颇具吸引力的中等价位。需要说明的是,成本对比中列出的是GPT-6 Sol Max,而下文3D对比使用的是GPT-6.1 Sol Max。
一座经得起检验的桥
在一项测试中,Gemini 4 Argon High使用WebGL生成了一个可交互的金门大桥场景。WebGL是一种在浏览器中显示3D图形的技术。生成结果包含结构连贯的悬索、水面、行驶的船只,以及调节雾气、交通流量、波浪和时段的控件。雾气控件可以正常使用,但调到最强时会遮挡过多画面。
这座桥的结构和氛围与Claude Sonnet 5.5 High的输出相比毫不逊色。GPT-6.1 Sol Max则呈现了更逼真的水面渲染和光照,控件界面也更精致。Gemini 4 Argon High的控件虽能使用,但布局更紧凑、风格更朴素。对于结构明确的场景,这是不错的结果,但不能证明它在各类3D任务中都表现稳定。
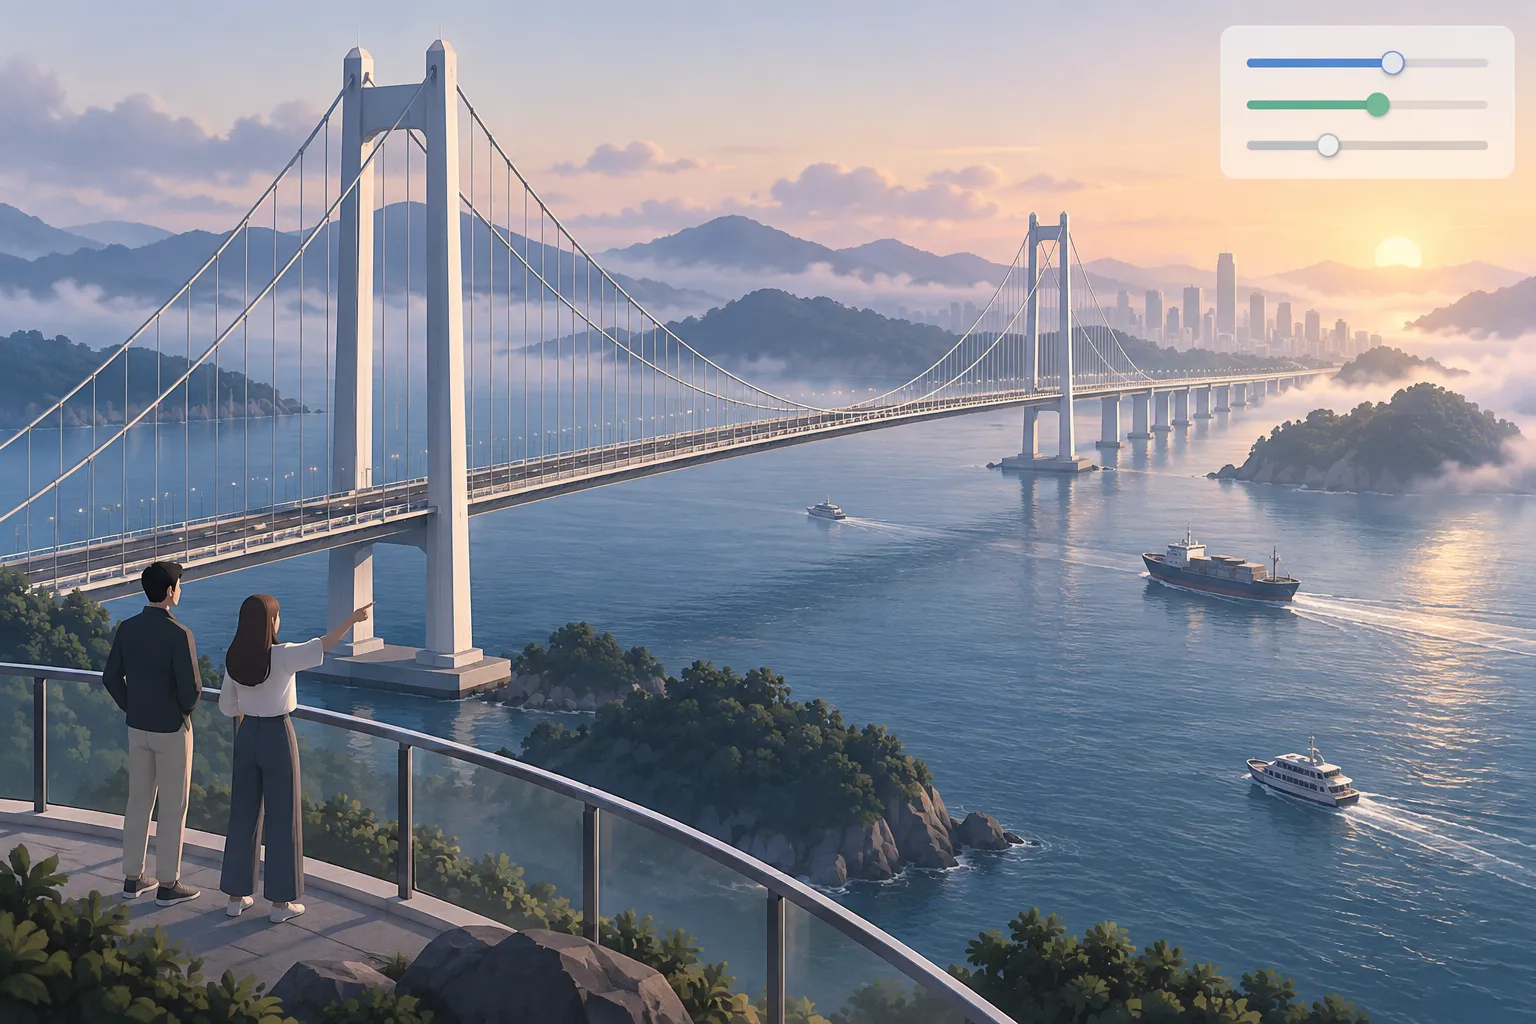
▲ 结构连贯的悬索桥场景
更复杂的场景暴露短板
浮空岛任务要求生成有机地形、植被、瀑布和相互连接的结构。Gemini 4 Argon High生成的地形支离破碎,树木相互重叠,接缝生硬,岛屿下方还有暗色空洞。相比之下,Claude Sonnet 5.5 High生成了连贯的梯田、桥梁和层层倾泻的瀑布;GPT-6.1 Sol Max则呈现了湖泊、雾气和流水效果。从不同角度查看岛屿时,差距尤为明显。
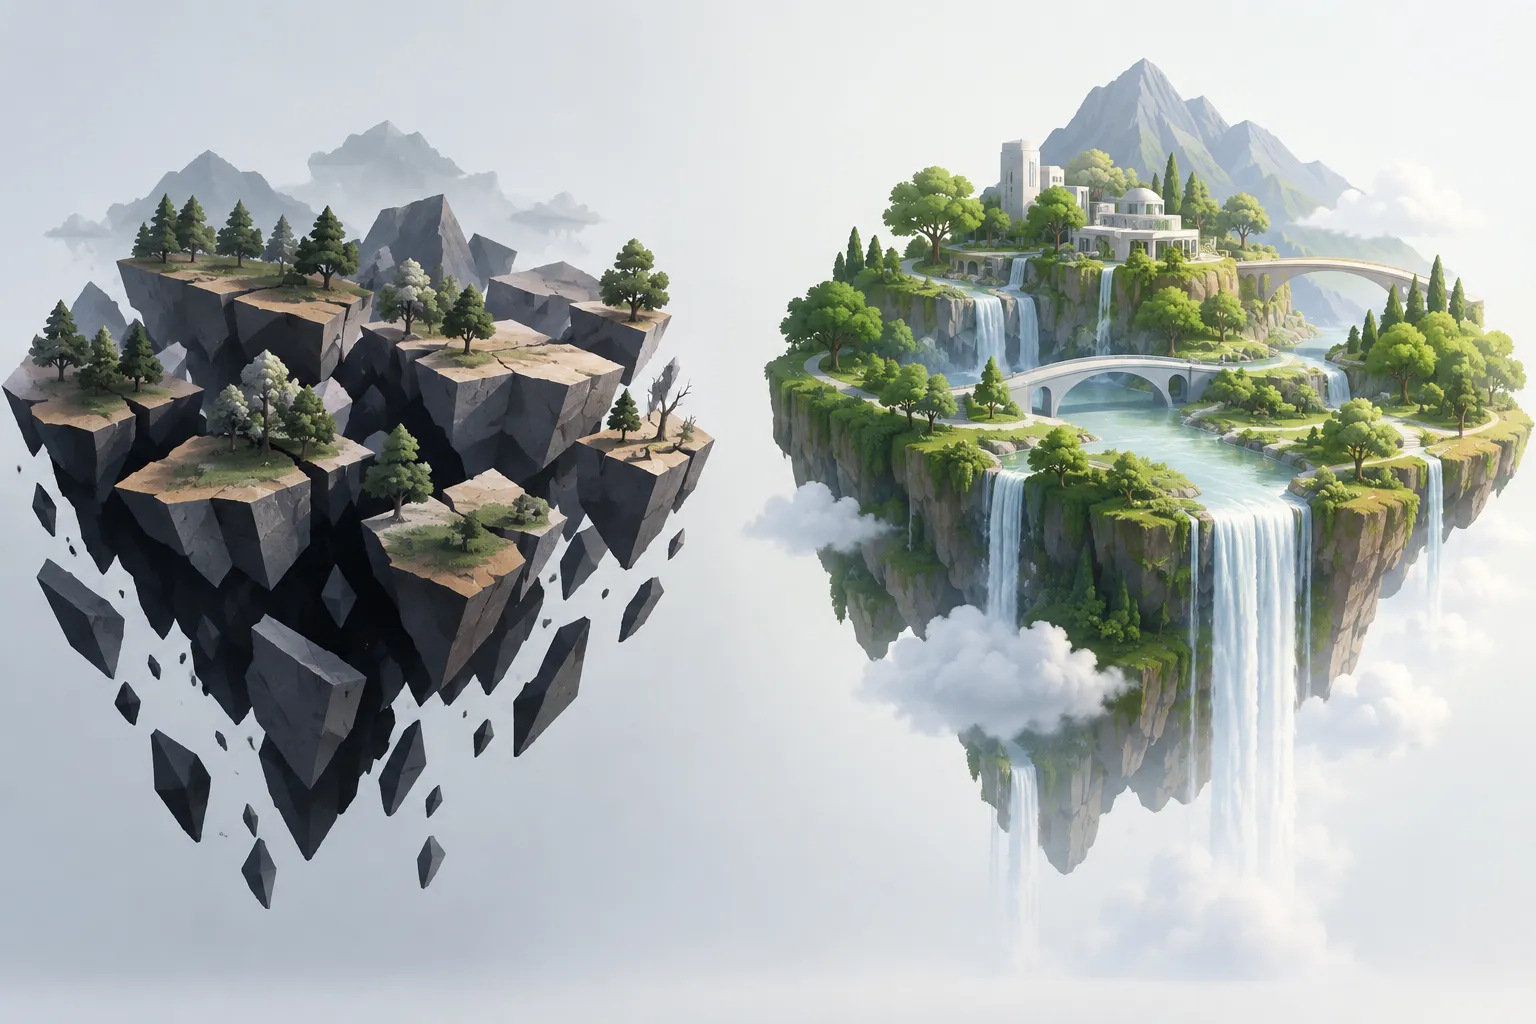
▲ 浮空岛连贯性对比
以巴黎为背景的交互式飞行游戏考验的不只是外观。此前的Gemini模型在游戏生成方面曾显示出潜力,但Gemini 4 Argon High生成的飞机穿环游戏操控迟缓、飘忽不定。飞机撞上建筑,穿过部分场景,还会卡住。作为对比,GPT-6.1 Sol Max的游戏转向反应更灵敏,飞行也更平稳。游戏生成并不是语言模型的主要商业指标,但它暴露了模型在处理复杂物理和游戏逻辑方面的弱点:如果操控和碰撞规则失灵,场景再好看也不够。
建筑类提示词也呈现出类似的分化:整体构图尚可,近看却缺乏一致性。Gemini 4 Argon High搭建了一座带船只和脚手架的阶梯式巴别塔,但其中的工人形象呈方块状,要么静止不动,要么悬浮在地面上方。在对比输出中,GPT-6.1 Sol Max和Claude Sonnet 5.5 High让工人的动作更加连贯,在施工场景中的位置也更合理。
在白宫场景中,Gemini 4 Argon High画出了草坪、树木和喷泉,但屋顶上有一团来历不明的暗色物体,道路也没有顺畅地连接起来。它生成的圣家堂场景中,尖塔顶部错位,周边街道布局也有断开的部分。这样的结果放在半年前或许令人印象深刻,但与如今的前沿模型相比,似乎已经落后。
如何看待初步结果
这些3D任务属于定性检验,而非权威的基准测试。它们可以间接反映指令遵循、结构稳定性、空间感知和一致性等基础能力。Gemini 4 Argon High能较好地遵循基本指令,但提示词越复杂,结果波动越大。如果一个模型在生成游戏操控或3D网格时表现不稳定,那么在数据库模式、代码架构或多步骤工具调用等企业工作中,也可能出现类似的不一致。
对于注重成本的工作,不妨用定义清晰的任务测试Gemini 4 Argon High。比较模型时,应参考帕累托前沿这类兼顾成本的视角,而不只看能力排名。与其依赖开放式提示词,不如明确给出架构要求或数据模式,再同时检查可见结果和交互组件的行为。如果一致性很重要,在仅凭价格选择模型之前,应先比较多次生成的输出并检查失败案例。
实用要点
Gemini 4 Argon High兼具有竞争力的成本优势和出色的大桥场景,但浮空岛、游戏和建筑的例子表明,随着复杂度上升,其一致性并不稳定。较低的实测成本是评估它的理由,而不能替代评估本身。可以从一项有代表性的生产任务入手,严格规定要求,并检查结果在细节和交互最关键的地方是否依然正确。