OpenAI在DevDay上发布的GPT-6.1 Sol,在实测中做出了一个应用之间相互联动的浏览器桌面和两款可玩的3D游戏,但在视觉设计和物理控制任务上,结果参差不齐。它首轮生成的3D画面不如Claude Sonnet 5.5此前在相同任务上的作品精致,而在提供视觉参考后,这一差距有所缩小。
规格与基准测试分数
OpenAI把GPT-6.1 Sol定位为以更低成本提供接近GPT-6 Astra智能的模型。其API价格为每百万输入token $2、每百万输出token $10,与Claude Sonnet 5.5的价格相同。输入和输出token是计算发送给模型和由模型生成内容的单位。价格相同本身并不能说明哪个模型能做出更好的应用。
软件工程基准测试DeepSWE v1.1提供了另一个参考。GPT-6.1 Sol的成绩会随推理设置而变化,这一设置决定模型为任务投入多少计算:
| 推理设置 | DeepSWE v1.1分数 | 每项任务成本 |
|---|---|---|
| High | 75.2% | $0.65 |
| Maximum | 71.9% | $0.97 |
在这一基准上,GPT-6.1 Sol与GPT-6 Astra的基准表现持平,比GPT-6 Sol高出6.4个百分点。更高设置反而得分更低,反映了一个已知现象:模型可能把任务做得过于复杂,超出评测的预期。根据API模型列表,GPT-6.1 Sol的上下文窗口为105万token,输出上限为12.8万token,知识截止日期为2026年4月30日;它可接收文本和图像输入,输出文本。
这些分数衡量的是基准测试表现,而不是游戏的完成度或机械抓取是否成功。应用制作测试能让人更近距离地看到这些结果。
应用之间相互联动的浏览器桌面
最清晰的软件成果是Halo OS,它在最高推理设置下用33分42秒生成。这是一个装在单个HTML文件里的独立浏览器桌面,HTML是浏览器读取并显示网页的格式。它在Google Chrome中打开后,带有窗口、程序坞、启动台、笔记、邮件、合成器,以及更换壁纸和保存会话的工具。部分程序坞和侧边栏图标未能显示,但桌面及其主要应用都能正常运行。
窗口中运行着两款游戏。Signal City提供了低多边形街道、可驾驶的汽车、包裹投递和行人。车辆操控和镜头反应灵敏,不过警车有时会直接出现在玩家车辆旁边甚至上方。Orbital Run让玩家驾驶飞船穿过圆环、避开障碍。跑完全程可获得4216分,并会在桌面的邮件应用中收到一份证书。
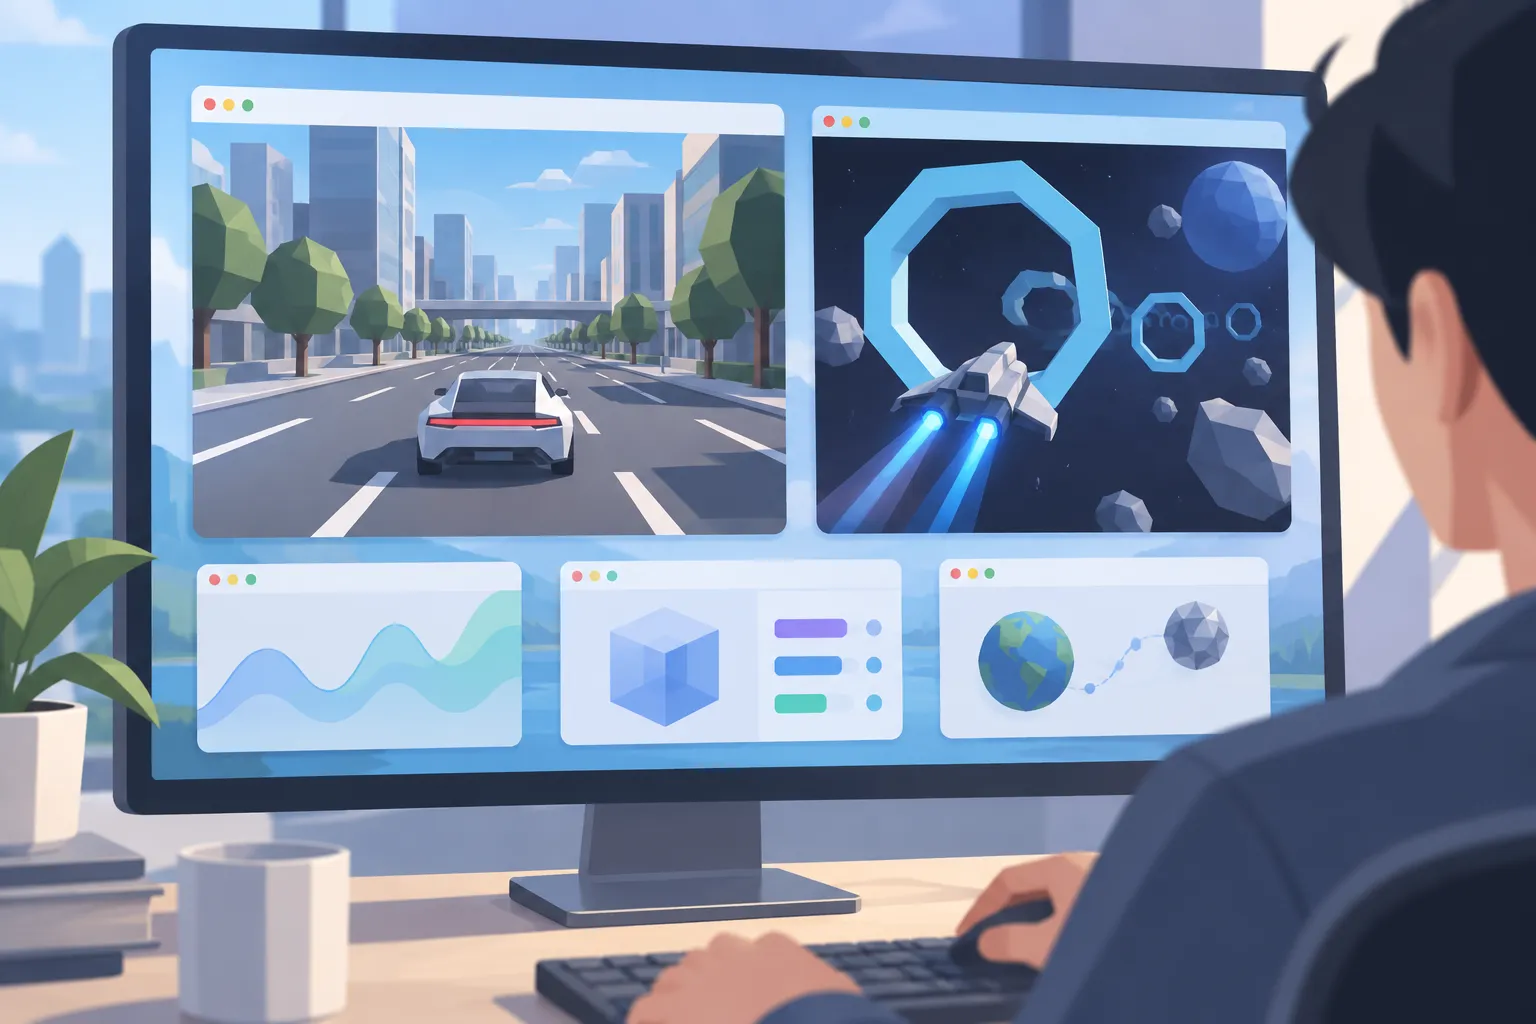
▲ 浏览器桌面中的两款游戏
联动不止于游戏。邮件会反映两款游戏中的动态,笔记可以导出为文本文件,Continuum则能保存并恢复打开的窗口、游戏状态和笔记。对评估而言,这种共享状态比应用数量更重要:它表明生成的桌面能够协调各自独立的功能。视觉方面的评价则不那么正面。Claude Sonnet 5.5前一天的作品显得更精致,而GPT-6.1 Sol生成浏览器系统的速度明显更快,运行也很流畅。
游戏可以玩,但视觉打磨参差不齐
泳池游戏任务要求GPT-6.1 Sol使用3D建模工具Blender和游戏引擎Godot,做出四名可操作的跳水者、水面效果、音效和计分。首轮运行开启了Fast Mode,耗时18分12秒。由于这一设置可能影响了输出质量,项目在清除早先文件并关闭Fast Mode后重新制作。
重新制作耗时约51分钟。后院场景、角色选择、蓄力起跳、空中动作和计分的水花都能正常运作。不过,作为对照的Claude Sonnet 5.5泳池游戏粒子效果更丰富、动画更有表现力,视觉上的幽默感也更强。这说明了在该任务上的视觉质量差距。
滑板项目则显示了指令能在多大程度上改变结果。GPT-6.1 Sol最初交付了一款可玩的C++游戏,包含技巧动作和所要求的慢动作回放,但街道环境显得空旷。在收到一张作为视觉目标的截图,并获准使用多个源文件后,它做出了一个带有倒影、景物和音效的更丰富的滨水场景。行人碰撞仍未实现。这次修改表明,能运行的第一版不必被视为模型最终的视觉水平。
其他测试也印证了功能齐全与真正完成之间的区别。一款浏览器地铁游戏把敌人波次与车站之间的列车移动结合起来,还有可用的武器和后期的强化敌人,不过列车出站的样子显得不真实。一款Old School RuneScape对战复刻游戏在19分30秒内搭建出精细的界面面板和可玩的战斗,但特殊攻击没有按预期响应。这些都是存在具体缺陷、但已相当完整的可运行作品,并非全都打磨完成的游戏。
机械臂未完成任务便停止
在一项物理测试中,GPT-6.1 Sol负责控制网格垫上方的一台机械臂,任务是移动一辆玩具车。在约18分钟的运行中,每当玩具车被移动或翻转,机械臂都会调整轨迹,说明它的摄像头反馈和运动规划能够响应工作区的变化。
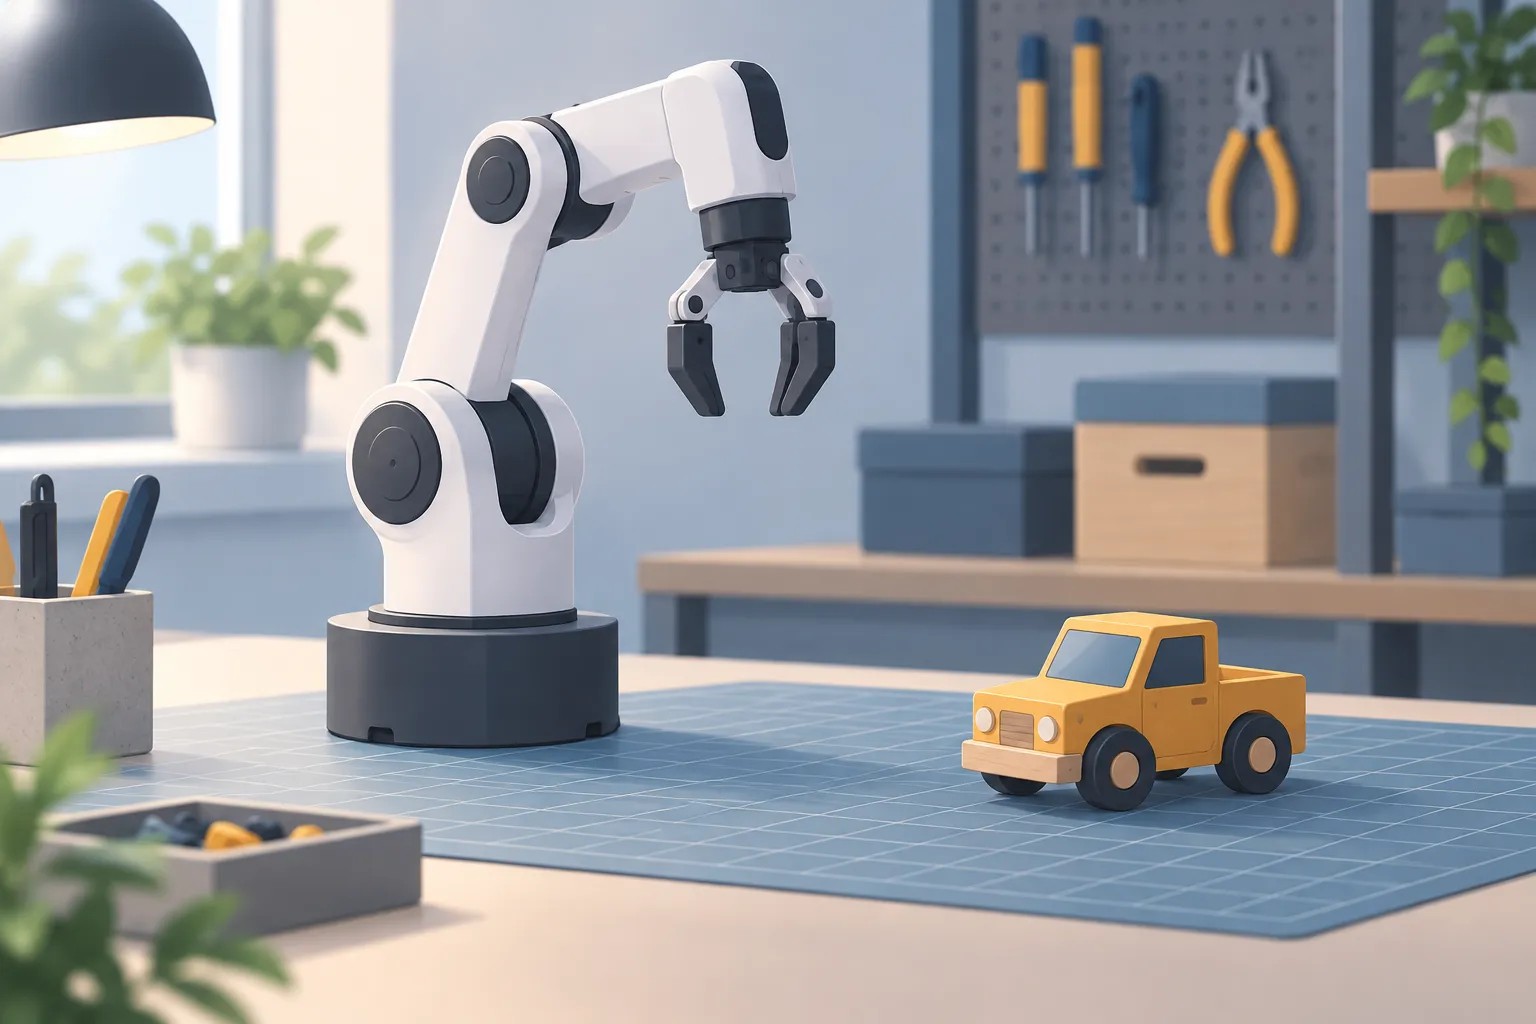
▲ 避开玩具车停下的机械臂
机械臂始终没能稳定抓住玩具车,也未能把它移走。随后,它在远离玩具的位置以直立姿态停了下来。结果是任务失败,但在安全方面有一个有价值的区别:灵敏的追踪没有转化为成功的操作,但系统选择停下,而不是继续做不确定的动作。对于物理任务,是否完成以及失败后的表现,都应纳入评估。
从结果中能得出什么
综合这些测试来看,GPT-6.1 Sol能够构建功能相互联动的交互式软件,在注重逻辑和多步骤行为的任务上尤其如此。它首轮的3D画面并不总是令人印象深刻,机械臂也没能完成搬运。在整轮测试期间,一个ChatGPT Pro账户的每周额度从剩余98%降到95%;这只是单个账户的用量数据,并不能预测其他工作负载。
如果要为应用项目选择模型,就用相同的提示词和约束条件比较候选模型。检查功能是否真正可用,单独查看视觉质量,并确认每个版本如何处理错误或失败的操作。外观重要时,就提供视觉参考。这些结果表明,GPT-6.1 Sol是一个扎实且具成本效益的选择,值得在这类工作中试用,也值得与Claude Opus等顶级模型比较。