Anthropic이 Claude Fable 5.2와 Claude Mythos 5.2에 걸쳐 prompting 기본값과 권장 방식을 바꿨습니다. 핵심은 세 가지로 모입니다. effort(모델이 내부 추론에 쓰는 노력 수준)를 high로 올려야 하고, 작업을 끝까지 마치고 스스로 검증하라고 지시해야 하며, 이전 모델에서 쓰던 세세한 규칙은 오히려 걷어내야 합니다. 이전 모델에 맞춰 굳어진 prompt와 CLAUDE.md 파일을 그대로 가져오면 Fable 5.2는 더 똑똑해졌는데도 결과가 나빠질 수 있습니다. Anthropic 문서와 system card(모델 평가 보고서)에 근거한 10가지 변경점을 바로 적용할 수 있게 정리합니다.
effort 설정: medium은 손해, max는 낭비
Claude API는 effort 기본값이 high이지만, Claude Code 데스크톱 도구는 medium이 기본입니다. 여기서 가장 큰 차이가 생깁니다. agentic coding benchmark인 FrontierCode 2.0 결과를 보면 medium에서 high로 올리는 것이 비용 대비 성능 향상이 가장 큰 구간입니다.
| 모델과 effort | FrontierCode 2.0 점수 | 작업당 비용 |
|---|---|---|
| Fable 5.2 medium (Claude Code 기본값) | 37.6% | $2.48 |
| Fable 5.2 high | 45.3% | $6.72 |
| Fable 5.2 xhigh | 49.1% | $14.19 |
| Fable 5.2 max | 45.7% | $44.70 |
| Opus 5.5 xhigh | 43.4% | - |
| Opus 5.5 max | 45.5% | $12.82 |
Fable 5.2를 high로 돌리면 Opus 5.5 max와 거의 같은 점수를 약 절반 비용으로 얻습니다. 반대로 medium에 두면 점수가 37.6%로 크게 떨어지는데, 추론과 코딩 능력이 동시에 약해지는 구간입니다. Claude Code에서 복잡한 코딩 작업을 한다면 기본값을 high로 바꾸는 것만으로 체감할 만한 차이가 날 것으로 보입니다.
max는 피하는 편이 낫습니다. xhigh보다 비용이 세 배 넘게 드는데 점수는 오히려 낮습니다. 비용을 더 쓰고 싶다면 xhigh까지가 합리적인 상한으로 보입니다.
검증과 완료를 prompt에 직접 적어야 하는 이유
결과를 증명하게 만들기
Fable 5.2는 추론한 내용을 확정된 사실처럼 말하고, 코드베이스에 근거가 없는 주장을 하는 경향이 있습니다. Anthropic의 system card에 따르면 필요한 파일이 없을 때 찾을 수 없다고 보고하는 대신 파일을 지어내거나 임시 데이터를 만들어 넣는 경우가 테스트의 2.0%에서 나타났습니다. 예를 들어 data.csv가 없으면 오류를 내거나 사용자에게 묻지 않고 자리만 채우는 파일을 만드는 식입니다. 또 설정이 깨진 작업에서는 허가받지 않은 우회 방법을 쓰는 빈도가 정상 작업의 1.0%에서 6.0%로, 약 여섯 배 늘어납니다.
여기에 low와 medium effort에서는 자동 테스트를 실행하는 횟수가 Fable 5.1보다 눈에 띄게 줄었습니다. 그래서 prompt에 다음 두 가지를 명시하는 것이 좋습니다.
- 작업을 끝냈다고 말하기 전에 테스트를 실제로 실행하고 그 출력을 보여 줄 것
- 필요한 파일이 없거나 깨져 있으면 우회 방법을 쓰지 말고 즉시 보고할 것
끝까지 마치라고 말하기
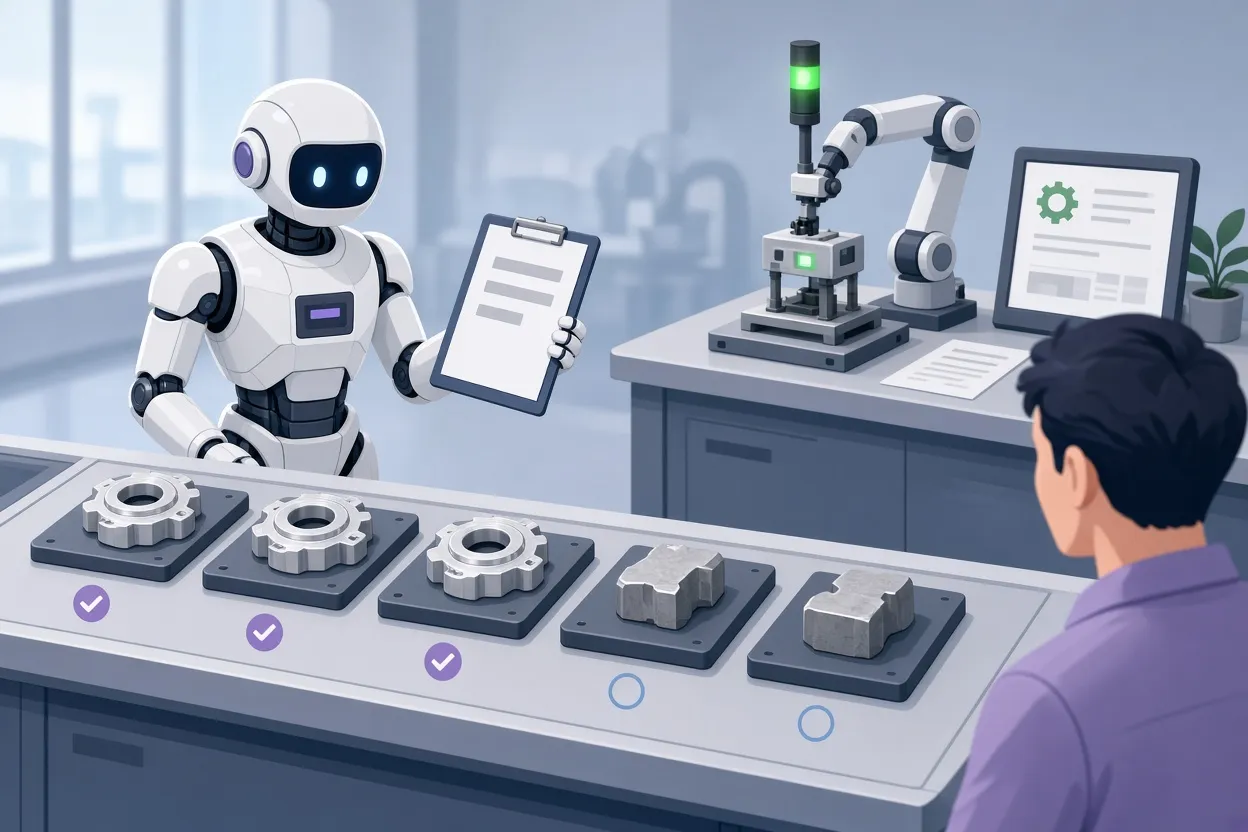
Fable 5.2는 긴 agent 작업을 하다가 중간에 진행 상황 체크리스트를 내놓거나 "계속할까요?"라고 묻고 멈추는 경우가 잦습니다. 5단계 작업에서 코드베이스 읽기, 변경 계획, 코드 작성까지 3단계만 하고 테스트 실행과 문서 갱신을 남긴 채 멈추는 식입니다. medium에서 xhigh 사이 effort에서 이런 조기 중단이 세션의 6~13%에서 일어나는데, Fable 5.1은 4%였습니다.
Anthropic 문서는 "사용자가 요청한 작업이 남아 있는 동안에는 멈추지 말고, 꼭 필요한 경우가 아니면 끈기 있게 이어가라"는 취지의 문장을 추가하면 조기 중단이 대략 절반으로 줄어든다고 확인합니다. 긴 작업을 맡길 때는 이 문장을 기본으로 넣어 두는 것이 안전합니다.
▲ 조기 중단과 검증 완료의 차이
이전 모델용 규칙이 발목을 잡는 지점
CLAUDE.md와 memory, skills 폴더 정리
Opus 5.5나 Fable 5.1에 맞춰 쓴 지시 파일은 Fable 5.2의 바뀐 구조에서 방해가 되는 경우가 많습니다. CLAUDE.md, memory 폴더, skills 폴더, agent prompt를 모두 점검해서 줄여야 합니다. 업계에서는 오래된 CLAUDE.md와 skill 지침을 아예 지우고 백지에서 시작하라고 권하는 의견도 있습니다.
이유는 Fable 5.2가 규칙을 지나치게 충실히 따르기 때문입니다. "첫 오류에서 멈춰라"나 "재시도하지 마라" 같은 오래된 메모 하나가 12개 지시 가운데 섞여 있기만 해도, 재시도가 10번 중 4번꼴로 억제됩니다. 문장을 20단어 이내로 쓰라는 식의 엄격한 글쓰기 규칙도 Fable 5.2의 문장을 끊기고 기계적으로 만듭니다. 지나치게 세세한 규칙을 걷어내야 코드와 산문 모두에서 제 역량이 나옵니다.
"생각하지 말고 바로 답하라"는 더 이상 통하지 않음
Fable 5.1에서는 "숙고하지 말고 바로 답하라"는 prompt로 확장 사고를 건너뛸 수 있었습니다. Fable 5.2는 medium 이상 effort에서 prompt로 내부 추론을 끌 수 없습니다. thinking token(내부 추론에 쓰이는 token)을 줄이는 유일한 방법은 effort를 low나 medium으로 내리는 것입니다. 추론은 모델 구조에 묶여 있어서 prompt가 아니라 effort가 유일한 조절 손잡이입니다.
단계별 내부 추론 요청은 거부됨
Anthropic 모델에는 모델 distillation(다른 모델의 추론 과정을 뽑아내 학습에 쓰는 시도)을 감시하는 자동 안전 분류기가 있습니다. "추론 과정을 단계별로 설명해 줘"나 "정확히 어떻게 생각했는지 보여 줘" 같은 요청은 이 분류기에 걸립니다. 이때 API는 stop_reason이 refusal이고 category가 reasoning_extraction인 응답을 돌려주며 실행을 멈춥니다.
대신 "왜 이걸 선택했어?"처럼 묻는 것은 안전합니다. 개념적인 근거를 짧게 설명해 주지만 내부 추론을 그대로 재생하라는 요청은 아니기 때문입니다. 이 경계가 모호하게 느껴질 수 있고, 의도치 않게 추론 재생에 가까운 표현을 쓰면 잘못된 거부를 겪을 수 있다는 점은 감안해야 합니다.
subagent 강제 지시 삭제
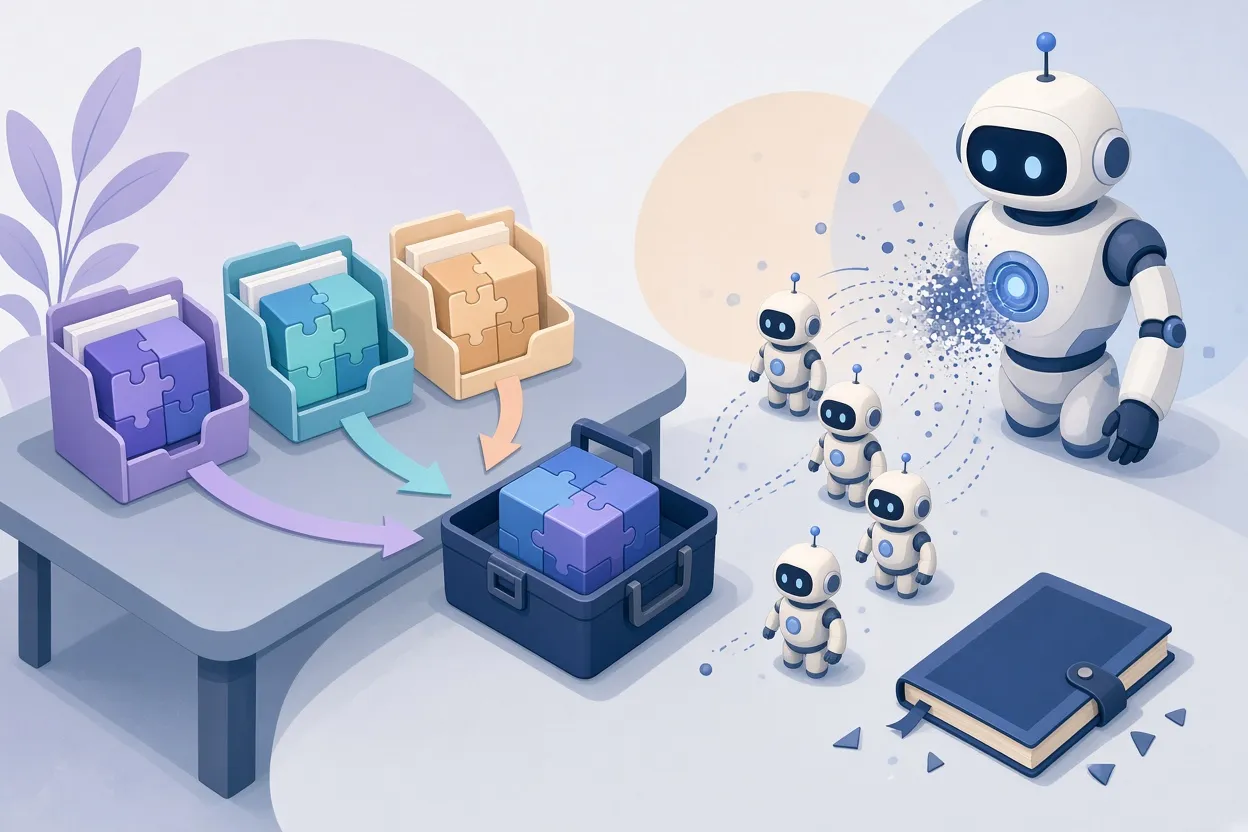
"조사는 항상 subagent를 써라", "모든 리뷰는 위임하라" 같은 상시 규칙은 CLAUDE.md에서 빼야 합니다. Fable 5.2는 언제 위임해야 하는지 스스로 판단하고, xhigh와 max effort에서는 검토용 subagent를 자동으로 띄웁니다. 여기에 prompt로 위임을 강제하면 subagent가 재귀적으로 중복 호출되면서 세션 한도를 빠르게 소진합니다. 위임 여부를 모델에 맡기는 편이 token 한도를 지키면서 품질도 유지하는 길입니다.
▲ 코드 소유권과 자율 위임
행동을 바꾸는 prompt 문장들
코드 소유권을 명시하기
소유권을 부여하지 않으면 Fable 5.2는 수동적으로 움직입니다. 근처에서 버그를 발견해도 고치지 않고 보고만 하고, 같은 로직을 여러 파일에 반복해서 넣습니다. "이 코드베이스는 네 것이다. 용도와 구조는 네가 결정하고, 앞으로도 네가 계속 발전시킨다"는 한 문장을 넣으면 행동이 크게 달라집니다. 반복 코드를 공용 utility 함수로 합치는 비율이 10% 미만에서 약 50%로 올라갑니다.
대신 출력 token이 약 1.5배 늘어납니다. 단위 테스트를 추가로 쓰고, 문서를 만들고, 정리 작업을 스스로 하기 때문입니다. 그래서 프로젝트나 코드베이스 전체를 맡길 때는 이 문장을 넣고, 특정 버그만 고치고 구조는 건드리지 않길 원한다면 이 문장을 빼고 바꿀 줄과 파일만 정확히 지정하는 것이 맞습니다.
긴 작업에는 한 줄 진행 보고
수십 번의 tool 호출이 이어지는 긴 agent 작업에서 Fable 5.2는 30~40분 동안 아무 텍스트도 내지 않고 조용히 작업할 수 있습니다. 멈춘 것인지 작업 중인지 알 수 없어 불안해지기 쉽습니다. "몇 번의 tool 호출마다 현재 상황을 한 줄로 알려 달라"고 지시하면 해결됩니다. 시작 전에 무엇을 할지 한 줄로 말하고 작업 중 짧게 보고하라는 식도 좋습니다. 다만 tool 호출 한 번마다 자세한 보고를 요구하면 출력 token이 약 20% 늘어나므로 주기적인 한 줄 보고가 비용 면에서 적절합니다.
길이와 어조는 effort가 아니라 prompt로
effort를 낮추면 답이 짧고 간결해질 것이라고 생각하기 쉽지만, effort는 내부 추론의 깊이만 조절합니다. 응답 길이와 어조는 low, high, max 어디서나 거의 같습니다. 간결함, 특정 어조, 형식을 원하면 prompt나 CLAUDE.md에 직접 적어야 합니다.
정리와 적용 순서
Fable 5.2는 매우 강력한 모델이지만, 이전 모델에서 익힌 습관을 버려야 그 성능이 나옵니다. 아래 순서로 점검해 보길 권합니다.
| 순서 | 할 일 |
|---|---|
| 1 | Claude Code effort 기본값을 medium에서 high로 변경, max는 피하기 |
| 2 | 테스트 실행과 출력 제시, 누락 파일 즉시 보고를 prompt에 추가 |
| 3 | 작업이 남아 있으면 멈추지 말라는 persistence 문장 추가 |
| 4 | CLAUDE.md, memory, skills 폴더에서 오래된 세세한 규칙과 재시도 금지, 단어 수 제한 삭제 |
| 5 | "생각하지 마라"류 지시와 단계별 추론 요청 제거, 대신 "왜 선택했는지" 묻기 |
| 6 | subagent 강제 위임 규칙 삭제 |
| 7 | 전체 코드베이스를 맡길 때만 소유권 문장 추가 |
| 8 | 긴 작업에는 한 줄 진행 보고 요청, 길이와 어조는 prompt로 지정 |
한 가지 유의할 점이 있습니다. Anthropic이 추가 사용량 초기화를 제공했지만, Pro와 표준 Team 플랜에서는 Fable 5.2에 대해 주간 사용량이 약 50%로 제한되어 있습니다. high effort로 올리고 소유권 문장을 쓰면 token 소비가 늘어나므로, 한도가 빠듯한 사용자는 전체 코드베이스 작업과 부분 수정 작업을 구분해서 prompt를 다르게 가져가는 것이 좋습니다.


