Google Cloud AI Research와 Northwestern University 연구진이 공개한 Harness²는 AI agent(스스로 도구를 써서 여러 단계의 작업을 처리하는 AI)의 성능을 모델 학습 없이 끌어올리려는 연구용 오픈소스입니다. 모델은 그대로 두고, 모델을 둘러싼 지시문과 규칙, 도구 설정 파일을 agent가 작업 도중에 직접 고치게 합니다. Gemini 3.5 Flash에 국제 중재 사건의 명령서 초안을 검토하는 법률 과제를 맡긴 시험에서는 한 번 고친 뒤 55개 점검 항목 가운데 통과한 항목이 20개에서 22개로 늘었습니다. 개선 폭은 작지만, 같은 업무를 되풀이하는 팀이라면 눈여겨볼 만한 방식으로 보입니다.
agent의 실력은 모델과 harness가 함께 만든다
지금까지 AI agent를 더 낫게 만드는 연구는 주로 기반 모델을 다시 학습시키거나 fine-tuning(이미 학습한 모델을 특정 작업에 맞게 더 학습시키는 방법)으로 가중치를 바꾸는 쪽이었습니다. Harness²는 출발점이 다릅니다. agent를 ’모델 더하기 harness’로 정의합니다. harness는 모델의 행동을 이끄는 주변 장치 전체, 곧 지시문과 파일, 도구, 제약 조건, 설정 환경을 묶어 부르는 말입니다.
이 구조에서 모델의 가중치는 처음부터 끝까지 잠겨 있습니다. agent에게 주어지는 권한은 작업을 하면서 자신의 harness를 고쳐 쓰는 것뿐입니다. 모델을 건드리지 않으니 새것을 배우다 기존 능력을 잃는 catastrophic forgetting(파국적 망각)이 생기지 않고, 학습 비용도 들지 않습니다.
새로 들어온 직원을 떠올리면 이해하기 쉽습니다. 첫날에는 실수를 하지만 메모를 남기고 점검표를 만들어 둘째 날에는 훨씬 잘 해냅니다. Harness²는 이 되먹임 과정을 agent에 옮겨 놓았습니다. 이때 agent는 정답지를 보지 않고, 주어진 평가 기준에 비춰 스스로 결과를 판단합니다.
harness를 이루는 파일 8개
Harness²는 모델을 여덟 가지 파일로 감쌉니다. agent가 고칠 수 있는 대상이 바로 이 파일들입니다.
| 파일 | 맡는 일 |
|---|---|
| system prompt | agent에게 주는 기본 지시문 |
| guardrail | 꼭 지켜야 할 규칙과 안전장치 |
| 메모리 | 앞선 작업에서 남긴 기록 |
| tool guidance | 도구를 쓰는 방법에 관한 지침 |
| subagent | 일을 나눠 맡는 하위 agent |
| skill | 특정 분야의 작업 요령을 담은 지침서 |
| 실행 스크립트 | agent가 직접 돌리는 코드 |
| runtime plugin | 실행 도중 동작에 끼어드는 확장 기능 |
고치기 전에 하나씩 시험하는 다섯 단계
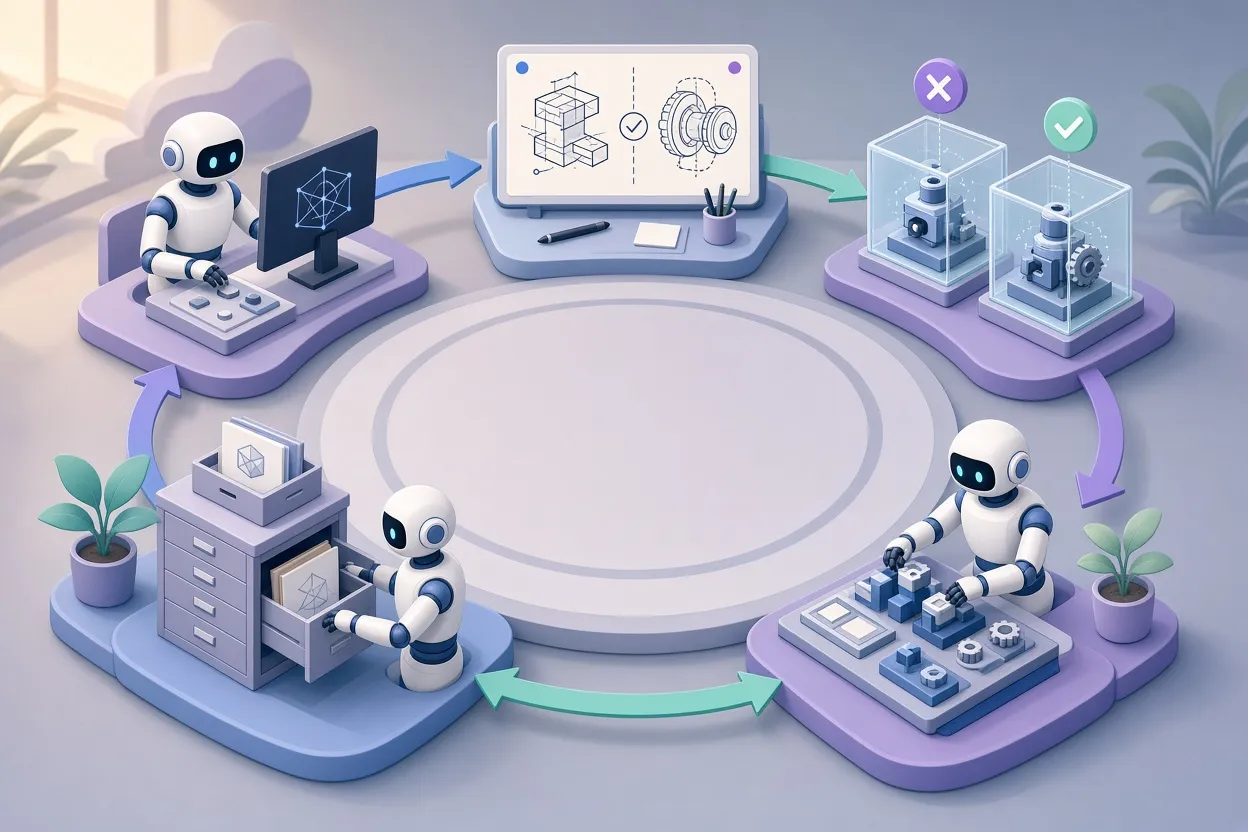
Harness²의 자기 개선은 다섯 단계로 돕니다. 연구진은 구독 서비스의 요금 크레딧을 청구서, 장애 기록과 맞춰 스프레드시트 하나로 정리하는 재무 대조 업무를 예로 들어 이 순환을 설명합니다. 빈칸과 두 번 집계된 행까지 처리해야 하는 일입니다.
- 기준 실행: 손대지 않은 harness로 과제를 처음 수행합니다.
- 개선안 제안: 어떤 일에나 통하는 일반 개선안과 그 분야의 전문 지식을 담은 개선안, 두 종류를 만듭니다.
- 개별 시험: 개선안을 하나씩 같은 과제에 적용해 효과를 확인합니다.
- 조합: 시험을 통과한 개선안만 모아 최종 harness를 만들고 과제를 다시 수행합니다.
- 회고: 이번 작업에서 얻은 교훈을 오래 보관하는 라이브러리 파일에 적어 다음 실행이 물려받게 합니다.
핵심은 3단계입니다. 연구진은 sandbox(실제 환경과 분리된 시험 공간)에서 미리 시험하지 않고 harness 파일을 무작정 고치면 정확도가 오히려 떨어지는 경우가 많다는 점을 확인했습니다. 고칠 점을 찾는 능력만큼, 고친 내용이 실제로 효과가 있는지 가려내는 절차가 중요하다는 뜻으로 읽힙니다.
▲ 다섯 단계 자기 개선 순환
Gemini 3.5 Flash에 법률 과제를 맡긴 결과
시험 과제는 Google 공식 benchmark(AI 성능을 재는 표준 시험) 모음에 들어 있는 법률 과제입니다. 가벼운 모델인 Gemini 3.5 Flash가 International Chamber of Commerce(ICC) 중재 사건의 ‘절차 명령 제3호’ 초안을 검토합니다. agent는 초안을 이전 절차 명령, 전략 메모와 비교해 고친 곳을 표시한 redline 문서와 주요 이의 사항을 담은 서한을 만들어야 합니다.
첫 시도에서 agent는 자동 점검 55개 가운데 20개를 통과해 36.4점을 받았습니다. 이어 자신이 빠뜨린 부분을 진단하고 harness 파일 두 개를 고쳤습니다. 중재 검토 전용 skill 지침서인 SKILL.md를 새로 만들고, 중재 검토 과제일 때 이 skill을 불러오라는 조건부 지시를 systemprompt.md에 덧붙였습니다. 새 skill은 이전 절차 명령과 한 줄씩 엄격하게 대조하고, 심리 기간과 증거 규칙을 정해진 틀에 따라 점검하게 했습니다.
| 항목 | 첫 시도 | harness 수정 뒤 |
|---|---|---|
| 통과한 점검 항목 | 55개 중 20개 | 55개 중 22개 |
| 점수 | 36.4점 | 40.0점 |
| 실행 시간 | 446.4초(약 7분 30초) | 736.9초(약 12분) |
개선안을 합쳐 최종 harness를 만드는 데는 45.0초가 걸렸고, 개선과 재실행 전체에 든 API 비용은 약 $11였습니다. 세부 결과를 보면 첫 번째 절차 명령을 상호 참조한 항목, 4.5~5일짜리 심리 일정을 되살린 항목, 표준 비용 조항을 지운 항목까지 세 기준이 실패에서 통과로 바뀌었습니다. 반면 전에는 통과하던 취리히 심리 장소 관련 기준 하나는 실패로 돌아섰습니다.
▲ 중재 명령서 검토 시험
연구진의 결과와 견줘 본 개선 폭
3.6점이라는 향상은 연구진이 논문에 실은 결과와 나란히 놓으면 의미가 분명해집니다.
| 구분 | 개선 전 | 한 번 개선 뒤 |
|---|---|---|
| 같은 중재 과제, 고성능 모델의 최고 사례 | 44.4점 | 94.5점 |
| 법률 과제 전체 평균 | 79.9점 | 81.9점 |
| 같은 중재 과제, Gemini 3.5 Flash | 36.4점 | 40.0점 |
최고 사례에서는 한 번의 개선으로 점수가 44.4점에서 94.5점까지 뛰었지만, 법률 과제 전체로 보면 평균 향상 폭은 2.0점이었습니다. Gemini 3.5 Flash의 3.6점 향상은 이 평균적인 흐름과 비슷한 수준입니다. 한 번 돌릴 때마다 큰 도약을 기대하기보다, 대개는 몇 점씩 오르고 과제에 따라 가끔 크게 뛰는 정도로 보는 편이 현실적으로 보입니다.
점수가 크게 오른 다섯 사례
논문에는 agent가 harness를 고쳐 점수를 크게 올린 사례도 실려 있습니다. 어느 사례에서도 모델은 그대로이고, 바뀐 것은 일하는 습관과 규칙뿐입니다.
| 과제 | agent가 고친 harness | 점수 변화 |
|---|---|---|
| 영화 제작자의 예산 메모 대조 | 내놓는 수치를 모두 다시 열어 확인하는 일반 guardrail | 43.1점에서 77.8점 |
| 채널별 영업 실적 집계 | 파생 수수료율을 가중 평균으로 계산하라는 skill 지침 | 23.6점에서 100.0점 |
| 오프라인 단일 페이지 웹앱 | 외부 CDN(웹 파일을 대신 전송하는 서버망) 호출을 막고 JavaScript, CSS, 데이터를 파일 안에 담게 하는 guardrail | 64.0점에서 100.0점 |
| 리서치 종합 | 처리 한도가 가까워지면 조회를 멈추고 초안부터 쓰게 하는 runtime plugin | 72.0점에서 100.0점 |
| 코딩 benchmark | 가짜 코드 형식의 도구 호출을 막는 엄격한 tool guidance | 60.0점에서 100.0점 |
리서치 종합 과제는 context(모델이 한 번에 다룰 수 있는 정보의 양)와 예산 한도에 걸려 시간 초과가 잦던 과제입니다. agent는 token(AI가 글을 처리하는 단위) 한도가 가까워지면 조회를 멈추게 하는 deliverable_watchdog이라는 plugin을 직접 만들어 결과물 초안을 일찍 쓰게 했습니다. 코딩 과제에서는 모델이 정식 형식이 아닌 가짜 코드 형태로 도구를 부르던 오류를, 정식 도구 호출만 쓰도록 지침을 더해 없앴습니다.
써 보기 전에 알아 둘 조건과 한계
Harness²는 GitHub에 harness2라는 저장소로 공개돼 약 6,000개의 star(관심 표시)를 받았습니다. 다만 Google이 지원하는 기업용 상용 제품이 아니라 Google Cloud AI Research와 Northwestern University의 실험적인 연구 코드입니다.
설치 환경도 개발자를 전제로 합니다.
- 운영체제: Linux
- 언어와 도구: Python 3.12, uv 패키지 관리자, Node.js 20 이상
- 격리 실행: sandbox를 위한 Docker
- 클라우드: Vertex AI 접근을 인증한 Google Cloud CLI
Linux와 Docker, Python, 클라우드 명령줄 도구를 다뤄야 하므로 개발 지식이 없는 실무자가 바로 쓰기는 아직 어렵습니다. 자동 수정이 늘 득이 되는 것도 아닙니다. 법률 과제 시험처럼 고친 뒤에 통과하던 기준이 실패로 돌아서는 일이 생길 수 있습니다. 시간과 비용도 더 듭니다. 두 차례 실행에 20분 가까이 걸렸고, 과제 하나의 개선 주기에 약 $11가 들었습니다.
매주 되풀이하는 agent 업무부터
Harness²가 보여 준 방향은 분명합니다. 모델을 그대로 두더라도 agent가 자신의 harness 파일을 다듬으면 성능이 조금씩 쌓여 오를 수 있습니다. 그래서 이 방식은 매주 비슷한 작업을 되풀이하는 기업 팀에 특히 잘 맞습니다. 같은 일을 여러 번 할수록 앞서 얻은 교훈을 다시 쓸 수 있기 때문으로 보입니다.
Harness²를 당장 설치하지 않더라도, 자체 agent를 운영하는 팀이라면 다음 원칙은 바로 적용해 볼 수 있습니다.
- 모델을 바꾸기 전에 system prompt, 도구 정의, guardrail 같은 harness 파일부터 손봅니다.
- prompt나 skill을 고칠 때는 sandbox에서 하나씩 시험하고, 효과가 확인된 수정만 실제 시스템에 합칩니다.
- 개선 사항을 두 갈래로 나눕니다. 출력 파일을 다시 확인하는 것 같은 일반적인 작업 습관과, 중재 규범처럼 그 분야에만 필요한 지식입니다.
- 오래 도는 리서치 agent에는 token이나 실행 예산이 바닥나기 전에 초안부터 만들게 하는 감시 plugin을 둡니다.
- 웹 결과물은 필요한 스타일, 스크립트, 데이터를 모두 파일 안에 넣어 CDN 없이도 오프라인에서 똑같이 동작하게 합니다.
- tool guidance에 가짜 코드 형식의 도구 호출을 금지하고 정식 API 형식으로만 도구를 부르라고 적어 둡니다.