OpenAI가 내놓은 Decisions API는 답을 글로 써 내려가지 않고, 미리 정해 둔 선택지 가운데 하나를 고르는 데 특화한 인터페이스입니다. 텍스트나 이미지와 함께 후보 답 목록을 보내면 선택지마다 확률을 돌려주고, 응답은 약 150밀리초 만에 옵니다. 집중 타이머, 음성 명령, 피드 정리, 화면 가리기, 칼로리 계산, 영상 컷 편집까지 7가지 사례로 시험해 보면 이 API가 잘하는 일과 맡기면 안 되는 일의 경계가 꽤 분명하게 드러납니다.
글을 쓰지 않고 고르기만 하는 모델
일반 대화형 모델은 답을 token(모델이 글을 처리하는 단위) 하나씩 차례로 생성합니다. 답이 길어질수록 시간이 걸리고 생성한 token마다 요금이 붙습니다. Decisions API는 이 과정을 건너뜁니다. 정해 둔 선택지 각각의 확률을 한 번의 계산으로 구하기 때문에 출력 token이 아예 없습니다.
예를 들어 ’주문 금액이 두 번 청구됐어요’라는 고객 문의를 Billing, Technical, Shipping, Other 네 선택지와 함께 보내면 Billing을 100% 확신도로 돌려줍니다. 오픈소스 1인칭 슈팅 게임을 사람 손 없이 플레이하는 봇도 같은 원리입니다. 게임 화면 캡처와 좌표 정보를 이동 선택지(전진, 후퇴, 옆으로 이동)와 행동 선택지(사격, 재장전, 점프)에 짝지어 1초에도 여러 번 판단하게 합니다.
OpenAI가 밝힌 응답 시간은 약 150밀리초로, 같은 gpt-6-luna 모델을 일반 방식으로 부를 때의 약 1.6초보다 10배가량 빠릅니다. 요금은 입력 token 100만 개당 $0.10이고 출력 token, 캐시 읽기·쓰기에는 따로 요금이 붙지 않습니다.
먼저 나온 Jev와 무엇이 다른가
이 방식을 처음 내놓은 곳은 OpenAI가 아닙니다. 전직 OpenAI 연구자가 세운 TypeSafe AI가 2026년 9월 15일 Jev를 발표하면서 첫 공개 ‘System One’ 모델이라고 소개했습니다. 입력을 즉시 분류해 구조화된 확률을 내놓는 모델이라는 뜻입니다. 초기 사용자들은 수천 건의 고객 지원 이메일을 분류하거나, 부동산 매물을 건축 양식이나 고속도로와의 거리 같은 세부 특징으로 태그하는 데 Jev를 썼습니다.
| 항목 | OpenAI Decisions API | TypeSafe AI Jev |
|---|---|---|
| 입력 token 100만 개당 요금 | $0.10 | $0.042 |
| 입력 형식 | 텍스트, 이미지 | 텍스트만 |
| 특징 | 화면 캡처와 사진을 직접 해석 | 요청 context 64k token |
Jev는 값이 절반에도 못 미치지만 이미지를 볼 수 없습니다. Decisions API는 이미지와 데스크톱 화면 캡처를 바로 해석하므로 화면을 보고 판단하는 실시간 봇을 만들 수 있습니다. 두 서비스를 가르는 가장 큰 차이는 이 시각 입력으로 보입니다.
시작하기 전에 준비할 것
- OpenAI 개발자 플랫폼에서 API 키를 만듭니다. API 요금은 ChatGPT 구독과 따로 청구됩니다.
- 코드 없이 먼저 시험하려면 개발자 플랫폼의 Decisions Playground에 입력과 선택지를 넣어 봅니다.
- 앱을 만들 때는 Claude Code나 Codex 같은 coding agent(코드를 대신 짜고 실행하는 AI 도구)에 만들 내용을 설명하고, API 키는 로컬 .env 파일에 둡니다.
▲ 화면과 음성을 즉시 판단하는 도구
7가지 사례로 본 쓰임
1. 딴짓을 잡아내는 집중 타이머
25분짜리 Pomodoro 타이머에 화면 감시 기능을 붙인 데스크톱 앱입니다. 할 일을 ’코딩’으로 정하면 앱이 몇 초마다 모든 모니터 화면을 캡처해 지금 화면이 목표와 맞는지 Decisions API에 묻습니다. 목표에서 1분 넘게 벗어나면 text-to-speech(글을 음성으로 읽어 주는 기술)로 경고합니다. 실제로 X에서 광고 글을 넘겨 보자 화면의 둥근 위젯이 주황색으로 바뀌며 코딩으로 돌아가라고 말했고, 작업으로 돌아오자 원래 모양으로 줄어들었습니다. 흔한 입문용 타이머 앱이 시각 입력과 즉시 분류를 만나 능동적인 감시 도구가 된 셈입니다.
2. 지연 없는 macOS 음성 제어
키를 누른 채 말하면 speech-to-text(음성을 글로 바꾸는 기술)로 명령을 글로 바꾸고, Decisions API가 앱 열기·끄기, 앱 전환, 브라우저 탭 이동 같은 행동 목록에서 하나를 고릅니다. Claude가 약 15분 만에 Electron 앱으로 만들었고, 명령 처리 시간은 120~280밀리초였습니다. 오른쪽 Option 키를 누르고 ‘Open Arc’, ’Open Google Chrome’이라고 말하면 거의 즉시 앱이 바뀝니다.
만드는 과정에서 배울 점도 있었습니다. 행동을 여러 단계로 겹쳐 묻는 구조에서는 ’quit Spotify’에 대한 확신도가 67%에 그쳤습니다. 선택지를 한 단계짜리 목록으로 평평하게 펴자 확신도와 속도가 함께 올라갔습니다. 앱이 키 입력과 다른 앱을 다루려면 macOS 시스템 설정에서 손쉬운 사용(Accessibility)과 입력 모니터링(Input Monitoring) 권한을 모두 허용해야 합니다.
3. X 피드에서 광고와 낚시 글 숨기기
Chrome 확장 프로그램이 피드의 글과 이미지를 Decisions API에 보내 광고나 관심 끌기용 글인지 판정하고, 해당하면 펼쳐 볼 수 있는 얇은 막대로 접어 둡니다. 만드는 데는 약 4분이 걸렸습니다. 다만 기업의 제품 발표나 평범한 글도 홍보성 표현 때문에 광고로 잘못 걸러지는 일이 있었습니다. 글 오른쪽 위의 ‘Ad’ 표시를 먼저 확인하라고 prompt(AI에 주는 지시문)를 고치면 이런 오판을 쉽게 줄일 수 있습니다.
4. 화면 녹화 속 개인 정보 자동 가리기
FFmpeg로 화면 녹화에서 0.5초마다 장면을 뽑고, 각 장면에 API 키, 이메일 주소, 전화번호, 집 주소 같은 개인 정보가 있는지 Decisions API로 판정한 뒤 해당 위치를 흐리게 처리합니다. 가짜 이메일과 비밀 키가 담긴 1분짜리 시험 녹화로 돌려 본 결과는 다음과 같습니다.
| 항목 | 결과 |
|---|---|
| 검사한 장면 | 144장 |
| 개인 정보가 있는 장면 | 84장 |
| 전체 처리 시간 | 15.8초, 실제 재생보다 약 4.6배 빠름 |
| API 비용 | $0.0732 |
이전에는 Gemini에 영상 파일 전체를 올려 장면을 검사했는데, 그 방식보다 빠르고 간단했습니다.
5. Wikipedia 경주로 본 속도와 비용
두 Wikipedia 문서 사이를 링크만 따라 이동하는 게임에서 매 쪽마다 목적지에 가까운 링크를 고르게 했습니다. Decisions API, Jev, 일반 대화형 모델인 GPT-5.5를 나란히 비교한 결과입니다.
| 경로 | Decisions API | Jev | GPT-5.5 |
|---|---|---|---|
| Banana → Moon landing | 3번 이동, 2.9초, $0.00327 | 3번 이동, 7.3초, $0.00272 | 2번 이동, 8.9초, $0.0944 |
| Taylor Swift → Photosynthesis | 3번 이동, 1.2초, $0.00242 | 3번 이동, 2.0초, $0.00179 | 3번 이동, 16.3초, $0.1277 |
| Pokémon → Roman Empire | 6번 이동, 3.1초, $0.00268 | 5번 이동, 2.1초, $0.00136 | 2번 이동, 14.2초, $0.0678 |
일반 대화형 모델은 더 적은 이동으로 도착하기도 했지만, 판단 전용 모델은 한 번 판단할 때 대체로 10배쯤 빠르고 비용은 20~50분의 1 수준이었습니다.
6. 사진 한 장으로 칼로리 계산
휴대전화로 음식을 찍으면 칼로리를 알려 주는 모바일 웹앱입니다. 미국 농무부(USDA)가 무료로 공개하는 FoodData Central 목록을 받아 172개 분류, 5,412개 식품의 데이터베이스로 정리했습니다. 여기서 핵심은 AI에게 칼로리를 직접 추론하게 하지 않는 것입니다. Decisions API는 음식 분류와 1회 분량이라는 두 객관식 질문에 답하고, 이어서 분류 안의 구체적인 식품을 고릅니다. 최종 칼로리는 데이터베이스의 무게 표를 쓰는 일반 코드가 계산합니다.
치즈버거 사진은 488kcal로 판정했고 1초, $0.000054가 들었습니다. 반면 무게가 8lb에 이르는 대형 부리토 사진은 ’아주 큰 부리토’로 분류돼 964kcal가 나왔습니다. 작음·보통·큼·아주 큼처럼 정해 둔 분량 구간으로는 이런 극단적인 경우를 제대로 셀 수 없습니다.
7. 영상 원본에서 실수한 장면 걸러내기
원본 녹화에서 말이 꼬인 장면, 다시 시작한 부분, 말 없는 구간을 찾아 잘라 내는 도구입니다. Opus 5.5로 Adobe Premiere Pro 편집을 자동화하면 정확도는 약 98%지만 영상 한 편에 수백 달러의 API 비용이 들었습니다. 그래서 1차 거르기를 Decisions API에 맡겼습니다. Whisper-1로 음성을 시간 정보와 함께 받아 적고, 문장마다 실수·잘못된 시작·다시 시작·편집 신호·살릴 문장 가운데 무엇인지 고르게 합니다.
| 시험 | 결과 |
|---|---|
| 4분 45초 4K 녹화 | 40번 판단, 1.3초, 실수 장면 7곳 모두 찾음, API 비용 $0.0029와 받아쓰기 $0.029 |
| 4.25GB 원본 파일 | 음성 추출 0.2초, 받아쓰기 5.7초, 판단 1.7초, 말 없는 구간 54곳과 실수 장면 7곳 표시 |
받아쓰기는 로컬에서 돌리는 MLX Whisper보다 Whisper-1이 더 빠르고, 말이 끊긴 낱말의 시간 정보도 더 정확했습니다. 확신도가 낮은 문장만 Opus 같은 큰 reasoning model(단계적으로 추론하는 모델)로 보내면 비용을 아끼는 단계별 편집 흐름이 됩니다. Claude가 만든 편집 화면은 복잡하고 어수선했지만 기능은 제대로 작동했습니다.
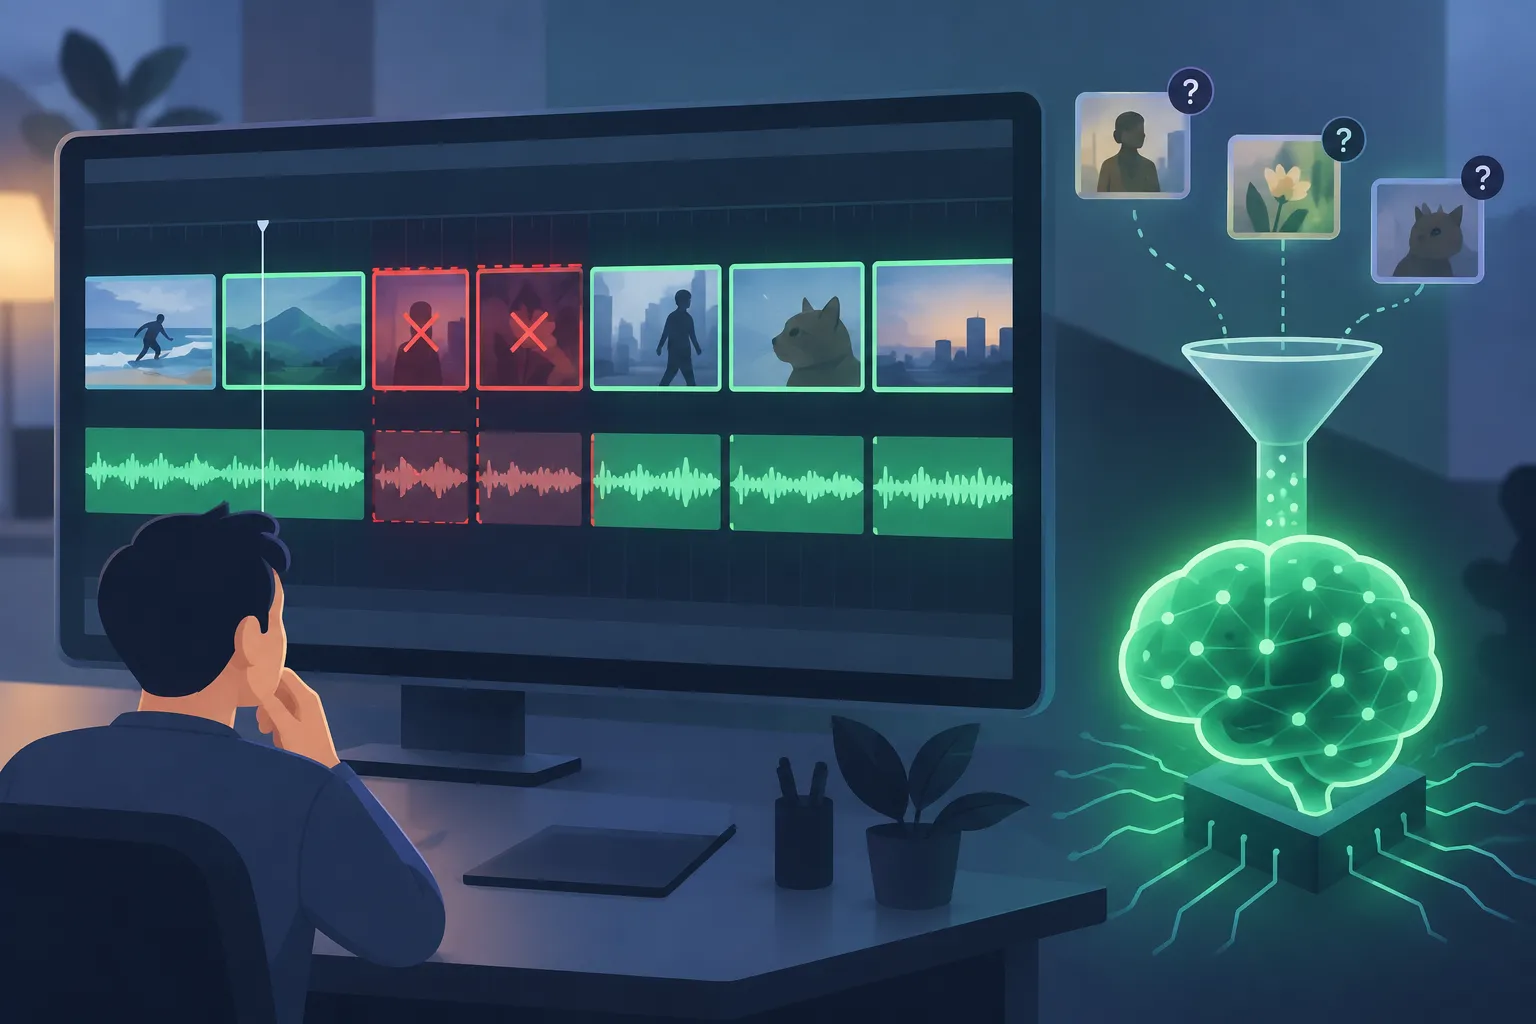
▲ 가벼운 판단 뒤 큰 모델로 넘기는 흐름
맡기기 전에 알아 둘 한계
- 목록에 없는 일은 하지 못합니다. 음성 제어에서 브라우저에 글자를 입력하거나 정해 두지 않은 주소로 이동하라는 명령은 실패했습니다. 판단 모델은 명시된 선택지 안에서만 고릅니다.
- 미묘한 맥락을 따져야 하는 복잡한 예외에서는 놓치는 것이 생깁니다. 이런 판단은 여전히 reasoning model이 필요합니다.
- 선택지를 여러 단계로 겹치면 확신도가 떨어집니다. 하나의 평평한 목록으로 펴는 편이 낫습니다.
- 분류가 지나치게 민감할 수 있습니다. 피드 정리처럼 오판이 생기면 prompt에 판단 근거가 될 단서를 구체적으로 적습니다.
- 정해 둔 구간에 맞지 않는 극단값은 틀리기 쉽습니다. 칼로리 계산의 대형 부리토가 그런 경우입니다.
정리: 작은 분류 문제 하나부터 바꿔 보기
Decisions API는 범위가 정해진 선택을 빠르고 싸게 반복하는 일에 맞습니다. 화면이나 사진을 보고 즉시 판단해야 하는 실시간 도구, 대량의 글이나 장면을 분류하는 작업, 비싼 모델 앞에서 쉬운 판단을 미리 걸러 내는 단계에서 특히 쓸모가 있어 보입니다. 직접 써 보려면 다음 순서를 권합니다.
- 업무에서 답이 몇 가지로 정해진 분류 문제 하나를 고르고, Decisions Playground에서 선택지 목록으로 바꿔 시험합니다.
- 선택지는 여러 단계로 겹치지 말고 한 단계 목록으로 펴 둡니다.
- 칼로리나 금액 같은 숫자는 모델이 직접 만들게 하지 말고, 모델이 고른 분류를 바탕으로 조회표와 코드가 계산하게 합니다.
- 확신도 기준을 정해 두고, 기준보다 낮은 항목만 큰 reasoning model로 넘깁니다.
- 시각 입력이 필요하면 Decisions API를, 텍스트만 대량으로 분류하고 비용이 중요하면 Jev와 함께 비교해 고릅니다.