Claude Code와 Codex는 AI 모델이 아닙니다. 모델을 감싸서 파일을 읽고, 명령을 실행하고, 결과를 확인하게 해 주는 harness(모델에 도구, 기억, 안전장치를 붙여 실제 일을 하게 만드는 실행 틀)입니다. 같은 모델이라도 어떤 harness에 넣느냐에 따라 같은 과제의 결과가 크게 달라집니다. 최근 6개월가량 코딩과 agent 성능이 크게 오른 것도 모델 자체보다 harness가 좋아진 덕이 큰 것으로 보입니다. AI 도구를 고르거나 직접 다루는 사람이라면 모델 이름만큼 harness의 구조를 알아 둘 필요가 있습니다.
모델 혼자서는 할 수 없는 네 가지
대형 언어 모델은 혼자서는 글을 받아 다음에 올 token(모델이 글을 처리하는 단위)을 예측하는 장치일 뿐입니다. ‘The sky is’ 다음에 ’blue’가 올 확률이 압도적으로 높다는 것을 학습했을 뿐, 그 밖의 일은 하지 못합니다. 모델만 놓고 보면 한계는 네 가지로 정리됩니다.
| 한계 | 모델 혼자일 때 |
|---|---|
| 기억 | 새 대화를 열 때마다 이전 내용을 전혀 모르는 상태에서 시작 |
| 보기 | 사용자의 화면, 파일, 폴더를 누가 넣어 주지 않으면 볼 수 없음 |
| 행동 | 코드를 실행하지 못하고 사람에게 할 일을 글로 제안할 뿐 |
| 확인 | 제안한 코드가 실제로 돌아가는지 스스로 시험할 방법이 없음 |
그래서 모델을 흔히 ’병 속의 뇌’에 비유합니다. 힘은 세지만 고삐 없는 야생마처럼, 뛰어난 답과 엉뚱한 답 사이를 오갑니다. harness는 이 말에 얹는 안장과 고삐에 해당합니다. 잘 만든 harness는 평범하거나 한 단계 낮은 모델로도 기대 이상의 결과를 낼 수 있고, 반대로 최상위 모델도 harness가 엉성하면 제힘을 쓰지 못할 수 있습니다. 가장 단순한 harness는 우리가 매일 쓰는 채팅 창이지만, 실제 업무는 그보다 훨씬 정교한 구조를 요구합니다.
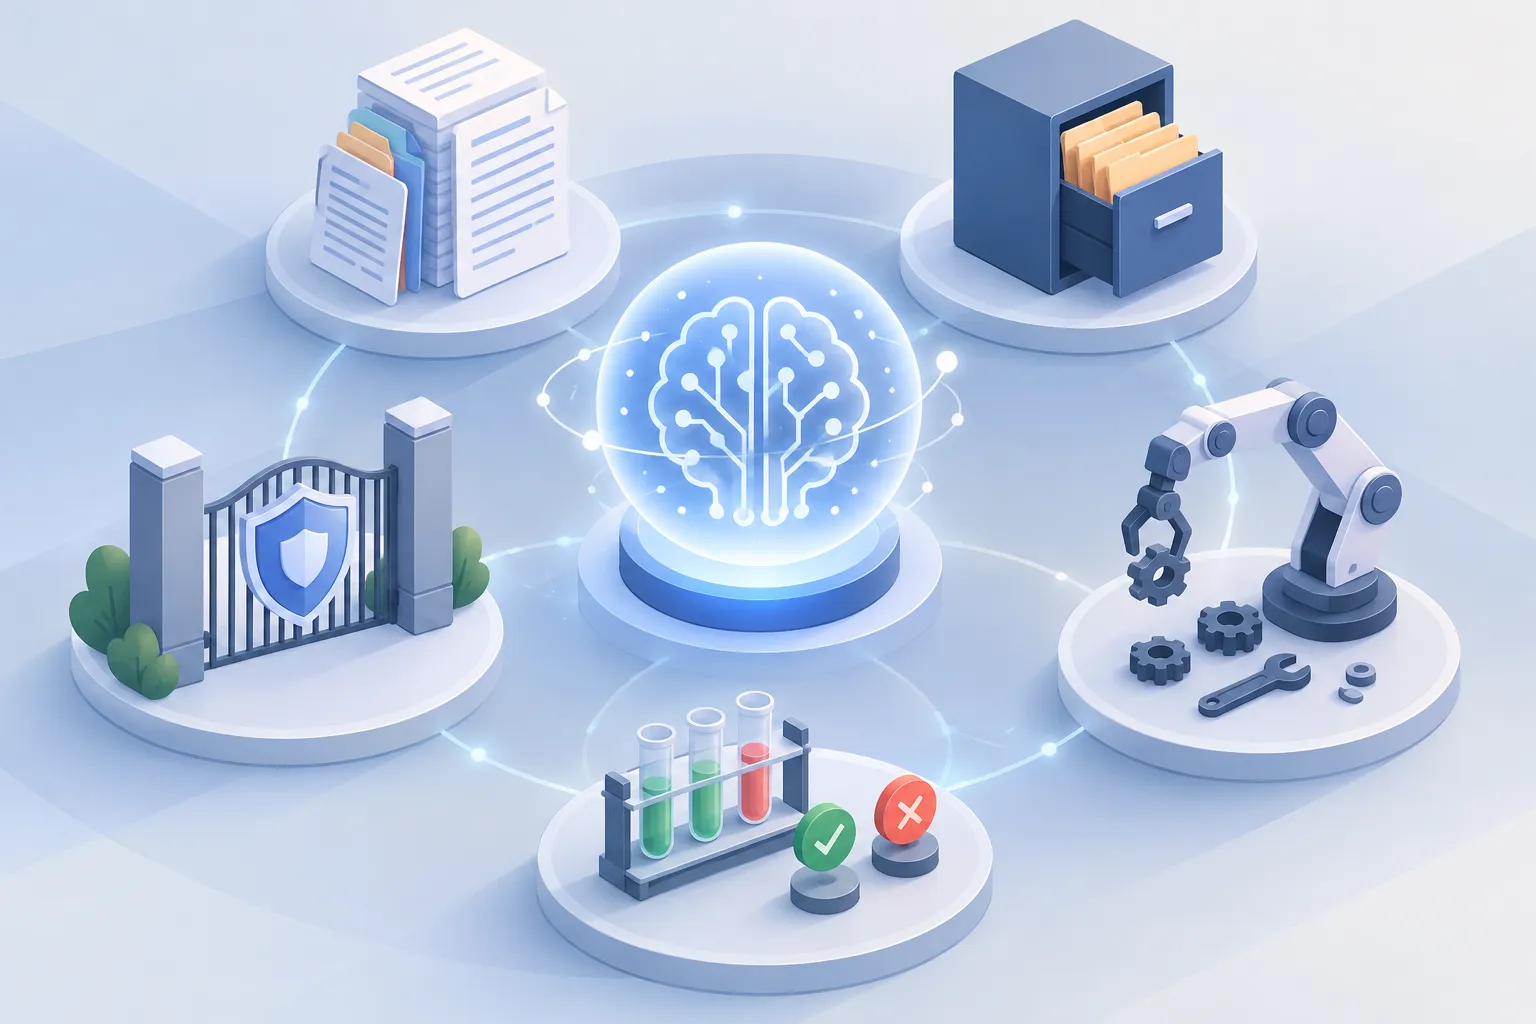
▲ harness의 다섯 구성 요소
harness를 이루는 다섯 기둥
현대의 harness는 다섯 요소로 나눠 볼 수 있습니다.
- 맥락: 모델에게 지금 무엇을 왜 하는지 알려 줍니다.
- 기억: 지난 작업과 세션의 흐름을 이어 줍니다.
- 도구: 모델이 실제로 파일을 고치고 프로그램을 돌리게 합니다.
- 검증: 작업이 성공했는지 자동으로 판정합니다.
- 권한: 위험한 행동을 막고 멈출 조건을 정합니다.
맥락: 세션을 열 때 미리 넣어 주는 정보
새 세션의 모델은 사용자도, 회사도, 프로젝트도 모릅니다. ’안녕’이라고만 입력하면 이름을 부르며 사업 이야기를 꺼낼 수 없습니다. harness는 세션을 시작할 때 프로젝트가 무엇인지, 파일이 어떻게 놓여 있는지, 최근에 무엇이 바뀌었는지, 어떤 도구를 쓸 수 있는지를 보이지 않는 첫 prompt(모델에게 주는 지시문)에 자동으로 넣습니다.
Claude Code와 Codex에서는 이 역할을 주로 CLAUDE.md나 AGENTS.md 같은 프로젝트 규칙 파일이 맡습니다. ‘우리 코드 스타일을 따를 것’, ‘이 폴더는 고치지 말 것’, ‘항상 테스트를 돌릴 것’ 같은 규칙을 적어 두면 harness가 세션마다 자동으로 읽습니다. 매번 같은 당부를 반복하던 번거로움이 이 파일 하나로 사라집니다. auth.ts, cart.ts, api.ts처럼 파일 목록을 정리한 코드 지도를 함께 주면 모델이 저장소 전체를 뒤지지 않고 필요한 파일을 바로 찾아갑니다.
기억: 꽉 찬 context window를 정리하는 compaction
작업이 길어지면 context window(모델이 한 번에 볼 수 있는 글의 범위)가 대화 기록, 지시, 도구 출력으로 차오릅니다. 이 한도는 harness가 아니라 모델 구조가 정하는 값입니다. 책 20~50권 분량, 수백만 token이 쌓이면 서로 어긋나는 지시가 섞여 모델의 판단력이 눈에 띄게 떨어집니다.
harness는 compaction(긴 대화 기록을 요약해 압축하는 기법)으로 이 문제를 풉니다. 처음 목표, 전체 계획, 바꾼 파일 목록은 그대로 남기고, 중간 단계는 짧은 요약으로 줄이며, 실패한 시도와 긴 오류 기록은 지웁니다. Claude Code는 token 한도에 가까워지면 이 정리를 자동으로 합니다. 또 파일을 고칠 때마다 전체 내용을 다시 기억하지 않고 Git처럼 바뀐 부분만 적은 변경 기록을 남겨, 적은 공간으로도 이전 상태를 되짚을 수 있게 합니다.
도구: 글을 행동으로 바꾸는 층
모델이 내놓는 것은 글뿐이므로, harness는 정해진 형식의 글을 ’행동 요청’으로 알아보는 장치를 둡니다. 모델이 요청을 내면 harness가 이를 가로채 파일 읽기, 파일 검색, 프로그램 실행, 코드 수정 같은 도구 정의와 맞춰 보고 실행한 뒤 결과를 모델에게 돌려줍니다. 요청은 정해진 스키마(입력 형식)를 따르므로 항상 바로 실행할 수 있는 값이 됩니다.
효율도 좋아졌습니다. 파일 전체를 새로 쓰는 대신 필요한 줄만 고치게 하면서 token 사용과 문법 오류가 크게 줄었습니다. 외부 서비스와 연결하는 표준으로는 Anthropic이 만들고 OpenAI도 채택한 MCP(Model Context Protocol)가 자리 잡았습니다. MCP 서버를 만들면 Slack, GitHub, 캘린더, 데이터베이스, 디자인 도구를 모델에 연결할 수 있고, 자주 쓰는 AI agent에게 사내 도구용 MCP 서버를 직접 만들게 하는 방법도 있습니다.
검증: 모델의 자기 평가를 믿지 않는다
모델에게 ’이거 맞아 보여?’라고 물으면 거의 늘 ’좋아 보인다’고 답합니다. 모델에는 계산 장치나 기본적인 점검 기능이 없어서, 17 곱하기 3을 48이라고 답하고도 맞다고 고집할 수 있습니다. 외부 계산기 도구를 붙여야 51이라는 답을 확인합니다.
그래서 harness는 모델의 결과를 실제 환경에서 돌려 보고 그 결과를 다시 모델에게 넣습니다. 검증에 쓰는 도구는 세 가지입니다.
종료 코드가 0이면 성공, 0이 아니면 오류입니다. 이 결과를 받은 모델은 실제 실행 결과를 보고 스스로 고쳐 나갑니다.
권한: 위험한 행동을 막는 안전층
harness는 도구 호출 하나하나와 그 순서를 실행 전에 살핍니다. 파일 수정처럼 무해한 행동은 자동으로 허용하고, 파일 삭제, 저장한 작업 삭제, 시스템 설정 변경, 모르는 사이트로 데이터 전송은 막거나 사용자 승인을 받게 합니다. ’오래된 폴더를 지울까요?’라는 확인 창이 그런 장치입니다.
여기에 hook(정해진 시점에 자동으로 실행되는 규칙)을 더합니다. ‘파일을 고칠 때마다 테스트 실행’, ‘이 명령은 절대 허용하지 않음’ 같은 규칙입니다. 예를 들어 온라인 쇼핑몰 개발자라면 코드를 고칠 때마다 성능 테스트를 돌리게 해 사이트 로딩 속도를 지킬 수 있습니다. 외부로 나가는 요청을 지난 2주 동안 연결한 도메인 목록과 대조해, 처음 보는 피싱 의심 주소로 데이터를 보내려는 시도를 막는 방식도 있습니다.
마지막 울타리는 sandbox(외부와 분리된 실행 환경)입니다. 가상 컨테이너 안에서 실행하면 대량 삭제나 설정 변경 같은 사고가 그 안에 갇힙니다. 실행 시간, 메모리 사용량, 인터넷 연결에도 한도를 둡니다. Codex는 작업마다 깨끗한 클라우드 환경을 새로 만들어 경계를 확실히 나눕니다. sandbox는 단순한 실수뿐 아니라, 모델이 효율을 좇아 외부 데이터를 내려받거나 내부 가중치를 빼내는 식의 지름길을 택하는 alignment(AI가 사람의 의도대로 행동하게 하는 일) 문제까지 막는 장치로 꼽힙니다. 주 모델의 행동을 두 번째 AI 모델이 검사하는 방식도 떠오르고 있지만, 세심한 조정이 필요하다는 단서가 붙습니다.
agent가 일하는 순서, ReAct 루프
다섯 기둥은 하나의 반복 구조 안에서 함께 움직입니다. 자율 agent의 표준 구조인 ReAct(추론과 행동을 묶은 방식) 루프는 다음 순서로 돕니다.
- 생각: 맥락을 보고 다음에 할 일을 정합니다.
- 행동: 도구 호출이나 코드 실행을 요청합니다.
- 권한 확인: 그 요청이 안전한지, 사람의 승인이 필요한지 따집니다.
- 실행: 승인된 행동을 sandbox 안에서 실행합니다.
- 정리: 긴 로그와 쓸모없는 출력을 잘라 context window를 아낍니다.
- 읽기: 정리된 결과를 읽고 무슨 일이 왜 일어났는지 파악한 뒤 다시 생각으로 돌아갑니다.
목표를 이루면 루프를 끝내고 무엇을 바꿨는지 사용자에게 알립니다. 생각 단계에서도 harness가 개입합니다. 모델에게 먼저 예비 추론을 쓰게 하고 그 끝에 ‘but’, ‘however’ 같은 접속어를 붙이면, 모델이 처음 판단의 허점과 예외를 스스로 찾기 시작합니다. 모델이 내놓은 token은 harness가 내부 생각, 도구 요청, 사용자에게 보낼 메시지로 나눠 처리합니다.
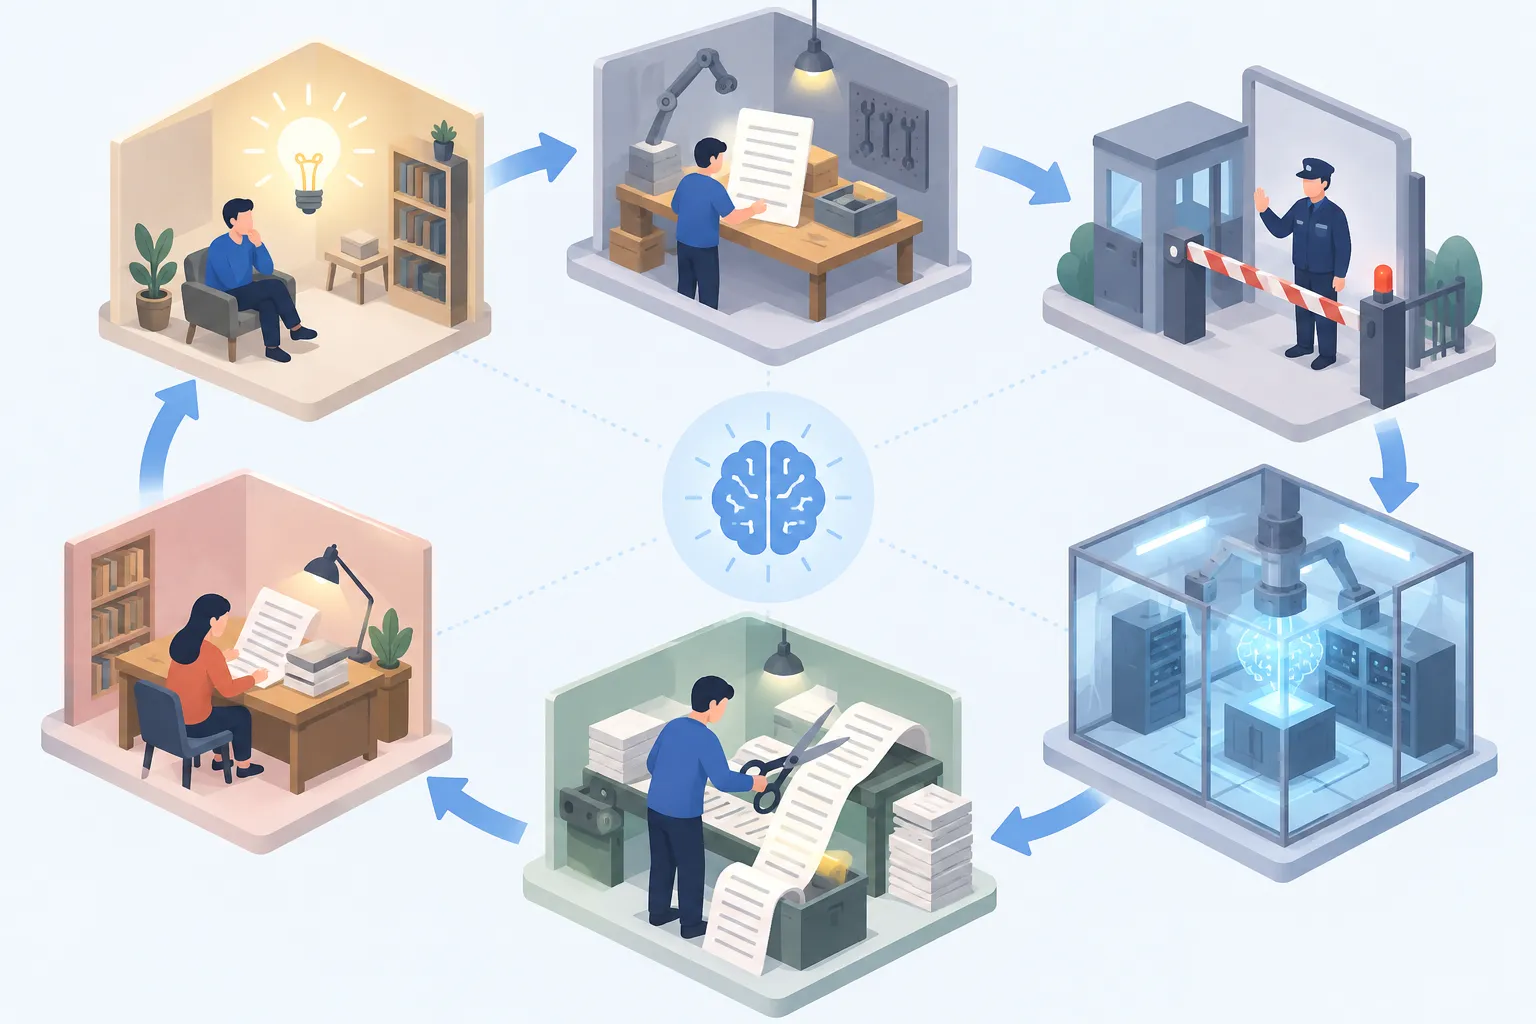
▲ agent의 ReAct 루프
harness가 바꾸는 것과 바꾸지 못하는 것
harness는 모델을 더 똑똑하게 만들지 못합니다. 대신 훨씬 쓸모 있게 만듭니다. benchmark 점수가 갑자기 뛰었다면 모델 지능보다 harness 개선 덕일 때가 많다는 점도 기억할 만합니다. 그리고 수천 개의 GPU가 필요한 모델 학습과 달리, harness 개발은 소프트웨어 개발이어서 개인 개발자도 충분히 뛰어들 수 있는 영역입니다.
앞으로의 방향은 네 갈래로 보입니다.
- MCP의 확산: 캘린더, 이메일, 파일 시스템까지 더 많은 앱이 MCP로 연결됩니다.
- agent 팀: 계획, 구현, 검토, 테스트를 맡은 agent가 역할을 나누고, agent끼리 대화하며 맥락을 공유합니다.
- 병렬 시도: 한 과제를 세 sandbox에서 동시에 시도해 두 번 실패하고 한 번 통과하면, 검증을 통과한 결과만 고릅니다.
- 스스로 나아지는 harness: 지난 실수와 도구 호출 실패를 분석해 규칙을 고칩니다. 저장소 전체를 읽느라 token을 낭비하는 습관을 찾아 ’먼저 검색하라’는 규칙을 넣으면 token 사용을 10분의 1로 줄일 수 있습니다.
오늘 바로 점검할 것
AI 도구의 성능을 따질 때는 모델 이름만 보지 말고, 그 모델이 어떤 harness 안에서 돌아가는지를 함께 보는 것이 좋겠습니다. Claude Code나 Codex를 쓰고 있다면 다음부터 손볼 수 있습니다.
- 프로젝트 맨 위에 CLAUDE.md나 AGENTS.md를 두고 코드 스타일, 테스트 명령, 고치면 안 되는 폴더를 적습니다.
- 모델에게 결과가 맞는지 묻지 말고 테스트, linter, formatter로 확인하게 합니다.
- 파일을 고칠 때마다 테스트를 돌리는 hook을 걸고, 삭제나 설정 변경은 사람이 승인하게 합니다.
- 믿을 수 없는 작업은 sandbox에서 실행 시간과 메모리 한도를 두고 돌립니다.
- 사내 도구를 연결해야 한다면 AI agent에게 MCP 서버를 만들게 해 봅니다.
모델은 바꾸지 않아도, 이 다섯 기둥을 손보는 것만으로 같은 모델에게서 훨씬 많은 일을 얻어 낼 수 있습니다.