같은 AI 모델을 쓰더라도 일을 나누고 합치는 방식만 바꾸면 결과가 크게 달라질 수 있습니다. 데스크톱 코딩 도구 EvoX Agent를 만든 EvoMap이 프로그래밍·논리 문제 563개로 시험한 benchmark(성능을 비교하는 기준 시험)에서, agent(목표를 받아 스스로 도구를 쓰며 작업하는 AI) 하나가 모든 문제를 혼자 처리했을 때 정답률은 26%였습니다. 같은 모델로 여러 agent가 문제를 나눠 맡는 agent swarm(여러 agent가 각자 독립된 작업을 동시에 처리하고 결과를 합치는 방식)은 71%를 기록했습니다. 모델의 가중치나 설정은 그대로였고, 달라진 것은 작업 배분과 context(모델이 한 번에 참고하는 대화와 자료) 관리뿐이었습니다.
agent 하나에 몰아줄 때 생기는 문제
agent 하나에 여러 작업을 차례로 맡기면 앞선 작업의 대화 기록이 계속 쌓입니다. 네 번째 작업을 할 때도 첫째부터 셋째 작업의 기록을 함께 끌고 가야 하므로, 쓸데없는 정보가 판단을 흐리거나 중요한 세부 사항을 놓치는 일이 생깁니다. 작업이 많아질수록 정확도가 떨어지는 까닭이 여기에 있다는 설명입니다.
흔히 쓰는 대안은 관리자 agent가 sub-agent(하위 작업을 맡는 보조 agent)에게 일을 나눠 주고 결과를 요약해 합치는 구조입니다. 그런데 같은 benchmark에서 sub-agent들은 정답 373개를 찾아냈지만, 관리자 역할의 언어 모델이 결과를 요약해 합치는 과정에서 217개만 남았습니다. 정답률로는 39%입니다. 요약은 정보를 줄이는 일이라, 맞게 풀어 놓은 답도 합치는 단계에서 빠질 수 있다는 뜻으로 보입니다.
| 구성 | benchmark 정답률 | 특징 |
|---|---|---|
| agent 하나 | 26% | 앞선 작업의 기록이 계속 쌓임 |
| sub-agent와 요약 병합 | 39% | 찾은 정답 373개 가운데 217개만 남음 |
| agent swarm | 71% | 작업마다 깨끗한 context, 코드로 결과 병합 |
swarm이 정확도를 지키는 두 가지 장치
EvoX Agent의 swarm은 두 가지로 이 문제를 피합니다. 첫째, 하위 작업마다 깨끗한 context를 따로 줍니다. 각 agent는 자기 작업에 필요한 정보만 보고 일합니다. 둘째, agent들이 낸 결과를 언어 모델의 요약이 아니라 정해진 규칙대로 동작하는 코드로 합칩니다. 같은 입력에 늘 같은 결과를 내는 방식이라 합치는 과정에서 답이 사라지지 않습니다.
여러 agent가 결과를 합치는 구조를 직접 설계한다면, 요약에 맡기는 병합보다 코드로 처리하는 병합을 먼저 검토할 만해 보입니다. 다만 위 정답률은 EvoMap 측 benchmark 결과이므로, 자신의 작업에서 같은 차이가 나는지는 따로 확인하는 편이 좋습니다.
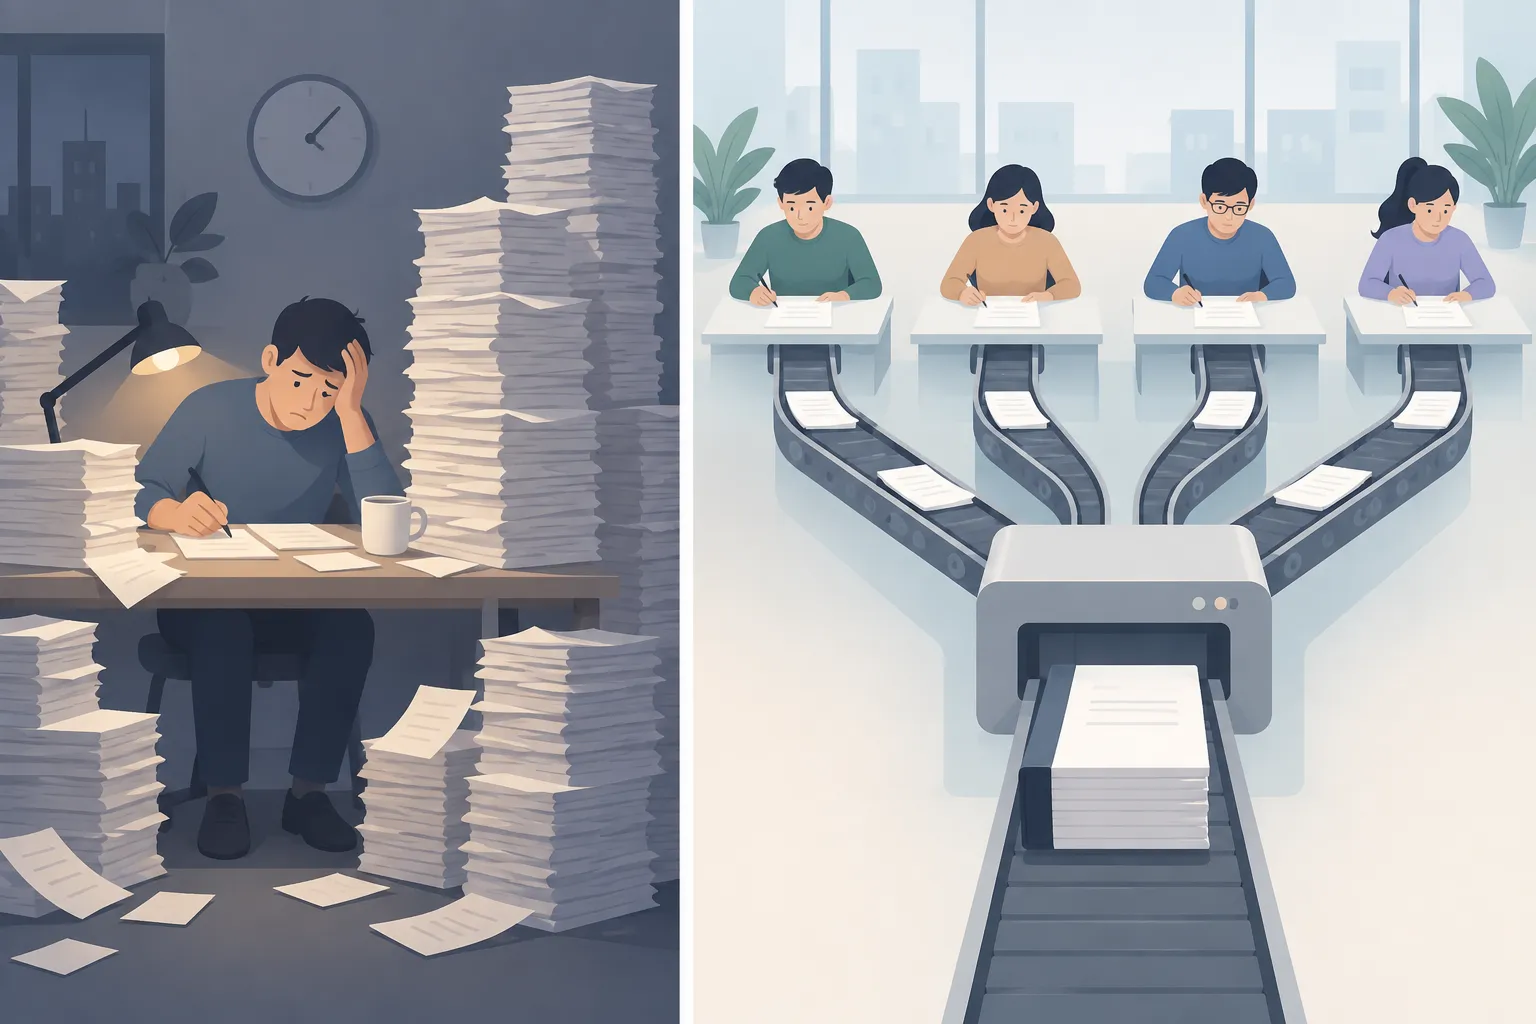
▲ 쌓이는 기록과 나뉜 작업
단어 카드 앱으로 비교한 swarm과 순차 실행
실제 개발 작업에서는 어떤 차이가 날까요. 인도네시아어 단어를 외우는 단어 카드 웹 앱에 네 가지 작업을 한꺼번에 맡겼습니다.
- node:test로 단위 테스트 작성
- lint(코드 규칙 점검)와 tsc를 쓴 타입 검사
- docs/API.md에 문서 작성
- 웹 접근성 지침 WCAG 2.2 AA 기준의 접근성 점검
swarm 모드를 켜고 요청하자 EvoX Agent는 먼저 작업 계획을 세웠습니다. 계획에는 agent마다 어느 파일을 맡을지 정한 규칙이 들어 있었습니다. 여러 agent가 동시에 같은 파일을 고치다 충돌하는 일을 막기 위해서입니다. 계획을 승인하자 네 agent가 동시에 일했고, 파일 7개를 고쳐 약 7~8분 만에 끝냈습니다.
같은 프로젝트를 복제해 swarm을 끄고 같은 작업을 순서대로 실행하자 결과가 달라졌습니다.
| 항목 | swarm 실행 | 순차 실행 |
|---|---|---|
| 걸린 시간 | 약 7~8분 | swarm의 약 2.5배 |
| 사용한 context token | 약 8만 4,000개 | 약 12만 9,000개 |
token은 AI 모델이 글을 처리하는 단위로, 쓰는 양이 많을수록 비용과 응답 시간이 늘어납니다. 순차 실행은 앞 작업의 기록을 다음 작업으로 계속 넘기기 때문에 prompt(모델에 넣는 지시문)가 커지고 처리도 느려집니다.
agent 100개로 생존 게임 전략을 진화시키다
규모를 키운 실험도 있었습니다. 2D 격자 위에서 생물 종 100개가 먹이를 먹고, 움직이고, 번식하고, 공격하며 살아남는 생존 게임을 만들고, prompt 하나를 100개의 작업으로 나눠 agent 하나가 종 하나의 행동 코드를 JavaScript로 쓰게 했습니다. 각 agent는 다른 agent의 코드나 전략을 보지 못한 채 자기 context 안에서만 작업했습니다. 100개 종의 코드를 만들고 검증하는 데는 약 20분이 걸렸고, 순서대로 했다면 몇 시간이 걸렸을 것으로 추정됩니다.
결과는 다음과 같습니다.
| 세대 | 2,000턴 뒤 살아남은 종 | 공격 횟수 |
|---|---|---|
| 1세대 | 64개 | 1만 2,886회 |
| 2세대 | 99개 | 0회 |
2세대는 1세대에서 성적이 좋았던 종의 행동 원칙을 정리해 AI에게 주고, 공격하지 않고 먹이를 찾는 전략을 새로 짜게 해서 만들었습니다. 잘된 결과의 원칙을 다음 세대의 지시에 담아 다시 생성하는 방식으로, 여러 agent를 동시에 돌리는 방식과 결합하면 복잡한 최적화 문제를 빠르게 되풀이해 개선할 수 있음을 보여 주는 사례로 보입니다.
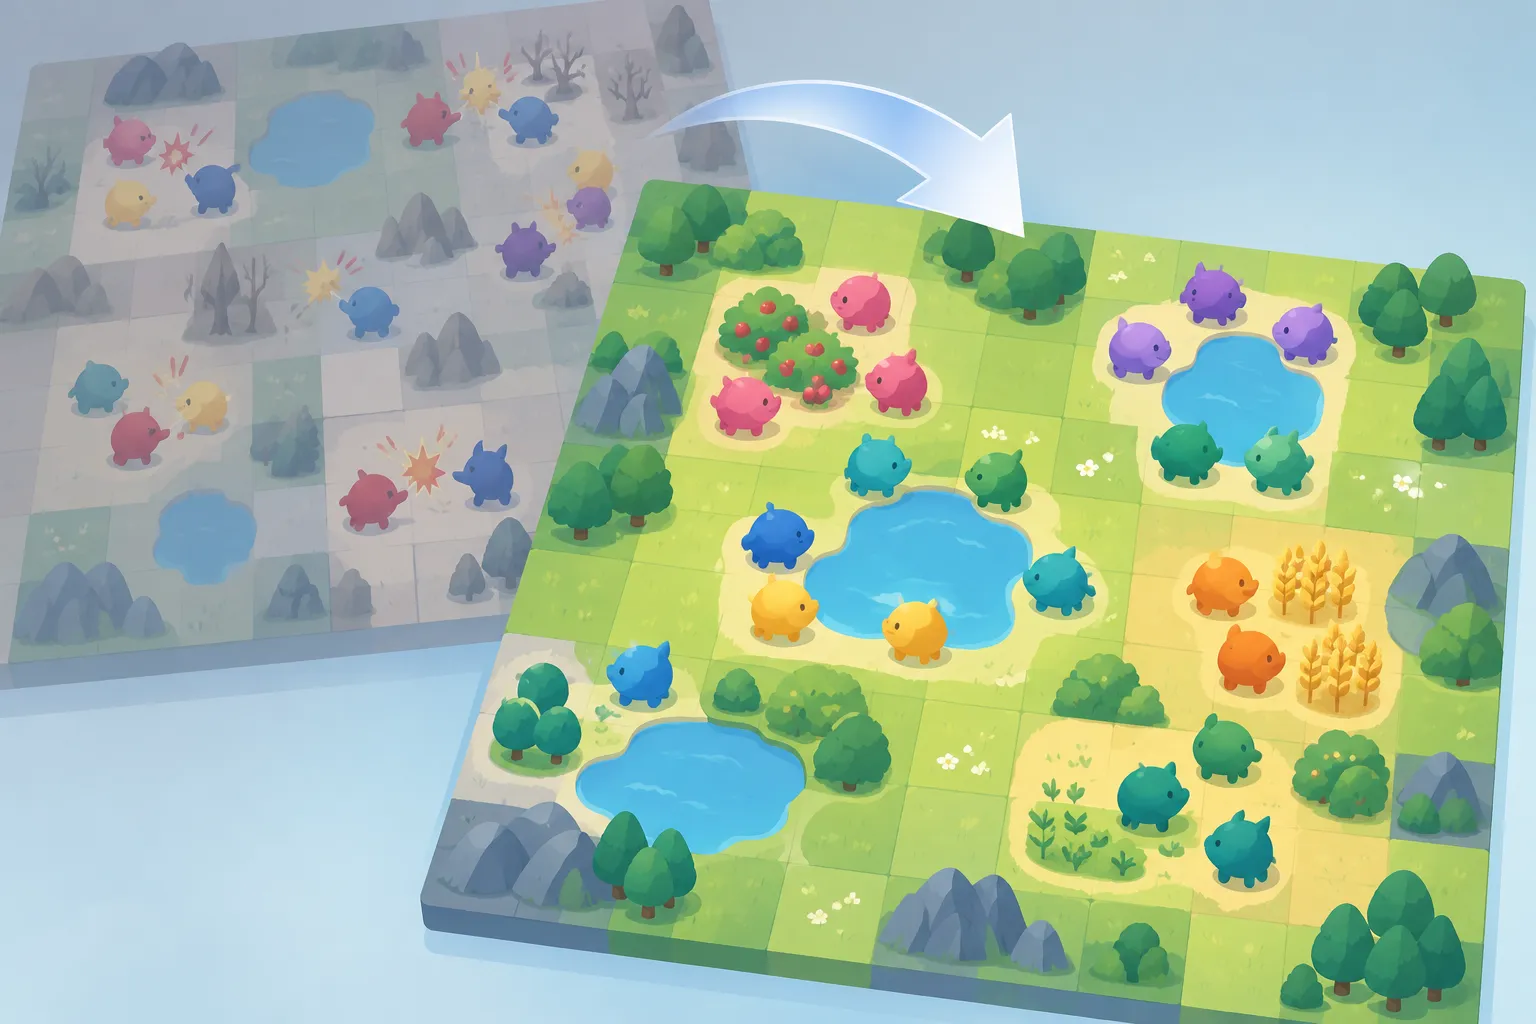
▲ agent 100개가 만든 생존 게임
일을 하면서 배우는 self-evolution 기능
EvoX Agent에는 성공한 작업을 재사용할 수 있는 능력으로 정리하는 self-evolution 기능도 있습니다. 과정은 관찰(Observe), 발견(Discover), 재사용·개선(Reuse/Improve), 검증(Validate), 확정(Solidify)의 다섯 단계입니다.
- gene: 특정 SQL 쿼리 패턴 실행이나 프로젝트 스키마 읽기처럼 작은 단위의 절차
- capsule: 작업 하나를 처음부터 끝까지 푼 해법. 성능 지표, 신뢰도, 비용, token 사용량, 다시 실행할 수 있는 실행 경로를 담음
- Events: agent가 만든 변경과 수정, 추가한 능력을 고칠 수 없는 기록으로 남기는 로그
EvoMap은 저장소나 대화 기록에서 반복되는 패턴을 익힌 뒤에는 이미 확인한 해법을 다시 쓰므로 token 사용량을 약 31% 줄일 수 있다고 주장합니다. 이 수치는 그 자리에서 모두 검증하기 어려웠지만, 학습 과정 자체는 매끄럽게 작동했다는 평가입니다. gene, capsule, mutation 같은 용어가 낯설어 처음에는 구조를 이해하기 어려울 수 있습니다.
써 보기 전에 알아 둘 설정
EvoX Agent는 macOS와 Windows용 데스크톱 앱으로, Codex나 Claude Code처럼 코드베이스를 읽고 코드를 쓰고 명령을 실행하며 테스트를 고치는 기본 기능을 갖췄습니다. 새로 가입하면 약 $15 상당의 무료 체험 크레딧 1,500개를 받습니다. 처음 설정할 때 Claude Code와 Codex의 세션, 메모리, 설정을 가져올 수 있습니다.
| 모드 | 하는 일 | 사례 |
|---|---|---|
| Chat | 대화로 질문하고 판단을 구함 | 단어 카드 복습 방식을 Leitner 상자에서 SM-2 알고리즘으로 바꿀지 검토 |
| Cowork | 문서, 계획, 보고서 작성 | 카드 데이터를 분석해 그래프와 표가 든 한 쪽짜리 PDF 진도 보고서 작성 |
| Code | 코드 수정, 테스트, 배포 | 통계 API와 화면 요소를 추가하고 npm test로 확인한 뒤 Vercel CLI로 배포 |
설정에서 눈여겨볼 부분은 다음과 같습니다.
- 모델 자동 전환: 작업 난이도에 따라 쉬운 일은 DeepSeek V4 Flash 같은 저렴한 모델에, 일반 작업은 GPT-5.6 Terra나 Kimi K3 같은 모델에 나눠 맡길 수 있습니다.
- 모델 연결: OpenAI, Anthropic, Gemini API와 Ollama, LM Studio 같은 로컬 모델 서버를 연결할 수 있습니다. NVIDIA DGX Spark에서 돌리는 로컬 모델을 연결하면 클라우드 사용료 없이 쓸 수 있습니다.
- 실행 승인: 단계마다 승인하는 Confirm steps, 위험한 작업만 묻는 Smart, 모두 자동으로 하는 Full auto 가운데 고릅니다. Full auto는 믿을 수 있는 프로젝트나 파일을 지우거나 덮어쓰지 않는 작업에만 쓰는 편이 안전합니다.
- 외부 연결: Slack, Discord, Telegram, WhatsApp, Microsoft Teams 같은 메신저에서 agent에게 지시할 수 있고, QR 코드로 휴대전화를 연결해 밖에서도 작업을 확인할 수 있습니다.
여러 agent에게 일을 나눌 때 확인할 것
정리하면, 여러 작업을 agent 하나에 몰아주면 쌓이는 기록이 정확도와 속도를 함께 떨어뜨립니다. swarm은 작업마다 깨끗한 context를 주고 결과를 코드로 합쳐 이 문제를 줄입니다. EvoX Agent가 아니더라도 여러 agent에게 일을 나눌 때는 다음을 점검해 볼 만합니다.
- 여러 파일이나 여러 관심사에 걸친 요청이면 서로 독립된 작업으로 나눌 수 있는지 먼저 봅니다.
- agent마다 맡을 파일을 지시문에 분명히 정해 동시에 같은 파일을 고치는 충돌을 막습니다.
- 결과를 합칠 때는 언어 모델의 요약보다 코드로 처리하는 병합을 우선 검토합니다.
- 잘된 결과가 나오면 그 원칙을 정리해 다음 지시에 담아 다시 생성합니다.
- 자동 실행은 되돌릴 수 있는 작업에 한정하고, 중요한 작업은 단계별 승인을 유지합니다.
- 제공사가 밝힌 정확도와 token 절감 수치는 자신의 작업으로 작게 시험해 확인합니다.