OpenAI Dots와 Meta Muse는 모두 대화를 이어 가며 클라우드에서 작업하는 AI agent(사람의 지시에 따라 도구를 사용하고 작업을 수행하는 AI)입니다. 하지만 실제로 써 보면 강점이 다릅니다. Dots는 Slack의 팀 대화와 Codex 작업 환경에 자연스럽게 들어갔고, Muse는 WhatsApp 대화와 반복 점검 작업을 한곳에서 관리하기 쉬웠습니다. 같은 지시로 만든 결과물을 일대일로 채점한 비교는 아니므로, 각각 어떤 작업이 완료됐고 어디서 사람이 개입해야 했는지 나눠 보는 편이 정확합니다.
메시지에 답하는 일: 둘 다 성공, 쓰는 자리는 다릅니다
Dots를 Slack 채널에 연결한 뒤 작업을 요청하자, 처리 상태가 표시되고 답변이 해당 대화 스레드에 정리됐습니다. 팀원이 채널에서 agent를 불러 일을 맡길 수 있다는 점도 확인됐습니다. 이미 Slack에서 협업하는 팀이라면 요청과 답변을 기존 대화 안에 남길 수 있습니다.
Muse에는 WhatsApp으로 짧은 메시지를 보냈고, 몇 초 안에 답장이 왔습니다. 대화 내용은 Muse 데스크톱 앱에도 동기화됐습니다. 다만 데스크톱 앱에 표시된 WhatsApp 대화는 보기 전용입니다. 모바일 메시지에 답하는 동안 서로 다른 곳에서 입력이 엇갈리지 않도록 한 방식이지만, 그 자리에서 대화를 이어 쓰려면 WhatsApp을 사용해야 합니다.
| 작업 | 확인된 결과 | 사람이 확인할 지점 |
|---|---|---|
| Slack 채널에서 Dots 호출 | 요청 처리 상태와 스레드 답변 표시 | 답변이 팀의 요청에 맞는지 검토 |
| WhatsApp에서 Muse에 메시지 전송 | 빠른 답장과 데스크톱 대화 동기화 | 후속 대화는 WhatsApp에서 진행 |
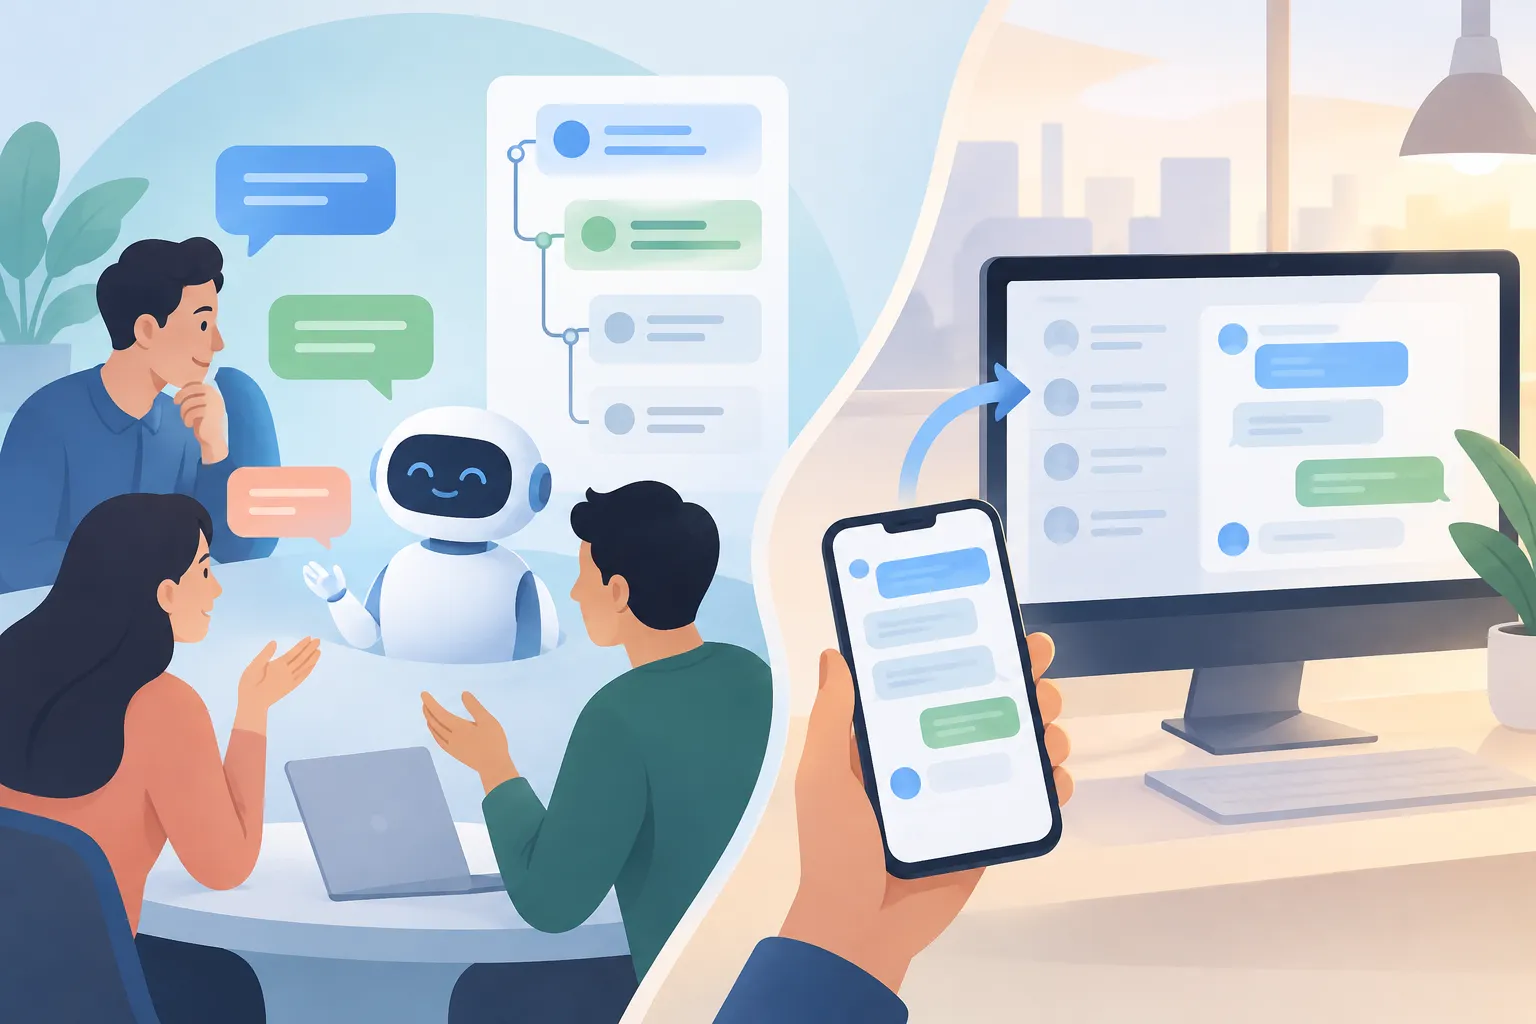
▲ 메시지 처리 방식
이 비교는 어느 쪽이 메시지 작성 자체를 더 잘하는지 보여 주지는 않습니다. Dots에서는 팀 채널 안에 결과가 남았고, Muse에서는 개인 메시지가 앱과 연결됐다는 작업 흐름의 차이가 확인됐습니다.
이전 맥락과 결과물: 편리함보다 수정 경로가 중요합니다
Dots는 기존 ChatGPT의 기억을 이어받습니다. 처음에는 오래된 맥락을 떠올렸지만, Codex의 기억과 로컬 파일을 직접 가리키자 작업에 필요한 자료를 찾도록 방향을 잡을 수 있었습니다. 이미 개발 작업을 축적한 사용자에게는 연결이 이점인 반면, 어떤 과거 정보를 참조하는지 사람이 점검해야 합니다.
Muse는 지속해서 기억할 정보와 agent의 행동 지침을 각각 MEMORY.md와 SOUL.md 파일에 보여 주고 직접 편집할 수 있게 합니다. 잘못된 배경 정보나 원하는 응답 방식을 사용자가 확인하고 고칠 경로가 명확합니다. 이는 두 서비스의 답변 정확도를 같은 과제로 검증한 결과라기보다, 기억을 다루는 방식의 차이입니다.
두 서비스 모두 문서, PDF, 코드 등의 결과물을 만들 수 있습니다. Muse에서는 생성된 결과물을 모아 보는 보관함과 콘텐츠 제작 설정을 확인할 수 있었습니다. 다만 보관함의 구성만으로 동일 과제에서 Dots보다 결과물의 품질이 높다고 판단할 수는 없습니다.
반복 작업: 설정 화면과 실행 기록을 구분해야 합니다
Muse에는 30분마다 연결된 이메일과 Google Docs 등을 살펴볼 수 있는 반복 점검 작업과 실행 기록이 있습니다. 일정 목록과 기록을 한 화면에서 확인할 수 있다는 점은 분명합니다. 반면 이 기록만으로 중요한 메일을 얼마나 정확히 골라냈는지까지 확인되지는 않습니다. 자동 점검을 쓰더라도 실제 알림이 필요한 내용인지 사람이 검토해야 합니다.
Dots에서는 다음 날 일정을 살피는 반복 작업을 설정했지만, 이를 Dots 대화 화면에서 곧바로 관리하기는 어려웠습니다. 반복 일정을 바꾸려면 Codex나 ChatGPT의 일정 관리 화면으로 이동해야 했습니다. 또 기존 Codex 프로젝트에서 비교 작업을 요청했을 때 관련 하위 대화가 프로젝트 안에 정리되지 않고 전체 최근 대화 목록에 따로 생겼습니다. 작업을 맡기는 것과 나중에 기록을 찾아 관리하는 것은 별개의 문제였습니다.
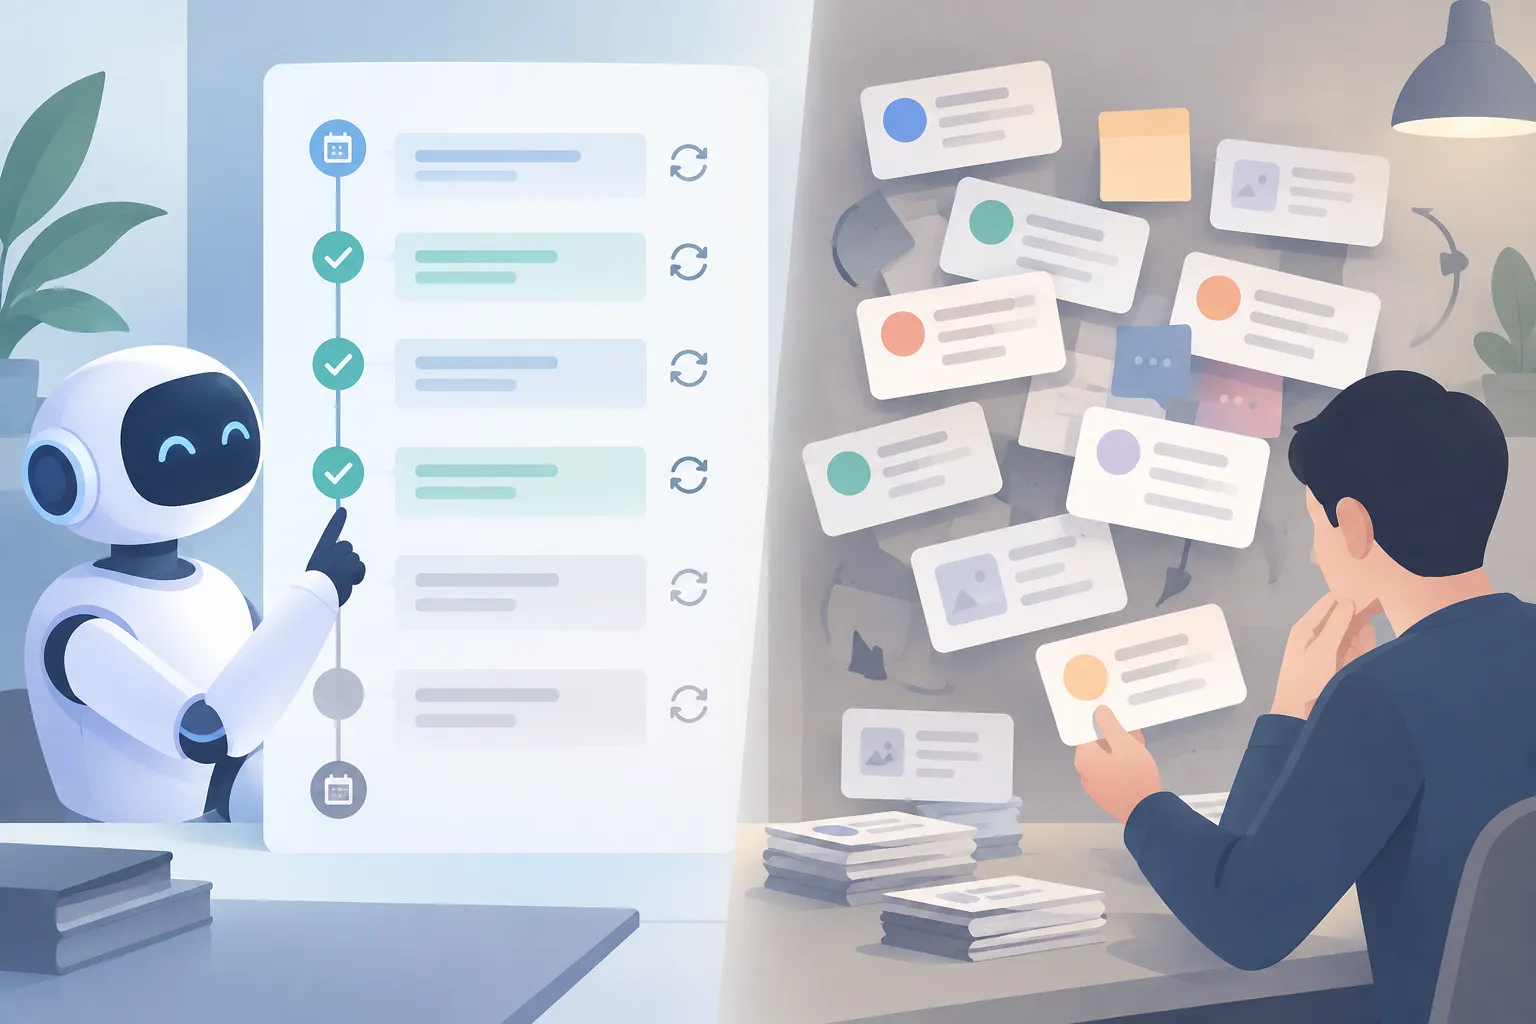
▲ 반복 작업과 기록 관리
모델 수치가 실제 사용 경험을 대신하지는 않습니다
기반 모델의 benchmark(정해진 과제로 성능을 비교하는 평가)에서는 작업 종류에 따라 우세가 갈립니다. 수치는 서비스 화면의 편의성이나 앞서 확인한 메시지 응답의 품질을 뜻하지 않습니다.
| 평가 항목 | Dots의 GPT-6 Astra | Muse의 Muse Spark 1.3 |
|---|---|---|
| 터미널·코딩 | 59% | 33% |
| 소프트웨어 서비스 자동화 | 68% | 58% |
| 전문 업무 평가 | 1,542 | 1,672 |
| 출력 생성 속도 | 초당 51 token | 초당 184 token |
여기서 token은 모델이 글을 처리하거나 생성할 때 쓰는 단위입니다. GPT-6 Astra의 코딩·자동화 점수가 높고, Muse Spark 1.3은 전문 업무 평가 점수와 출력 생성 속도가 높습니다. 특히 출력 속도가 빠르다는 수치만으로 전체 작업을 더 빨리 끝낸다고 해석해서는 안 됩니다.
선택 전에 한 가지 작업부터 확인합니다
Slack과 Codex에 이미 작업이 쌓여 있다면 Dots에 실제 프로젝트 요청을 맡겨 보고, 답변뿐 아니라 참조한 맥락과 생성된 대화의 위치까지 확인하는 편이 좋습니다. WhatsApp으로 일상적인 요청을 보내거나 반복 점검을 관리하려면 Muse에서 답장, 실행 기록, 승인할 작업을 함께 살펴볼 수 있습니다.
비용도 시험 범위를 정할 때 고려할 조건입니다. Muse는 주당 최대 1억 token을 제공하는 무료 요금제가 있고, Dots는 월 $100부터 시작하는 ChatGPT Pro 구독이 필요합니다. 두 서비스 중 하나를 기능 목록만으로 고르기보다, 자주 쓰는 채널에서 작은 작업을 맡긴 뒤 결과와 사람이 수정해야 하는 단계를 확인하는 것이 실용적입니다.