OpenAI가 DevDay에서 공개한 GPT-6.1 Sol로 여러 앱이 연결된 브라우저 데스크톱과 플레이 가능한 3D 게임을 만들고, 실물 로봇 팔까지 조작해 본 결과가 나왔습니다. 기능은 대체로 작동했지만, 작동하는 것과 시각적으로 잘 다듬어진 것은 별개였습니다. 첫 3D 결과물의 외형은 같은 과제를 앞서 수행한 Claude Sonnet 5.5보다 덜 다듬어졌고, 원하는 수준의 참고 이미지를 주자 크게 나아졌습니다.
사양과 성능 점수
OpenAI는 GPT-6.1 Sol을 GPT-6 Astra에 가까운 지능을 5분의 1 비용으로 제공하는 모델로 소개했습니다. API 가격은 Claude Sonnet 5.5와 같은 가격대입니다.
| 항목 | GPT-6.1 Sol |
|---|---|
| API 가격 | 입력 100만 token당 $2, 출력 100만 token당 $10 |
| 캐시 입력 | 100만 token당 $0.10 |
| 컨텍스트 창 | 105만 token |
| 최대 출력 | 12만 8,000 token |
| 학습 데이터 기준일 | 2026년 4월 30일 |
| 입출력 | 텍스트·이미지 입력, 텍스트 출력 |
token은 모델이 글을 처리할 때 세는 단위이고, 컨텍스트 창은 한 번에 다룰 수 있는 입력의 양입니다. 소프트웨어 공학 평가인 DeepSWE v1.1에서 GPT-6.1 Sol은 GPT-6 Astra의 기본 성능과 비슷했고, GPT-6 Sol보다 6.4%p 높았습니다. 추론 설정에 따른 결과는 다음과 같습니다.
| 추론 설정 | 평가 점수 | 과제당 비용 |
|---|---|---|
| High | 75.2% | $0.65 |
| Max | 71.9% | $0.97 |
추론 설정을 높인 쪽의 점수가 오히려 낮았습니다. 모델이 과제를 지나치게 복잡하게 풀면서 평가 기준을 벗어나는 경우가 있기 때문입니다. 복잡한 앱을 얼마나 잘 만드는지는 점수만으로 판단하기 어려워, 실제 제작 결과에서 실행 여부뿐 아니라 앱 간 연결, 시각 품질, 오류가 생겼을 때의 동작까지 확인할 필요가 있습니다.
브라우저 데스크톱은 여러 기능을 연결했습니다
GPT-6.1 Sol은 가장 높은 추론 설정에서 33분 42초 만에 단일 HTML 파일로 구성된 Halo OS를 만들었습니다. 컴퓨터에 설치하는 운영체제가 아니라, Google Chrome에서 실행되는 다중 창 데스크톱 앱입니다. WebGPU를 활성화한 환경에서 데스크톱과 앱 실행 기능이 작동했습니다.
안에는 운전과 배달을 할 수 있는 3D 게임 Signal City와 장애물을 피해 고리를 통과하는 비행 게임 Orbital Run이 들어 있습니다. 비행을 마치면 결과가 메일 앱에 기록됐고, 메모를 작성해 파일로 내보내거나 Continuum으로 열린 창과 작업 상태를 저장·복원할 수도 있었습니다. 개별 앱을 나열하는 데 그치지 않고 상태를 주고받았다는 점이 이 결과물의 강점으로 보입니다.
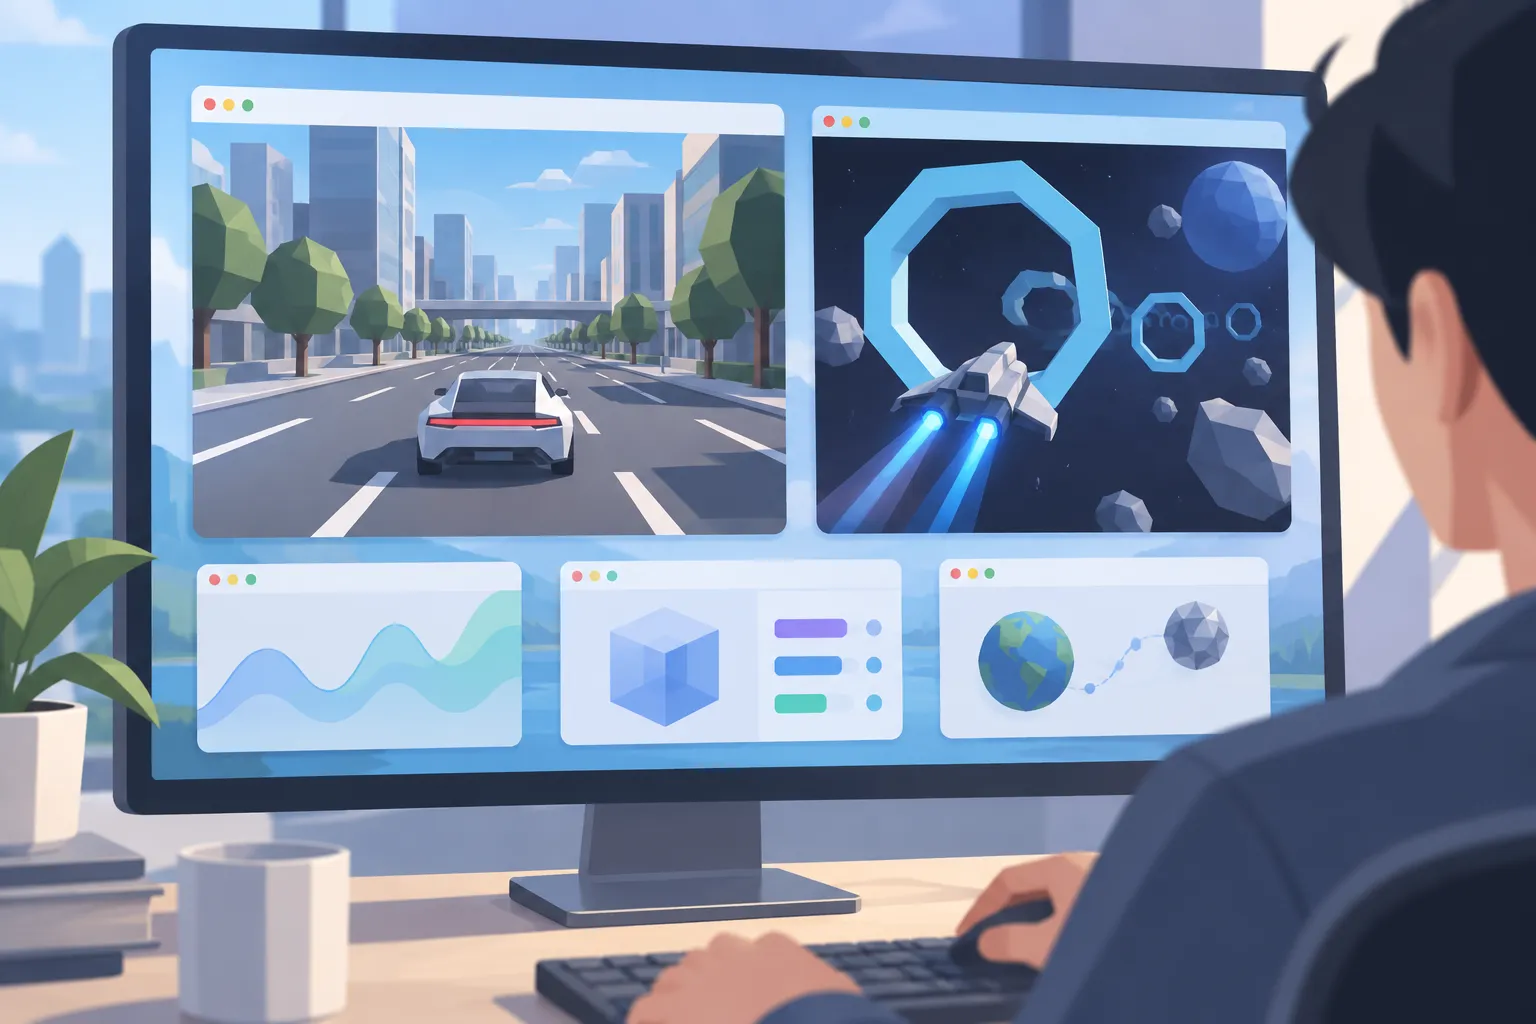
▲ 브라우저 게임 연동
완성도가 균일하지는 않았습니다. 일부 앱 아이콘이 나타나지 않았고, Signal City에서는 경찰차가 플레이어 차량 바로 근처에 생성됐습니다. 조작 반응은 빠르고 앱 간 연결도 매끄러웠지만, 전날 Claude Sonnet 5.5가 만든 결과물과 비교하면 시각적 완성도는 낮아 보인다는 평가였습니다. 대신 제작 속도는 GPT-6.1 Sol이 눈에 띄게 빨랐습니다.
게임은 작동했지만 첫 결과의 외형에는 차이가 있었습니다
Godot와 Blender로 만든 수영장 다이빙 게임은 캐릭터 4명을 고르고, 점프를 조절해 회전과 물 튀김 효과에 따른 점수를 얻을 수 있었습니다. 빠른 모드를 켠 첫 제작은 18분 12초가 걸렸습니다. 빠른 모드가 작업 일부를 성능이 낮은 하위 agent에 맡겨 품질이 떨어졌을 수 있어, 작업 환경을 비우고 빠른 모드를 끈 뒤 다시 만들었습니다. 이 버전은 약 51분이 걸렸고 게임 동작도 갖췄습니다. 그러나 같은 과제를 앞서 수행한 Claude Sonnet 5.5의 결과는 물 입자 효과와 캐릭터 애니메이션, 익살스러운 실패 장면에서 더 풍부했습니다.
C++ 스케이트보드 게임에서도 비슷한 차이가 드러났습니다. 첫 결과는 기술을 수행한 뒤 다시 보는 시네마틱 재생 기능까지 작동했지만, 거리 풍경은 단출했습니다. 이후 원하는 시각적 수준을 보여 주는 참고 이미지를 제공하고 단일 파일 제약을 풀자, 물에 주변 풍경이 비치는 해안가와 상점이 추가됐습니다. 다만 보행자와의 충돌 처리는 여전히 빠져 있었습니다. 첫 결과만으로 시각적 구현 능력을 단정하기 어렵다는 사례입니다.
다른 과제에서는 강점과 결함이 함께 나타났습니다. 지하철을 타고 다음 역으로 이동하는 3D 슈팅 게임은 약 46분 만에 제작돼 전투와 역 간 이동이 작동했습니다. Old School RuneScape를 재현한 브라우저 게임은 약 20분 만에 익숙한 메뉴와 아이템 화면을 갖췄지만, 일부 특수 공격은 반응하지 않았습니다.
로봇 팔에서는 완료와 안전을 따로 봐야 합니다
실물 로봇 팔은 약 18분 동안 장난감 자동차의 위치가 바뀔 때마다 움직임을 조정했습니다. 하지만 자동차를 안정적으로 집어 옮기는 데 실패했습니다. 작업을 계속 밀어붙이는 대신 팔을 위로 세운 안전한 자세로 정지했습니다. 목표 달성으로 평가할 수는 없어도, 물리적 작업에서는 실패 뒤 어떻게 멈추는지가 별도의 평가 항목임을 보여 줍니다.
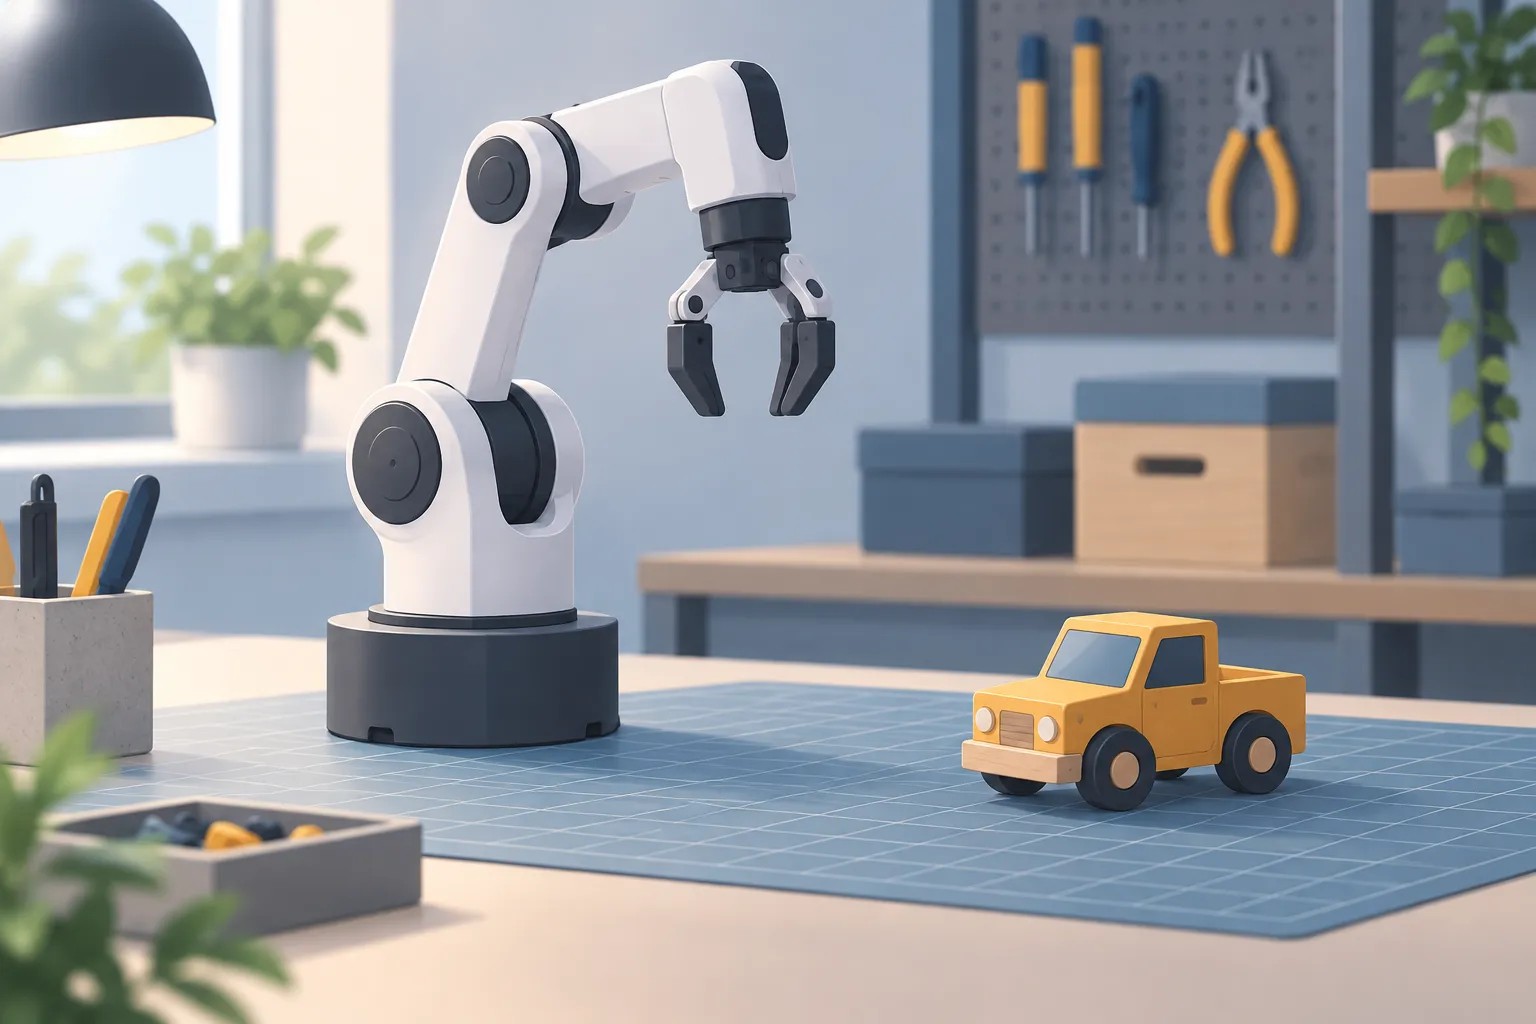
▲ 로봇 팔의 안전한 정지
비교할 때 확인할 것
GPT-6.1 Sol의 결과는 복잡한 기능을 구현하는 능력과 시각적 마감 수준을 나눠 봐야 한다는 쪽에 가깝습니다. 기술 작업에서는 믿을 만하고 비용 효율적인 모델로, Claude Opus 같은 최상위 모델과도 겨뤄 볼 만하다는 평가입니다. 여러 과제를 돌리는 동안 ChatGPT Pro 계정의 주간 한도는 98%에서 95%로 3%만 줄었습니다. 한 계정의 사용량이지만 token 효율을 가늠하는 참고가 됩니다.
다중 앱 과제라면 게임 결과가 다른 앱에 반영되는지까지 시험하고, 3D 외형이 중요하다면 원하는 수준의 참고 이미지를 준 뒤 수정 결과를 확인하는 것이 좋습니다. 실물 장치를 다루는 과제에서는 성공 여부와 안전한 정지 여부를 따로 기록할 필요가 있습니다. 모델을 고를 때는 같은 과제와 조건에서 나온 결과물을 놓고 기능, 시각 품질, 실패 양상을 각각 비교해야 합니다.