RunPod Flash로 이미지 생성 AI SaaS(웹에서 제공하는 소프트웨어 서비스)를 만들면, GPU를 계속 켜 두는 대신 요청에 맞춰 작업자를 실행할 수 있습니다. 컨테이너 설정 파일을 직접 작성하지 않고 배포할 수 있다는 점도 특징입니다. 다만 ‘$1에 이미지 3,000장’은 서비스 전체의 제작 단가가 아니라, 특정 GPU에서 특정 모델의 요청을 처리할 때 나온 계산치입니다.
3,000장은 어떤 조건에서 나오는가
비교 대상인 상용 이미지 생성 API의 비용은 이미지당 약 $0.03~0.04, $1에 대략 25장입니다. 반면 RunPod Serverless에서 SDXL-Turbo로 512×512 이미지를 생성한 측정은 GPU 작업자가 이미 준비된 상태에서 요청당 총 1.1초였습니다. 사용한 GPU는 시간당 $1.10인 24GB 등급이며, 이를 초당 약 $0.0003로 환산해 1.1초를 곱하면 이미지당 약 $0.00033가 됩니다.
| 비용을 계산하는 상황 | 이미지당 GPU 비용 | $1당 이미지 수 |
|---|---|---|
| 준비된 작업자에 요청이 이어지는 경우 | 약 $0.00033 | 약 3,000장 |
| 요청이 드물어 유휴 시간이 과금되는 경우 | 약 $0.002 | 약 500장 |
| 상용 이미지 생성 API | 약 $0.03~0.04 | 대략 25장 |
두 번째 행은 요청마다 유휴 시간을 포함해 약 7초가 청구되는 상황을 가정합니다. 따라서 500~3,000장은 트래픽과 청구 시간에 따라 달라지는 범위이지, 서비스에 적용되는 고정 단가가 아닙니다. 같은 측정에서 실제 GPU 연산은 297밀리초였고, 나머지 약 800밀리초는 대기·요청 전달·이미지 직렬화 등에 쓰였습니다. 연산만 빨라져도 요청 전체 시간이 같은 비율로 줄지는 않는 이유입니다.
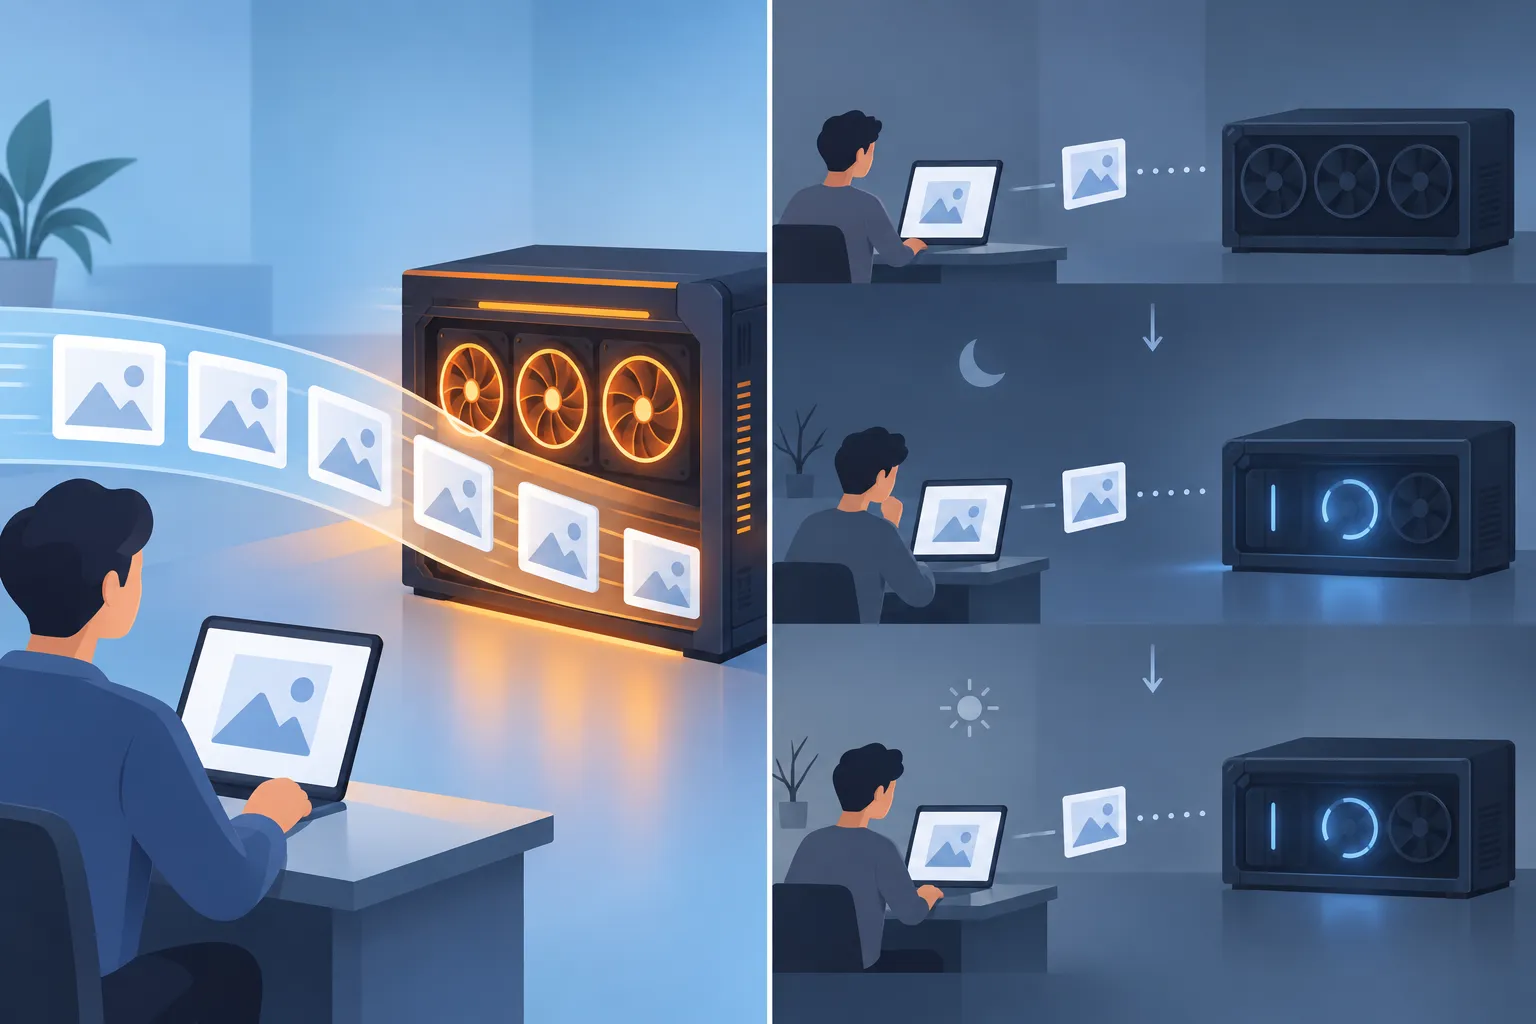
▲ 트래픽에 따른 작업자 상태
GPU 작업자와 웹 서비스를 나누어 구축합니다
구성 사례는 두 이미지 모델의 결과를 나란히 보여주고 이용자가 선택하는 서비스입니다. SDXL-Turbo는 24GB GPU에서 생성 단계 2회, FLUX.1-schnell은 48GB GPU에서 생성 단계 4회로 실행합니다. 사용자가 prompt(이미지 생성을 지시하는 입력 문장)를 보내면 두 작업자에 동시에 요청하고, 먼저 완성된 이미지를 우선 표시합니다. 투표 전에는 모델 이름을 서버 응답에서 제외하고, 투표가 끝난 뒤 결과를 공개합니다.
웹 앱과 API는 Cloudflare Workers에서 Hono와 React를 이용해 제공하고, GPU 연산은 RunPod Serverless로 분리합니다. 생성 이미지는 외부 전송 요금이 없는 Cloudflare R2에 저장합니다. 인증 정보와 이용 기록, 이용권 변동 내역은 Cloudflare D1에 둡니다. 가입자에게는 이용권 5개를 주고, 두 모델이 이미지를 생성하는 대결 한 번에 1개를 사용합니다. 유료 구성은 Stripe를 통한 이용권 500개에 $9입니다.
이 구조에서는 이미지 한 장의 GPU 단가와 대결 한 번의 원가를 혼동하지 않는 것이 중요합니다. 대결에는 GPU 작업자 두 개가 관여하며, 위 비용표는 그중 SDXL-Turbo가 실행된 24GB GPU의 이미지 생성 계산입니다. 두 모델의 GPU 비용 외에도 이미지 저장, 웹 서비스, 데이터베이스 운영을 별도로 살펴야 합니다.
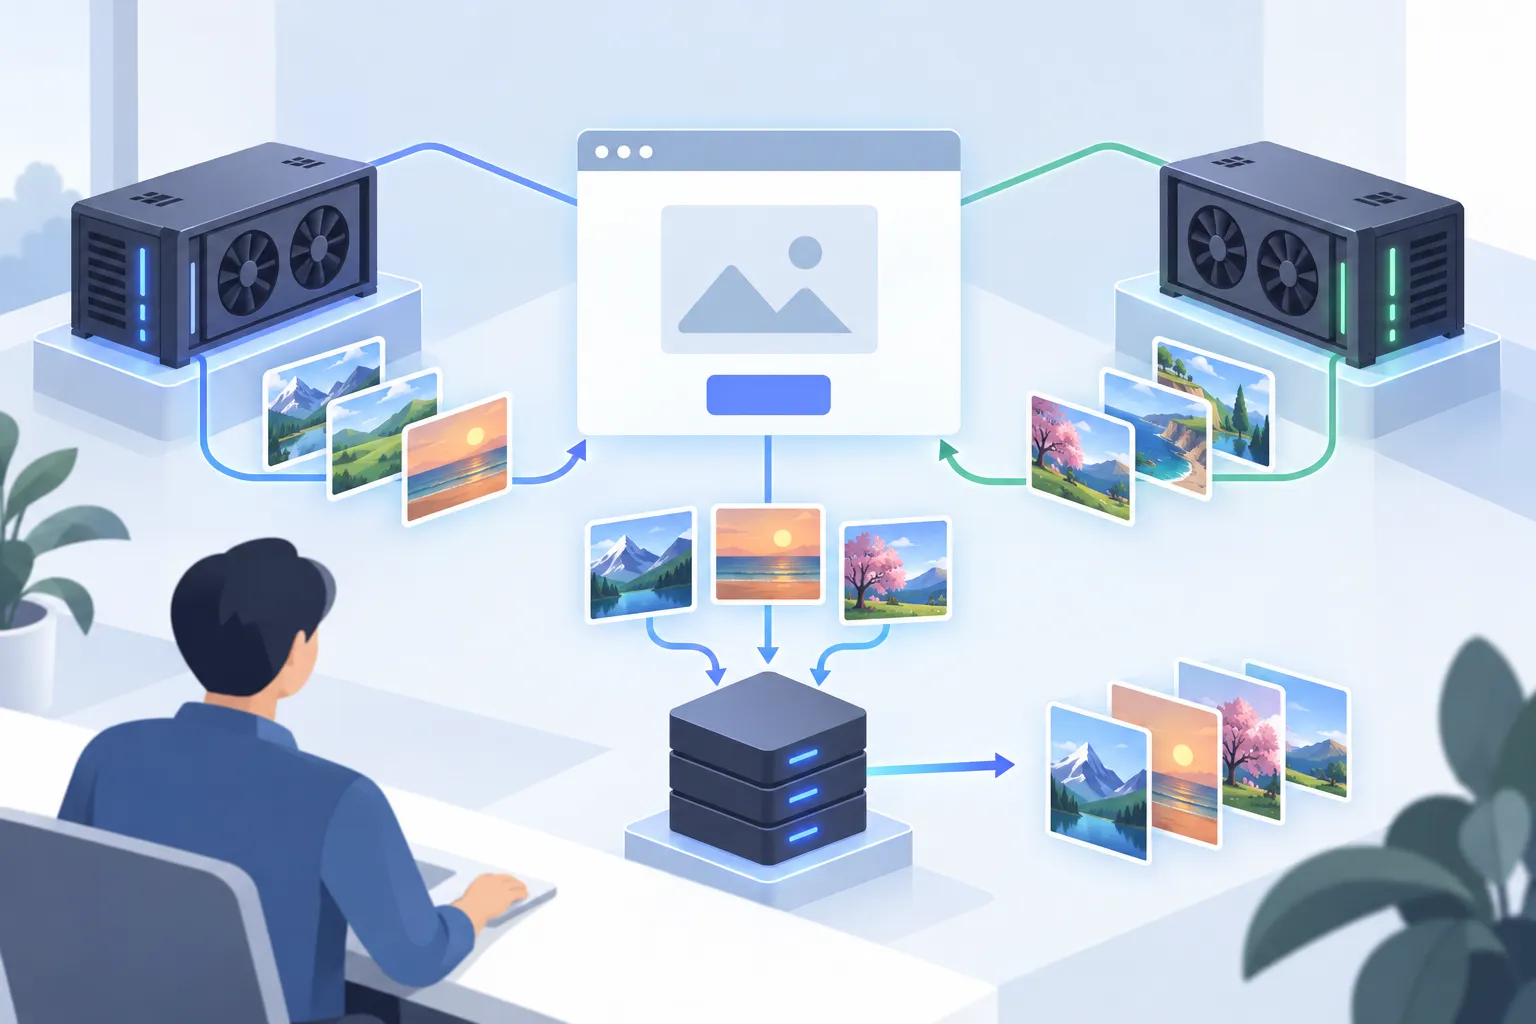
▲ 웹 앱과 GPU 작업자의 분리
컨테이너 설정 파일 없이 배포하되, 초기화 위치를 확인합니다
RunPod Flash는 Python 클래스에 @endpoint를 붙여 원격 요청을 처리할 endpoint(요청을 보내는 실행 지점)를 정의합니다. GPU 후보, 작업자 수, 의존성 목록도 코드에서 지정하며, 컨테이너 생성은 서비스가 처리합니다. 개발자는 기존 방식처럼 컨테이너 설정 파일을 직접 만들고 GPU 드라이버에 맞는 환경을 조정할 필요가 없습니다. uv로 환경과 의존성을 준비한 뒤 flash login으로 인증하고, flash dev에서 개발한 작업자를 flash deploy로 배포하는 흐름입니다. 개발 모드의 요청은 매번 cold start(중지된 작업자가 다시 시작하며 겪는 초기화 지연)로 처리되므로 성능 측정에는 쓰지 않습니다.
비용 설정의 출발점은 scale-to-zero(요청이 없으면 작업자를 0개로 줄이는 설정)입니다. 작업자 수를 최소 0개, 최대 5개로 지정하면 사용하지 않을 때 GPU를 중지하면서 작업자 증가에도 상한을 둘 수 있습니다. 반대로 24GB GPU 한 대를 계속 켜 두면 유용한 작업을 하지 않아도 월간 비용이 약 $800에 이를 수 있습니다. 사례의 유휴 종료 시간은 300초로 설정돼 있으므로, 자신의 요청 간격에서 어느 정도의 유휴 시간이 청구되는지 확인해야 합니다.
모델 가중치는 요청 처리 때마다 읽지 않고 클래스 초기화 단계에서 한 번 불러옵니다. 초기 적재에는 약 15초가 걸리지만, 이를 요청마다 반복하면 이미지당 약 $0.005의 추가 비용이 붙는다는 계산입니다. cold start 측정에서는 전체 요청이 67초까지 늘어났습니다. 약 7GB의 모델 가중치를 처음 내려받는 상황을 고려하면, 준비된 작업자의 1.1초를 모든 이용자의 대기 시간으로 제시해서는 안 됩니다. 오래 걸리는 작업은 비동기로 제출하고 상태를 확인하는 방식으로 처리해, 동기 요청의 60초 제한도 피합니다.
도입 전에는 이미지당 비용이 아닌 서비스 단위를 계산합니다
먼저 예상 요청 수와 요청 간격을 정하고, GPU가 준비된 요청과 cold start를 나누어 측정하는 편이 좋습니다. 이어 두 모델을 함께 실행하는 대결 한 번의 GPU 청구 시간, 유휴 종료 설정, 이미지 저장과 전송 비용을 각각 합산해야 합니다. 지연 시간이 일정해야 한다면 GPU 모델을 지정하는 방안도 살펴야 합니다. 범용 24GB 등급을 요청했을 때 RTX 4090 대신 Blackwell MIG slice(GPU 하나를 나눠 별도 인스턴스로 할당한 단위)가 배정되면 추론이 1.8배 느렸던 측정이 있기 때문입니다. 요청이 몰릴 때의 배정 속도와 cold start 감소가 더 중요하다면 호환되는 GPU 목록을 넓게 지정하는 편이 낫습니다.
요청량이 적다면 자체 운영이 꼭 유리한 것은 아닙니다. 한 달에 이미지 50장을 생성해 상용 API에 약 $2를 쓰는 경우나 매 요청에서 cold start 없는 응답이 중요한 경우에는 상용 API가 더 적합할 수 있습니다. RunPod Flash의 비용 이점은 GPU 작업자를 0개까지 줄이고, 모델을 한 번만 적재하며, 실제 트래픽에서 청구 시간을 확인할 때 판단할 수 있습니다.