클라우드 대신 내 컴퓨터에서 AI 모델을 돌리려 할 때 가장 먼저 부딪히는 질문은 “이 장비로 얼마나 빠르고 똑똑한 모델을 쓸 수 있는가”입니다. 답을 좌우하는 숫자는 두 가지로 압축됩니다. 메모리 용량은 어떤 크기의 모델을 올릴 수 있는지를 정하고, 메모리 대역폭은 그 모델이 초당 몇 개의 token(AI가 글을 만들어 내는 최소 단위)을 생성하는지를 정합니다. 이 글에서는 이 두 숫자를 기준으로 저가, 중가, 고가 세 가지 구성을 비교하고, 예산별로 현실적인 기대치를 정리합니다.
로컬 AI는 결국 숫자로 가득한 파일 하나입니다
AI 모델은 가중치(weight)라고 부르는 숫자들을 담은 파일입니다. 예를 들어 17GB짜리 파일 하나에 모델이 학습한 사실, 개념, 언어 지식이 모두 숫자 형태로 들어 있습니다. 이 파일을 내려받아 내 컴퓨터에서 실행하면 모든 계산이 내부 하드웨어에서만 일어납니다.
그래서 로컬 실행에는 다음과 같은 장점이 있습니다.
- 데이터가 외부 서버로 전송되지 않아 개인정보가 보호됩니다.
- 구독료나 사용량 제한이 없습니다.
- 한 번 내려받은 모델은 외부 회사가 바꾸거나 서비스를 종료할 수 없습니다.
클라우드, 하이브리드, 완전 로컬의 차이
많은 사람이 헷갈리는 부분은 ’내 컴퓨터에서 돌아가는 것처럼 보이는 도구’가 모두 로컬 AI는 아니라는 점입니다.
| 구성 | 인터페이스 위치 | 모델 위치 | 데이터 외부 전송 |
|---|---|---|---|
| 완전 클라우드 (브라우저의 ChatGPT 등) | 원격 서버 | 원격 서버 | 있음 |
| 하이브리드 (Cursor, Claude Code 등) | 내 컴퓨터 | 원격 서버(API 호출) | 있음 |
| 완전 로컬 | 내 컴퓨터 | 내 컴퓨터 | 없음 |
하이브리드 도구는 앱이 내 컴퓨터에서 실행되지만, prompt와 프로젝트 코드는 API(프로그램끼리 요청을 주고받는 통로)를 통해 Anthropic이나 OpenAI의 서버로 넘어갑니다. 확인하는 방법은 간단합니다. 와이파이를 끄고도 AI 도구가 계속 작동한다면 진짜 로컬입니다.
다만 대가도 분명합니다. Kimi K3나 GLM 5.2처럼 수조 개 파라미터를 가진 최상위 모델은 수 테라바이트 규모라 개인 장비로는 돌릴 수 없고, 수십억 달러 규모의 데이터센터에서 돌아가는 클라우드 최상위 모델과 성능을 겨루는 것은 불가능합니다.
모델 이름을 읽으면 필요한 메모리가 보입니다
오픈소스 모델은 대부분 AI 모델의 저장소 역할을 하는 Hugging Face에 올라와 있습니다. 파일 이름이 복잡해 보이지만 규칙을 알면 필요한 사양을 가늠할 수 있습니다. ’Qwen 3.8 27B Q4’를 예로 들어 보겠습니다.
| 표기 | 의미 |
|---|---|
| Qwen | Alibaba가 개발한 모델 계열. 가장 많이 내려받는 로컬 모델 중 하나 |
| 3.8 | 계열 안에서의 버전(세대) |
| 27B | 파라미터 270억 개. 클수록 추론 능력이 좋아지지만 메모리와 연산량도 늘어남 |
| Q4 | 4비트 양자화. 16비트나 32비트로 저장된 숫자를 4비트로 줄인 압축 방식 |
양자화는 모델 파일을 원래 크기의 약 4분의 1로 줄이면서 품질 손실은 최소화하는 기법입니다. 일반 소비자용 장비에서 쓸 만한 모델을 돌릴 수 있는 것도 이 덕분입니다. 따라서 개인 장비라면 파일 이름에 Q4가 붙은 모델부터 찾는 것이 메모리와 품질 사이의 균형을 잡는 방법입니다.
MoE는 큰 모델을 빠르게 돌리는 구조입니다
MoE(Mixture of Experts, 전문가 혼합)는 하나의 거대한 신경망 대신 여러 개의 작은 전문 하위 신경망을 두는 구조입니다. 모든 파라미터가 메모리에 올라가 있어야 하는 점은 같지만, token 하나를 만들 때는 일부 ‘전문가’ 가중치만 계산에 참여합니다. 그래서 같은 크기의 일반 모델보다 훨씬 빠르게 답을 생성합니다. 큰 모델의 폭넓은 능력이 필요하면서 속도도 포기하기 어렵다면 MoE 모델이 좋은 선택지가 됩니다.
어떤 모델부터 받아야 할까
실용적인 출발점은 Qwen 계열입니다. Qwen 3.5 4B, Qwen 3.8 27B, Qwen 3-Coder-Next, Qwen 3.5 122B MoE 등이 대표적입니다.
- 4B급 소형 모델: 저장 공간 1~2GB. 최신 컴퓨터라면 대부분 무난하게 돌아갑니다.
- 8B~35B: 괜찮은 장비에서 높은 성능을 내는 최적 구간입니다.
- 27B급: 24GB 안팎의 메모리를 목표로 잡아야 합니다.
- DeepSeek, Kimi, Zhipu GLM의 조 단위 파라미터 모델: 기업용 데이터센터가 필요하므로 개인이 시도할 대상이 아닙니다.
속도를 정하는 두 숫자: 용량과 대역폭
로컬 AI의 첫 번째 규칙은 모델 전체가 빠른 메모리 안에 여유 있게 들어가야 한다는 것입니다. 여기서 빠른 메모리란 Windows나 Linux 컴퓨터의 그래픽카드에 달린 VRAM(그래픽 전용 메모리), 또는 Apple Silicon Mac의 통합 메모리를 말합니다.
▲ 메모리 용량과 대역폭의 차이
| 항목 | 전용 그래픽카드 (예: RTX 4090) | Apple Silicon Mac (일반 구성) |
|---|---|---|
| 메모리 용량 | 24GB | 64GB 또는 128GB까지 |
| 메모리 대역폭 | 초당 1TB 이상 | 상위 전용 GPU의 약 20~30% |
| 강점 | 빠른 token 생성 | 더 큰 모델 적재 |
| 약점 | 올릴 수 있는 모델 크기 제한 | 생성 속도가 느림 |
이 표를 해석하면 선택의 기준이 뚜렷해집니다. 같은 크기의 모델이라면 전용 GPU가 훨씬 빠르게 답을 내고, Mac은 더 큰 모델을 올릴 수 있는 대신 속도에서 손해를 봅니다. 결국 ’더 똑똑한 모델(용량)’과 ‘더 빠른 응답(대역폭)’ 중 무엇을 우선할지 먼저 정해야 장비 선택이 쉬워진다고 볼 수 있습니다.
예산별 세 가지 구성 비교
먼저 짚어 둘 점이 있습니다. 2026년 현재 전 세계적인 RAM 공급 부족으로 메모리 부품 가격이 이례적으로 높고 변동도 심합니다. 아래 가격은 참고용으로 보고, 실제 구매 판단은 메모리 용량과 대역폭이라는 사양을 기준으로 하는 편이 안전합니다.
저가 구성 ($300~800): 가볍게 시작하는 단계
- PC: NVIDIA RTX 3060 12GB. 중고는 $300~400 선이며, NVIDIA가 이 칩의 신품 생산을 재개해 권장 소비자가는 $339입니다.
- Mac: 기본형 Mac Mini, 약 $799~800.
- 성능: RTX 3060에서 4비트 양자화한 8B 모델이 초당 40~50token을 냅니다. Mac Mini도 같은 8B 모델을 돌릴 수 있지만 속도는 조금 낮습니다.
- 적합한 용도: 문서 초안 작성, 요약, 민감한 문서 검토.
- 한계: 여러 단계를 스스로 수행하는 코딩 agent를 돌리기에는 지능이 부족합니다.
중가 구성 ($800~1,800): 실제 업무 도구가 되는 단계
이 구간부터 로컬 AI가 실험용 장난감에서 생산적인 작업 환경으로 바뀐다고 볼 수 있습니다.
- PC: NVIDIA RTX 3090 24GB, 약 $800~1,000. 높은 메모리 대역폭을 갖췄습니다.
- Mac: M4 Pro 칩과 48GB 통합 메모리를 갖춘 Mac Mini, 약 $1,800.
- 성능: Qwen 3.8 27B 같은 27B급 모델을 4비트 양자화로 충분히 쓸 만한 반응 속도로 돌립니다.
- 적합한 용도: 24~48GB 메모리는 자율 코딩 agent를 운영하고 복잡한 개발 작업을 로컬에서 처리할 만한 추론 능력과 컨텍스트(한 번에 다룰 수 있는 입력 분량) 여유를 제공합니다. RTX 3090에서 Qwen 3.8 27B Q4를 돌려 보안이 중요한 소프트웨어 개발에 쓰는 방식이 대표적입니다.
고가 구성 ($2,500~5,500): 100B급 모델을 올리는 단계
목표는 128GB의 빠른 메모리로 120B급 대형 모델을 수용하는 것입니다.
| 장비 | 가격 | 특징 |
|---|---|---|
| AMD Strix Halo 미니 PC | 약 $2,500 | 128GB 구성의 가장 저렴한 선택지 |
| Mac Studio (M5 Max, 128GB) | 약 $2,499 | 대용량 통합 메모리 |
| Mac Studio (M5 Ultra) | $5,499 | 일반 Apple 구성 대비 메모리 대역폭 4배 |
| NVIDIA DGX Spark | 약 $5,000 | 실측 속도가 확인된 구성 |
M5 Ultra는 일반 Apple 구성보다 메모리 대역폭이 4배 넓어 Mac의 약점이던 속도 병목을 크게 줄여 줍니다. DGX Spark에서의 실측 결과는 다음과 같습니다.
- 120B 모델: 초당 약 40token
- 35B~70B 모델: 초당 60~90token
흥미로운 점은 120B 모델의 속도가 저가 구성에서 8B 모델을 돌릴 때와 비슷한 수준이라는 것입니다. DGX Spark를 기준으로 보면, 예산을 열 배 안팎으로 늘려 비슷한 속도로 열 배 이상 큰 모델을 쓸 수 있다고 대략 해석할 수 있습니다.
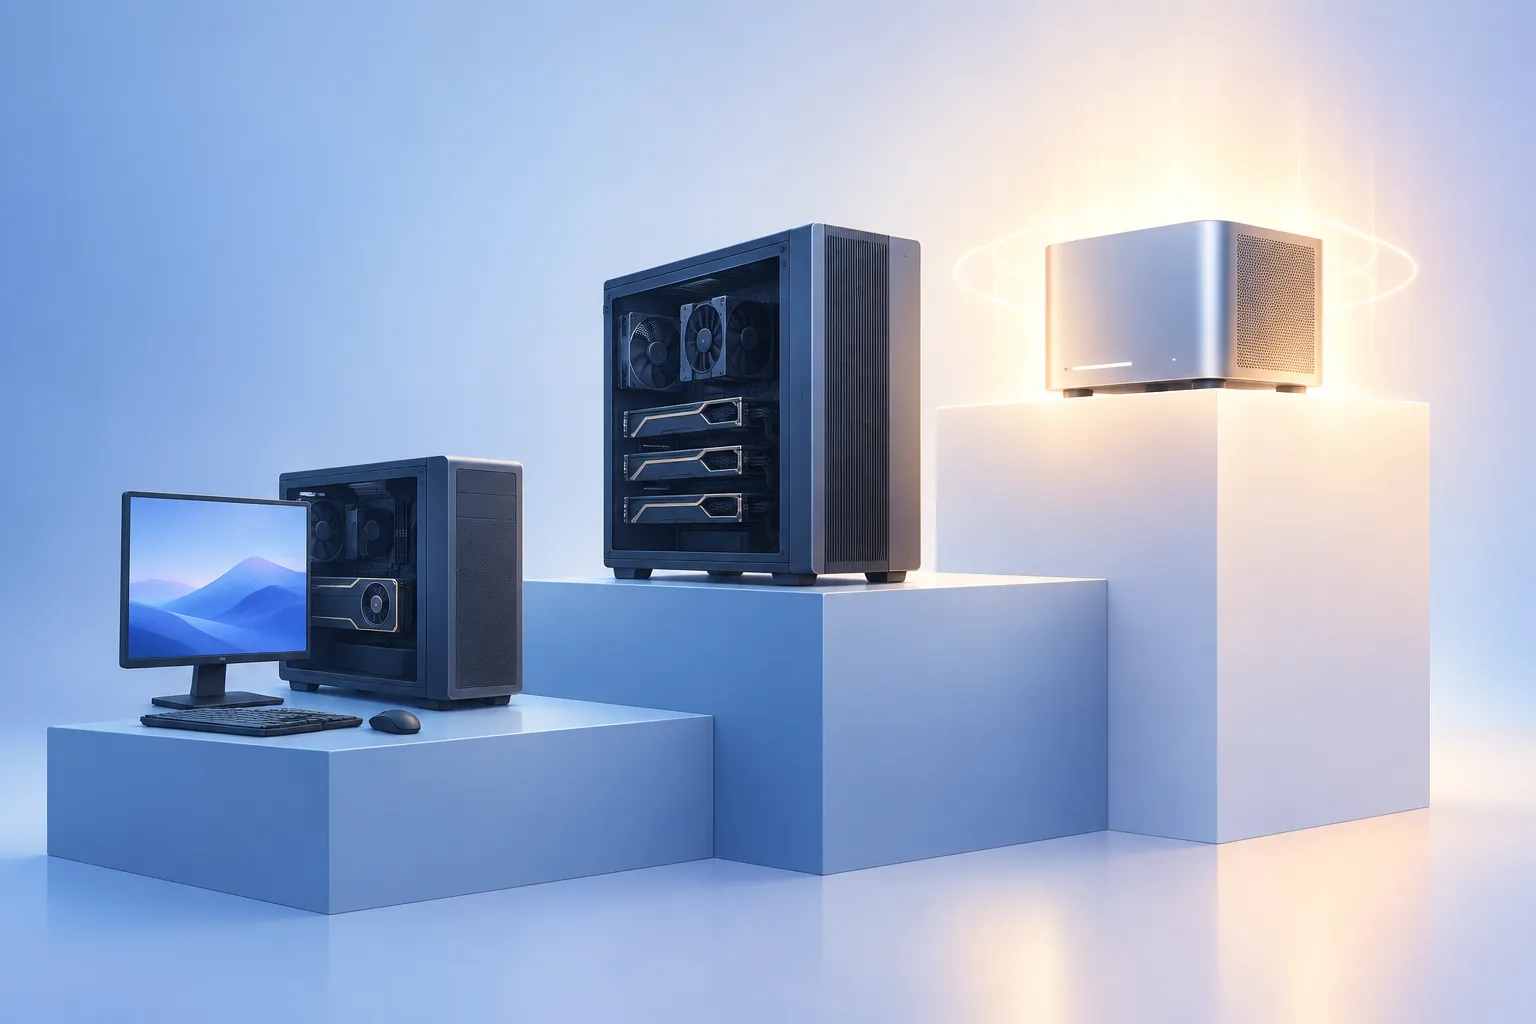
▲ 예산별 세 가지 로컬 AI 구성
한눈에 보는 세 구성
| 구분 | 예산 | 메모리 | 적정 모델 크기 | 기대 속도와 용도 |
|---|---|---|---|---|
| 저가 | $300~800 | 12GB급 | 8B (Q4) | 초당 40~50token, 초안과 요약 |
| 중가 | $800~1,800 | 24~48GB | 27B (Q4) | 쓸 만한 반응 속도, 코딩 agent |
| 고가 | $2,500~5,500 | 128GB | 35B~120B | 초당 40~90token(DGX Spark 실측), 대형 모델 활용 |
모델을 돌리려면 런타임이 필요합니다
내려받은 가중치 파일만으로는 AI를 쓸 수 없고, 추론 런타임(모델을 불러와 실행해 주는 프로그램)이 있어야 합니다. 대표적인 선택지는 세 가지입니다.
- Ollama: 가벼운 명령줄 도구로, 모델 관리가 간단합니다.
- Docker Model Runner: 컨테이너 기반 작업 환경에 적합합니다.
- LM Studio: 그래픽 인터페이스를 갖춰 처음 쓰는 사람도 다루기 쉽습니다.
이 런타임들은 표준화된 API를 갖춘 로컬 추론 서버를 띄워 주기 때문에 VS Code, 코딩 agent, 웹 채팅 화면 같은 외부 도구에 바로 연결할 수 있습니다.
클라우드 구독과 비교하면 어떨까
로컬 AI는 비용을 아끼는 만능 해법이 아닙니다. 완전한 데이터 주권과 개인정보 보호를 얻는 대신 초기 장비 비용이 크고 연산 능력에 한계가 있습니다. 월 $20~60의 클라우드 AI 구독은 훨씬 뛰어난 모델 지능과 빠른 속도, 적은 설정 부담을 제공합니다. 기밀 데이터를 다루지 않는 대다수 사용자에게는 구독이 더 나은 선택이라고 보는 것이 합리적입니다.
정리: 내 상황에 맞는 선택을 위한 체크리스트
핵심은 메모리 용량이 모델 크기를, 메모리 대역폭이 token 속도를 결정한다는 점입니다. 여기에 양자화와 MoE를 활용하면 같은 장비에서도 더 큰 모델을 더 빠르게 쓸 수 있습니다. 로컬 AI를 고민하고 있다면 다음 순서로 판단해 보시기 바랍니다.
- 정말 로컬이 필요한지 따져 봅니다. 외부로 내보낼 수 없는 데이터를 다루지 않는다면 클라우드 구독이 더 경제적일 가능성이 큽니다.
- 지금 쓰는 컴퓨터의 VRAM 또는 통합 메모리 용량을 확인합니다. 메모리가 부족하면 모델이 아예 실행되지 않습니다.
- 속도와 지능 중 우선순위를 정합니다. 속도가 중요하면 NVIDIA 전용 GPU, 큰 모델이 중요하면 대용량 통합 메모리 Mac이 유리합니다.
- 8B~35B 구간의 Q4 모델부터 시작합니다. 처음이라면 Qwen 3.5 4B 같은 소형 모델로 환경을 먼저 익혀도 좋습니다.
- LM Studio나 Ollama를 설치해 모델을 띄운 뒤, 와이파이를 끄고도 작동하는지 확인해 완전 로컬 여부를 점검합니다.
장비를 새로 사야 한다면 가격표보다 용량과 대역폭 수치를 먼저 비교하는 습관이, 가격 변동이 심한 지금 시기에 가장 확실한 기준이 될 것입니다.