Claude Codeのコードは、今やその約90%をClaudeが書いています。Anthropicは、その量にエンジニアがどう追いついているのかを明らかにしました。答えは、より多くの人がより多くの行を読むことではありません。Anthropicは「人間がこのコードを読んだか」を安全性の基準とするのをやめ、2つの問いに置き換えました。何が問題になり得るのか、そしてそれを最もよく見つけられるのは自動と手動のどのチェックなのか、という問いです。その結果が5層のレビューです。人の承認はリスクに応じて増減し、最後の安全網として素早いロールバックが控えます。6月から9月にかけて、Claude Codeチームがマージしたプルリクエスト(レビューを経てコードベースに取り込まれる、コード変更の提案)は2倍を超えて増え、そのうち差し戻しが必要になった割合は40%以上下がりました。AIエージェントにコーディングを任せる場面が増えているチームにとって、この設計は参考になる手本といえそうです。ただし、その数字とコストは注意して読む必要があります。
全行を読むやり方が通用しなくなった理由
変化の背景にあるのは量です。2026年5月、Anthropicの主要なモノレポ(多くのプロジェクトをまとめて収める単一のリポジトリ)では、1日に約2,500件の変更がマージされていました。9月の最も多かった日には、その数が30,401件に達しました。個々のエンジニアの動きも速く、Claude Codeを生み出したボリス・チェルニー氏は2026年3月、ターミナルのタブを分けて5つのClaudeセッションを並行して動かし、1日に20~30件のプルリクエスト(PR)を出していると語っていました。このペースでは、人がすべての変更を1行ずつ読むことはとても不可能です。
そこでAnthropicは、「人間が読んだ」ことを品質と信頼性を測る不正確な代わりの指標とみなしています。今の目標は、ほとんどのPRが関わる人を多くても1人に抑えてマージされることで、その1人は作成者本人でも構いません。この目標が見かけ倒しにならないよう、差し戻し率と本番環境での障害発生率という2つの指標を見ています。どちらかが上がれば、チームは時間を節約したことにはなりません。コードをレビューする手間を、後始末の手間に移しただけです。
スイスチーズの5つの層
Anthropicはこの仕組みを、安全管理のスイスチーズモデルになぞらえています。各層はそれぞれ別の種類の問題を捕まえ、すべての層をすり抜けたものは素早く元に戻せる仕組みが受け止めます。
| 層 | 実行のタイミング | 内容 |
|---|---|---|
| 1. 自己検証 | PRを開く前 | Claudeがテスト、ビルド、スクリーンショット比較を行い、まっさらな補助エージェントが変更を確認 |
| 2. Claude Code Review | 新しいPRごとに自動 | 多数のエージェントがバグを探し、別のエージェントが本物かどうかを投票 |
| 3. セキュリティレビュー | 自動 | 各指摘が修正または却下されるまでマージを阻止 |
| 4. 継続的インテグレーション(CI) | 自動 | 標準のチェックと、テストとロールバックの計画を記すPRテンプレート |
| 5. 人の承認 | リスク段階に応じて | 0人、1人、または2人 |
| 最後の安全網 | マージ後 | 素早い差し戻し |
第1層:作成者のセッション内でのチェック
最初のレビューは、PRができる前に行われます。エンジニア自身のClaudeセッションの中で、Claudeがテストを実行し、アプリケーションをビルドし、スクリーンショットを撮ってデザインモックと比較します。続いて、差分(変更された行のまとまり)をサブエージェントに渡します。サブエージェントは、コードを書いたときの会話を持たず、まっさらなコンテキストから始める補助役のエージェントです。
第2層:探すエージェントと投票するエージェント
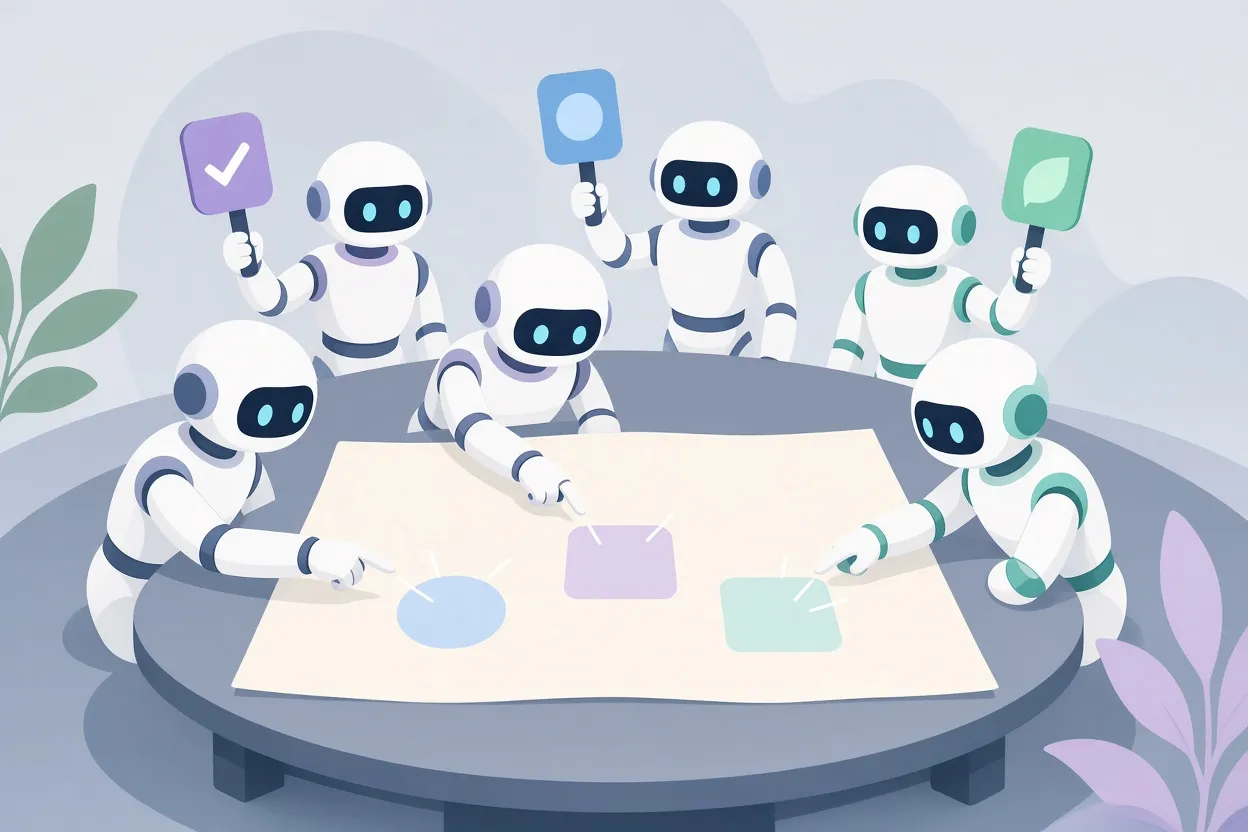
PRを開くと、Anthropicの自動レビューであるClaude Code Reviewが動き出します。複数の「finder」エージェントが変更を並行して調べ、「draftがnullになり得る」「blur時にsave()が2回実行され得る」「awaitの欠落」「使われていない値」といったバグの候補を挙げます。続いて「voter」エージェントがどの候補が本当の問題かを判断し、残ったものだけがレビューコメントになります。このように作業を分けるのは、1つのエージェントに頼ることで生じるハルシネーション(自信ありげに示される誤った主張)や誤検知を減らすためです。
▲ 探すエージェントと投票するエージェント
Claudeが多くのPRで同じ間違いを繰り返す場合、エンジニアはPRを1つずつ手で直すことはしません。リンター(スタイルや正しさを自動で確かめるチェック)のルールか、Claude Codeがセッション開始時に読む指示ファイルであるCLAUDE.mdへの1行の追記によって、そのパターンを根元から取り除きます。たとえばClaudeが現行のformatDateではなく、古いヘルパーのlegacyFormatDateを呼び出し続けるなら、チームは古いヘルパーを禁止するESLintのルールを加え、その決まりをCLAUDE.mdにも書き込めます。
コードのオーナーは、REVIEW.mdというファイルも書きます。担当するコードベースの部分で何が失敗にあたるのか、何を無視してよいのかをレビュー役に伝えるファイルです。
- 事実と異なるドキュメント:READMEには
autoSave設定が既定でオンだとあるのに、config.tsではfalseに設定されている。 - 接続先を誤る設定:
DATABASE_URLがステージングではなく本番環境を指している。 - 読み飛ばすファイル:レビューの必要がない、自動生成されたクライアントコード。
第3層と第4層:セキュリティレビューとCI
自動のセキュリティレビューは、通過しなければ先に進めない関門です。クエリ内のエスケープされていない入力といった脆弱性が見つかると、新しいコミットで問題を直すか、理由を書き添えて誤検知と記録するまで、そのPRはマージできません。その後に、変更のたびに自動で走るビルドとテストである標準のCIチェックが続きます。さらにすべてのPRは、変更をどうテストしたか、どうロールバックするかを記すテンプレートに沿って作られます。
第5層:リスクで決まる人の承認
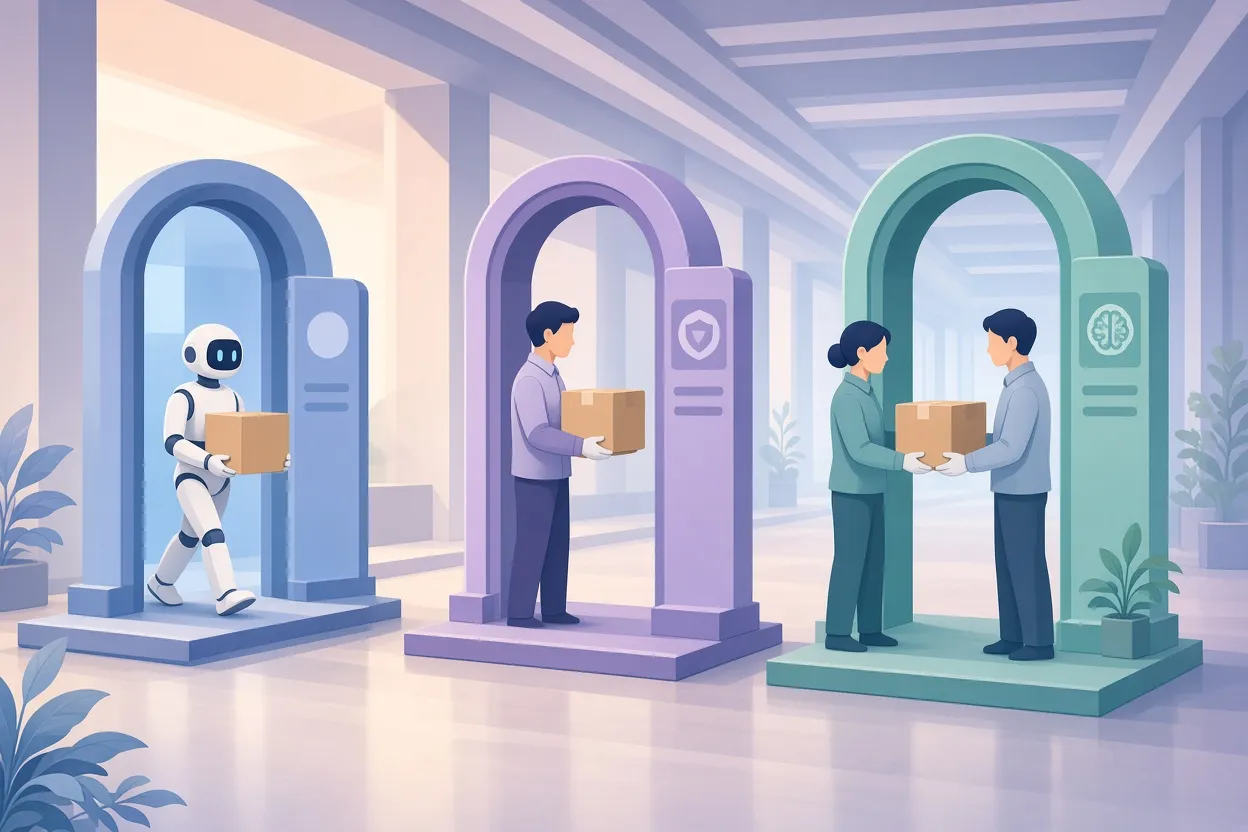
人が正式に承認するのは最後の層だけで、その人数は作成者の判断ではなくリスクで決まります。ドキュメントの変更はリスクが低いとみなされ、フィーチャーフラグ(コードをリリースしたまま新しい動作をオフにしておけるスイッチ)の裏に置かれたコードも同じ扱いです。
| リスク段階 | 典型的な変更 | 人の承認 |
|---|---|---|
| 低 | ドキュメント、フィーチャーフラグの裏に置かれたコード | 0人(自動チェックに通り、作成者が信頼されている場合) |
| 中 | 通常のプロダクトのロジック、キャッシュのような扱いに注意が要る部分 | 1人 |
| 高 | セキュリティ上重要な経路、最重要クラスのコード | 2人 |
各PRのリスク段階はAIの分類器が割り当て、それとは独立した2つ目の分類器が、人による監督が必要かどうかを改めて確かめます。
▲ リスク段階別の人の承認
レビュー役を毎日テストする
自動レビューの価値は実績しだいです。そのためAnthropicは、レビュー役を毎日テストしています。本番環境での障害や差し戻しは、テストケースに変換されます。そのコード領域に詳しいエンジニアが各ケースを確かめてから評価セットに加え、レビュー役は毎日、セット全体に対して採点されます。レビュー役のプロンプト、ツール、モデルの変更案は、全体のスコアが上がる場合にだけ採用されます。
見つけたバグの数だけで採点すると、ゆがんだ動機が生まれます。すべての行に指摘を付けるレビュー役が、優秀に見えてしまうからです。これを防ぐため、Anthropicは作成者がレビューコメントにどう反応したかも記録し、ノイズを測って減点できるようにしています。
エージェントがエージェントをレビューするとき
作成者とレビュー役がどちらもAIエージェントだと、新たな問題が生まれます。レビューが終わらなくなるおそれがあるのです。ある例では、社内のコマンドラインツールに対する1件のPRが、一晩で50回を超えるレビューと修正を繰り返し、エンジニアが割って入るまで続きました。繰り返されたラウンドを調べたところ、指摘された問題の約59%は、直近の編集で入り込んだ欠陥ではなく、最初のレビューの時点からあったコードを指していました。つまりこのループは、新しいバグを見つけるのではなく、古いコードを何度も蒸し返していたことになります。
3つの変更でこの問題は解消しました。
- 3ラウンドの上限。 3ラウンドを終えたら、作成役のエージェントに一歩引いて取り組み方を考え直すよう指示します。
- 差分だけの再レビュー。 以降のラウンドでは、前のラウンドから変わった行だけをレビューします。
- バグの種類ごとの指摘。 「userがnullになり得る」という問題が
api.ts、form.ts、list.ts、menu.tsにあれば、レビュー役は4つをまとめて報告し、作成役のエージェントは1回のコミットですべてを直せます。
| 指標 | 変更前 | 変更後 |
|---|---|---|
| 1ラウンドで通過したPR | 65% | 78% |
| 5ラウンド以上かかったPR | 8.9% | 1.5% |
| 通過までの平均ラウンド数 | 2.08 | 1.32 |
2つの注意点:差し戻しとコスト
見出しになった差し戻しの数字は、もう一度よく見る価値があります。差し戻されるPRの割合が40%下がったと聞くと明らかな成果に思えますが、同じ期間にPRの数は2倍を超えて増えています。量が2倍で差し戻し率が以前の60%なら、差し戻しの絶対数はおよそ20%増える計算です。割合が下がったことは、それだけでは問題が減ったことを意味しません。絶対数も並べて見るべきです。
もう1つの注意点はコストです。Hacker Newsのコメントでは、Anthropicが複数のエージェントによるトークンを大量に使うレビューをまかなえるのは、社内でトークン(AIモデルがテキストを処理する単位)を潤沢に使えるからだと指摘されました。モデルを自社で持っているため、1件のPRに対してモデルを何十回も呼び出せます。外部の顧客がClaude Code Reviewに支払う額は、レビュー1回あたり平均$15 ~ $25です。一般的な企業や個人の開発者にとって、この費用は規模が大きくなると正当化しにくくなるかもしれません。
人の手に残るもの
こうした仕組みのどれも、エンジニアを工程から外すものではありません。エンジニアの役割は、機械が苦手とする判断へと移ります。システムのアーキテクチャ、根拠の見極め、そもそもその機能を作るべきかどうかの判断、そして最も重要なコードのレビューです。
Anthropicの責任のルールは「You land it, you own it」、つまりマージした人がそのコードに責任を持つというものです。変更をマージしたエンジニアは、それが本番環境で壊れたときにデバッグして直す責任を負います。テレメトリー(本番環境でソフトウェアがどう動いているかを示す自動収集のデータ)、素早い差し戻し、フィーチャーフラグが、その責任を現実的なものにしています。AIはコードを書いてレビューする時間を縮められますが、運用上の責任はすべてエンジニアに残ります。
チームで取り入れられること
中心となる考え方を使うのに、Anthropicほどの規模やトークンの予算は要りません。
- CLAUDE.mdは短く保つ。 繰り返し出てくるルールは、指示を長くし続けるのではなく、リンターと自動テストに移します。
- REVIEW.mdを書く。 ディレクトリごとに何が失敗にあたるのか、どのファイルを読み飛ばすのかをレビュー役に伝えます。
- レビューのループに上限を設ける。 エージェント同士のレビューは3ラウンドで止め、その後は新しい変更だけを確認し、バグの種類はまとめて一度に指摘します。
- 人の承認をリスクに結びつける。 リスクが高い変更、セキュリティ上の配慮が必要な変更、アーキテクチャにかかわる変更では、ボットの承認を人の承認として数えません。
- 差し戻しを両面から追う。 割合だけでなく絶対数も確認し、変更をマージした人にその責任を持たせます。
自動レビューを導入する前に、自分たちのPRの量で1件あたりいくらかかるかを見積もっておきましょう。手作業のレビューを減らす目的は時間を節約することであって、その時間を障害対応に移すことではありません。