AlphaFold 2がタンパク質構造予測を一変させてからおよそ5年がたちますが、タンパク質の折りたたみ問題は「解決済み」だという通説は、問題の大部分を見落としています。Google DeepMindのプッシュミート・コーリは、AlphaFoldが学習したのは、科学者がすでに決定してProtein Data Bank(PDB、実験で得たタンパク質構造の公開アーカイブ)に登録していた静的な構造の予測だったと強調します。生きた細胞の中でタンパク質が実際にどう動き、形と形の間をどう移り変わるのかは、いまだにほとんどわかっていません。そこから生物学を本当に理解するAIへ進むには、計算資源とデータを増やすだけでは足りないと、コーリとChan Zuckerberg Biohub(CZ Biohub)の研究者は主張します。適切なデータを選ぶこと、科学的知識をどこまでモデルに組み込むかを決めること、そしてモデルの出力をいつ信頼できるかを見極めることも欠かせません。
AlphaFoldが実際に解いた問題
タンパク質構造予測は完了したと宣言する見出しがたびたび掲げられてきました。しかし、現場の構造生物学者や生物物理学者の見方は異なります。彼らにとって、タンパク質のダイナミクス、タンパク質がとり得るさまざまな形(コンフォメーション状態)、タンパク質の機能、そしてまったく新しいタンパク質をゼロから作るde novo設計は、いまも大部分が未解決の問題です。
コーリによれば、科学のブレークスルーは通常、複雑なシステムから単純化した一つの側面を切り出し、進歩を測定・再現できるようにすることで生まれます。AlphaFoldが切り出した側面は、結晶化したタンパク質の静的な座標としてPDBに蓄積されたデータでした。そうしたスナップショットの予測は、創薬や生物学の研究で実際に大きく役立ってきました。しかし、静止画を予測することと、タンパク質が時間とともにどう振る舞うかを理解することは別物です。
- タンパク質は硬い積み木ではありません。細胞内の条件によって形が変わる柔軟な分子です。
- 決まった形をまったく持たない天然変性領域を含むタンパク質も数多くあります。
- さまざまな生体環境でタンパク質が実際にどのような構造の幅をとるのかは、研究者もモデルもまだ把握していません。
そのためコーリは、根底にある生物物理学はもう解決済みだという誤った思い込みから、構造研究やダイナミクス研究への支援を引き揚げないよう、資金提供者と科学者に警告しています。彼の見方では、生物学はまだ表面をなぞり始めたにすぎません。
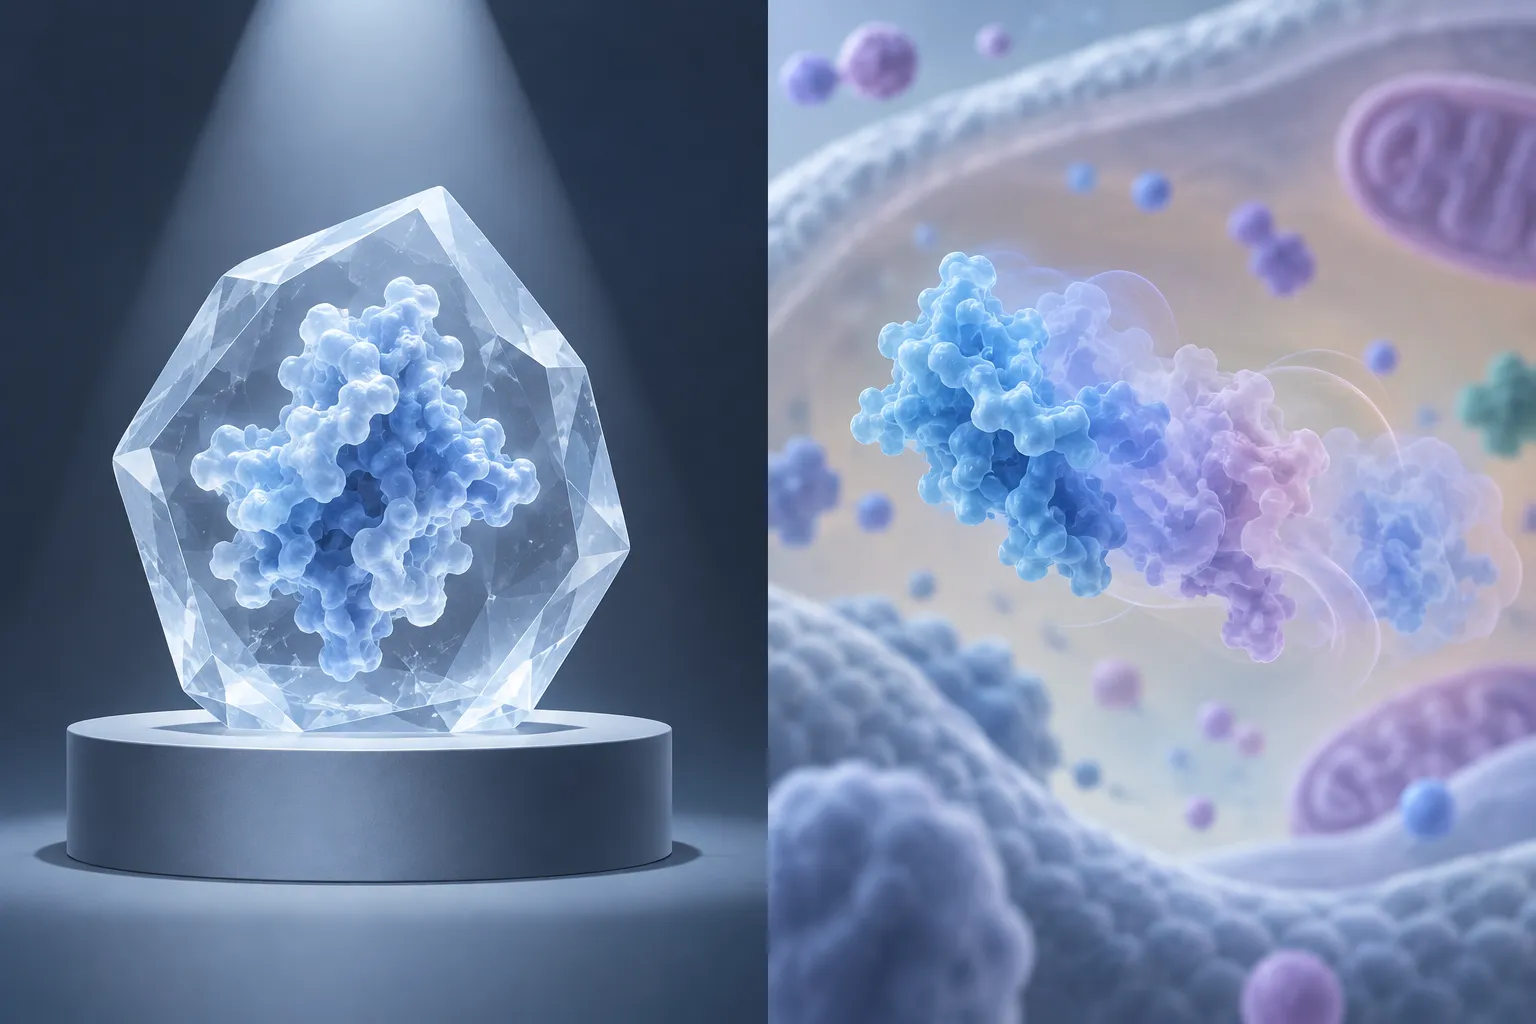
▲ 静的構造と動くタンパク質
生物学でも規模がすべてを制するのか
AI研究者はよく、リッチ・サットンのエッセイ「The Bitter Lesson」を引用します。計算資源とともにスケールする汎用的な手法が、最終的には人間が設計したルールに基づく手法を上回るという主張です。そこで当然、生物学のデータにも同じような法則が当てはまるのかという疑問が生まれます。
CZ Biohubの研究者は、モデル、データ、計算量を増やすほど着実に性能が上がるというスケーリング則が、どの分野にも自動的に現れると考えることに注意を促します。実際の研究の多くは、スケーリングが効き始める具体的なモデル設計とデータの条件を見つける作業です。その領域が見つかってはじめて、モデルの改善は管理可能なエンジニアリングのパイプラインになります。適切なデータ分布を持つことは、あらゆるモデルが汎化するための前提条件だと彼は言います。
示唆に富む例がタンパク質言語モデルです。研究者は、きれいに整った全長のタンパク質配列だけで学習させるのではなく、断片的で不完全なメタゲノム配列、つまり環境中の混合微生物サンプルから集めた遺伝情報を大量に投入しました。雑多なデータだったにもかかわらず、新しいタンパク質を設計するモデルの能力は大きく向上しました。逆の落とし穴もあります。生成しやすいからという理由で合成データや価値の低いデータを積み上げると、行き止まりに陥りかねません。また、モデルを作る側は、問題に本当に必要なデータは何かを問わずに、すでに公開されているデータセットをそのまま使いがちだとも指摘しています。
サットンがこのエッセイをテーマに社内講演をしていた時期にDeepMindにいたコーリは、この教訓を別の形で読み解きます。データに関する狭い主張というより、教条主義への警告だというのです。自分をモデルを作る人、あるいは実験データを作る人のどちらか一方だとだけ位置づける研究者は、科学的な意味の乏しいベンチマークでアルゴリズムを調整することに終始してしまいます。手法が問題を選ぶのではなく、問題が手法を選ぶべきだということです。
| プロジェクト | データの状況 | 選択 |
|---|---|---|
| AlphaFold | 実験で得る構造を10倍に増やすことは不可能だった | 既存のPDB構造で学習 |
| 単一細胞生物学と「仮想細胞」 | 公開リポジトリのデータが根本的に不足していた | 新たな生物学データの生成に資源を振り向けた |
人間の知識をどこまでモデルに入れるべきか
AlphaFoldのような初期のブレークスルーとなったシステムには、ほぼすべての構成要素に手間をかけた手作りの設計が盛り込まれていました。機械学習全体の流れは、大量の計算資源とデータに支えられた汎用的な手法へと移っています。この二つの方法のバランスについて、2人の科学者の見方は少し異なります。
コーリは第一原理から、生物物理学や生化学の知識を組み込んだのは決して偶然ではなかったと主張します。アミノ酸残基が物理的にどう影響し合うかを理解していれば、その理解を帰納バイアス、つまりモデルのアーキテクチャにあらかじめ組み込む仮定として表現できます。そうすればモデルは基本的な物理をゼロから学び直す必要がなくなり、データ効率の面で「アンフェアなほどの優位」を得られます。さらに彼は、データセットを厳選すること自体が一つの技芸だと付け加えます。同じデータを量だけ増やしても得るものは少なく、進歩はデータの多様性と網羅性にかかっているというのです。
CZ Biohubの研究者は、データが少ないときに帰納バイアスが不可欠だという点には同意しつつ、転換点があると指摘します。データセットが大きくなると、モデルは科学者が予想もしなかった複雑なパターンを見つけられるようになります。誤った仮定や硬直しすぎた仮定は、その発見を妨げ、性能に上限を設けてしまうおそれがあります。また彼は、スケールさせることを頭を使わない作業とみなす考えにも反対します。生物学の基盤モデルを安定してスケールさせるには、標準的なTransformerを生物学的な構造に合わせ、効率よく動くように改良することも含め、高度なアルゴリズムとシステムのエンジニアリングが必要だというのです。
次のデータフロンティア:cryo-EMの生画像
タンパク質のダイナミクス研究を前進させる鍵について、コンピュータビジョンの経験を持つコーリは、クライオ電子顕微鏡法(cryo-EM)で得られる未処理の顕微鏡画像を挙げます。cryo-EMは、凍結した分子を電子線で撮影する手法です。現在のモデルは、タンパク質ごとに処理済みのPDB構造一つから学習しています。多様な状態を含むcryo-EMの生画像で直接学習させれば、タンパク質がとる形の全体像と、その間の遷移をモデルがとらえられる可能性があります。
CZ Biohubの研究者は、現在の静的構造予測ツールは構造に基づく設計のような作業では非常に役立つものの、生物学のごく薄い一断面しか扱っていないと付け加えます。彼はそれを、自転車の車輪のスポーク1本を精密にモデル化するようなものだとたとえます。生物学者が最終的に必要としているのは、自転車全体、さらにはピックアップトラックのように複雑なものまで設計・評価できるモデルだというのです。
リチャード・ファインマンの「作れないものは理解していない」という言葉も、ここで新たな意味を帯びます。AIシステムは今や、誰もその仕組みを十分に理解しないうちに、機能するタンパク質の設計を生み出せるからです。
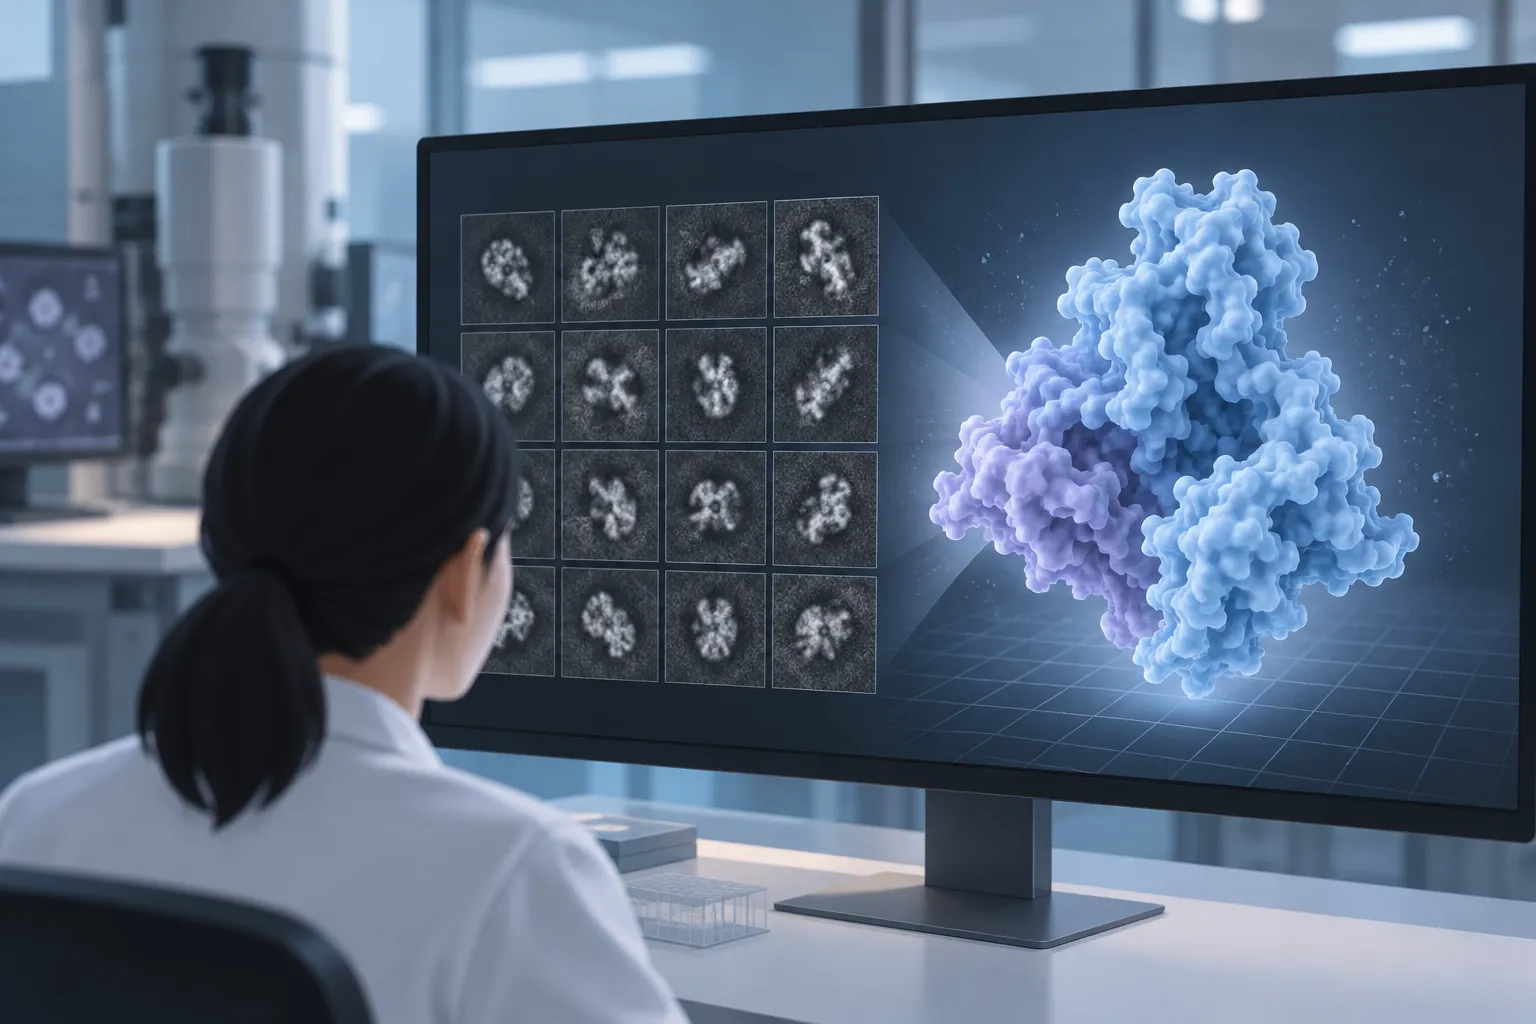
▲ cryo-EMの生画像から学ぶ
ブラックボックスで十分か
非常に強く結合するタンパク質を一度で設計できるモデルがあったとしたら、その仕組みを誰も知らなくても構わないのでしょうか。CZ Biohubの研究者は、バイオエンジニアは現代のAIが登場するずっと前からブラックボックス型の設計手法を使ってきたと指摘します。それでも、モデルから本当の理解を引き出すことは重要だと主張します。タンパク質言語モデルは、もっともらしい配列を生成するだけではありません。構造上の制約、物理的なダイナミクス、進化の情報を取り込んでおり、内部表現を分析すると、機能部位や形の変化が表れていることがわかっています。彼はこうしたモデルを、研究者がまだ解読していない情報を抱えた、進化を圧縮した世界モデルだと表現します。
コーリは解釈可能性を二つに分けます。モデル内部の仕組みを説明することと、モデルの振る舞い、つまりどこでうまく機能しどこで失敗するのかを明らかにすることです。彼が重視するのは後者で、その例としてAlphaFold 2を挙げます。
- AlphaFold 2は最初の公開時、予測構造が実際の構造にどれだけ近いかを測るGlobal Distance Test(GDT)で約90を記録しました。
- 仮に95を記録するモデルがあっても、予測ごとの信頼度スコアであるpLDDTが較正されていなければ、危険で使い物になりません。
- 信頼度の較正がずれていると、研究室は自信満々だが誤った予測を追いかけて、数カ月から1年を費やすことになりかねません。
- AlphaFold 2は信頼度がよく較正されていたため、科学者はそれを信頼でき、研究コミュニティは後に、天然変性領域の特定という想定外の使い道を見いだしました。
コーリはまた、解釈可能性は誰が解釈するのかにも左右されると示唆します。人間のワーキングメモリには限りがあり、多くのスケールが絡み合う生物学は、人間にとって直感的な説明を拒むかもしれません。彼は、将来のフロンティアAIモデルが専門モデルの内部の層を調べ、人間には届かないメカニズムの仮説を立てる可能性にも触れています。2人の科学者はともに、モデルの能力と限界を十分に把握することが、実験資源を誤った方向に投じないために不可欠だという点で一致しています。
臨床まではどれほど遠いのか
コーリは、AIがいつ臨床成績を変えるのかと問うこと自体がやや的外れだと考えています。AIと機械学習は、すでに前臨床段階の創薬のあらゆる段階で使われているからです。彼が区別するのは、現在の漸進的な活用と、標的探索、リード化合物の最適化、毒性評価を10倍から100倍速くする変化です。そうした飛躍は、既存の限られたアッセイを最適化することからではなく、包括的な基盤モデルによって細胞生物学や疾患メカニズムの根本的な問題を解くことから生まれると彼は主張します。
CZ Biohubの研究者は、Googleで学んだエンジニアリングの教訓を引き合いに出します。10%の改善を追うより10倍の改善を目指すほうが、取り組みやすく影響も大きいことが多いというものです。10倍を目指すと、誤った前提を捨て、問題を第一原理から考え直さざるを得なくなるからです。CZ Biohubが掲げる目標は人間の病気の治療、予防、管理に貢献することであり、そのためには短期的な実用上の成果と長期的な飛躍の両立が必要だと彼は言います。
これらは研究のパイプラインの変化であり、個人の診断や治療のためのツールではありません。健康に関する判断は医療専門家に委ねるべきです。
まとめ
AlphaFoldが解いたのは、タンパク質生物学の一つの側面、つまり静的な構造の予測です。動き、機能、そして細胞全体を理解する取り組みは始まったばかりです。生物学AIに取り組む研究者やエンジニアにとって、ここまでの論点は実践的なチェックリストになります。
- アーキテクチャを選ぶ前に、生物学上の問いと具体的なマイルストーンを定めます。
- 進歩に必要なのが計算資源なのか、モデルの容量なのか、新しい実験データなのかを早い段階で見極め、見込みの薄い方向はすぐに手放します。
- データは量よりも多様性と網羅性を重視し、メタゲノム配列のような雑多な自然データも試します。
- データが少ないときは物理の知識をモデルに組み込み、データが増えてきたら硬直した仮定を見直します。
- 研究室でモデルを信頼する前に、信頼度スコアが実際の精度と一致しているかを確認し、モデルが失敗する場面を把握します。
- 静的な構造アーカイブだけでなく、cryo-EMのような一次実験データにも目を向けます。