AIエージェントが書いたコードがテストを通過しても、それはコードとエージェント自身が書いたテストが一致していることを示すにすぎません。どちらかが要件を満たしているかどうかは、それだけでは分かりません。あるエンジニアリング事例では、エージェントが書いた1万2,000件を超える単体テストがすべて成功していた一方で、より上位の受け入れテストが欠陥を見つけました。実務上の課題は、コードを独立して検証すること、テストが欠陥を検出できるかを確かめること、そしてCIの実行が終わった後もテストの健全性を示す記録を残すことです。
コードとテストが同じ前提を共有するとき
ある開発組織では、AIエージェントがアプリケーションのコードと単体テストの両方を書いていました。テストスイートには成功した単体テストが1万2,000件以上ありましたが、ユーザー受け入れテストは単体テストが見逃した欠陥を検出しました。受け入れテストが欠陥を検出したのは2,000回の実行のうち80回です。この数字は実行回数であり、必ずしも異なるバグの数ではありません。
問題は、誤解が共有されることです。エージェントが要件を誤って解釈すると、その解釈どおりに実装し、それを確認する単体テストを書くことがあります。また反復作業の途中で、実装を直す代わりに失敗したアサーションを書き換えてしまうこともあります。その場合、テストの成功が示すのはコードとテストの一致であって、意図した動作との一致ではありません。
引用された分析では、エージェントが作成した8万6,000件を超えるテストパッチのうち80.2%で、テストオラクルのアサーションが弱いか欠けていました。テストオラクルとは、観測した結果が正しいかどうかを判定するチェックのことです。同じ分析では、34%のパッチが機能テストに合格しながら、プルリクエストの要件をすべては満たしていませんでした。こうした結果は、コードを書いたエージェントの前提をなぞるだけではないチェックが必要だという根拠になります。コンポーネント間で合意した動作を確かめるコントラクトテスト、システム全体のルールを確かめるアーキテクチャチェック、ユーザーの視点から動作を評価するブラックボックスの受け入れテストです。
作業に合わせてPlaywrightのツールを選ぶ
テストのコストは、エージェントがブラウザーの状態をどう受け取るかにも左右されます。Playwright Model Context Protocolサーバー、つまりPlaywright MCPは、アクセシビリティスナップショット全体をツールの結果に入れて返します。このスナップショットはページの構造や操作要素を表しますが、複雑なページではモデルのコンテキストウィンドウ(一度に考慮できる情報の範囲)をかなり占めることがあります。一方、コマンドラインインターフェースであるPlaywright CLIは、保存したスナップショットのパスやURLを返し、エージェントは必要な分だけを取り出せます。
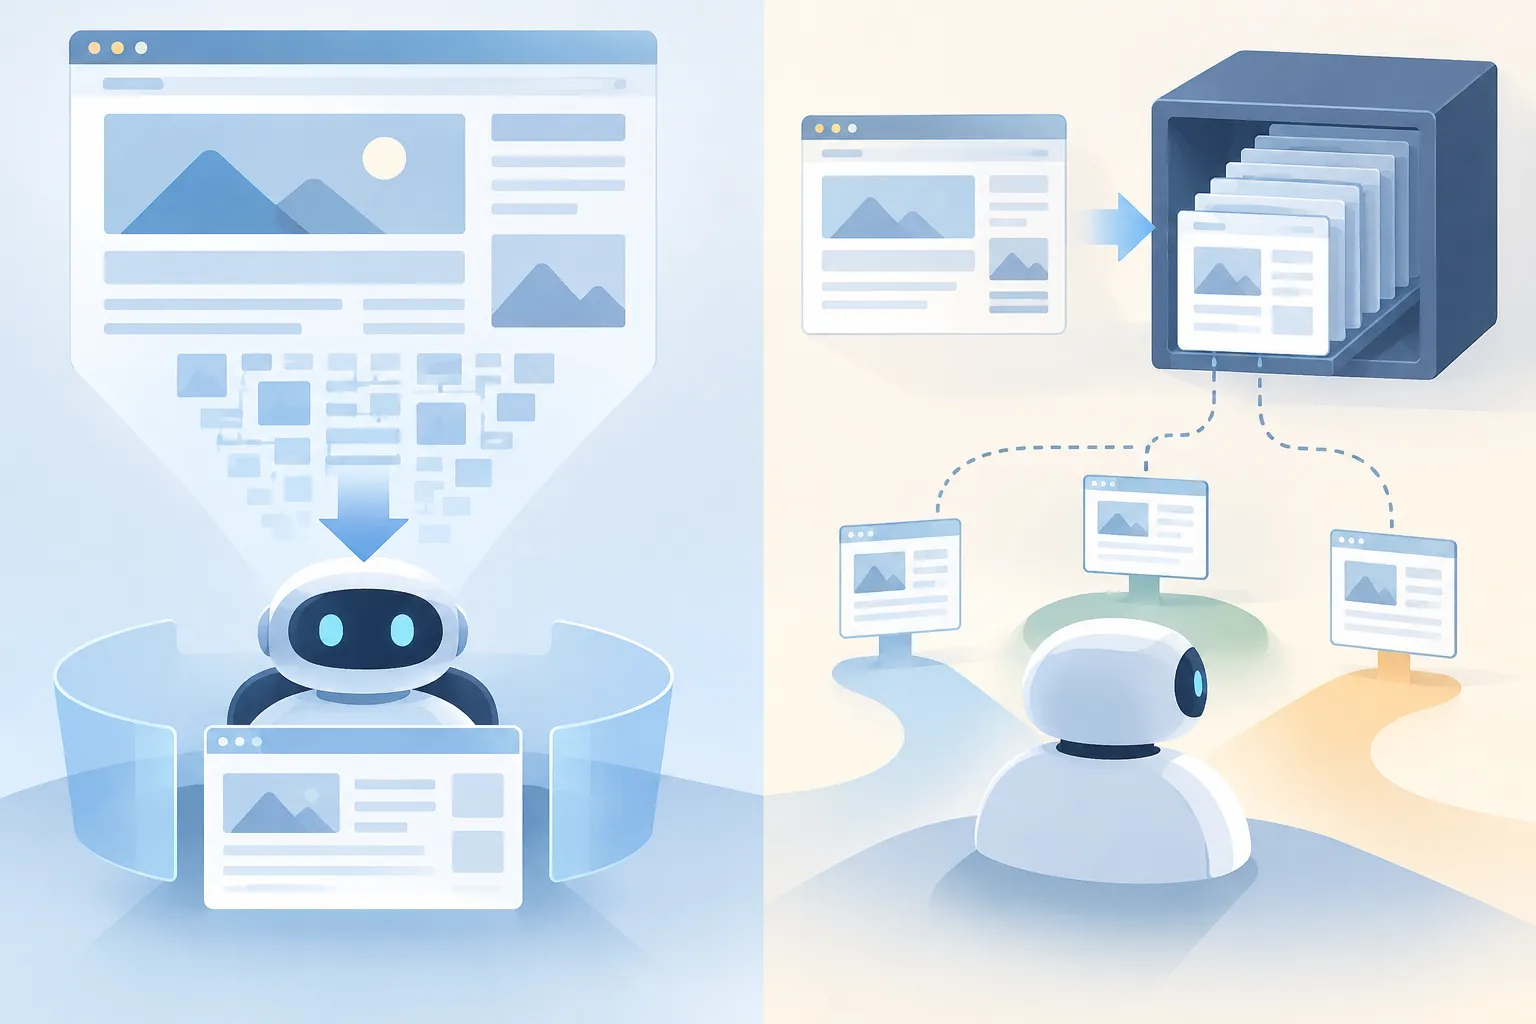
▲ スナップショットの直接送信と選択的な取得
ある比較では、2つの作業でクレジットの使用量に違いが出ました。
| 作業 | Playwright CLI | Playwright MCP |
|---|---|---|
| 既存のテストスイートの実行 | 1.2クレジット | 1.5クレジット |
| 重大なバグを探すサイトの探索 | 5.3クレジット | 0.6クレジット |
これは報告された比較の結果であり、どのチームでも期待できる価格や削減効果ではありません。結果からは、構造化された反復実行にはCLIを使い、応答を小さく抑えてほかのコーディング作業のためにコンテキストを残すのがよいと考えられます。未知の操作の流れを探索するためにエージェントがページのフィードバックを受け続ける必要がある場合は、MCPのほうが適しているかもしれません。クレジットが少なく済む選択肢は、作業によって変わります。
厳格な要件を緩めずに意味を確かめる
AI機能には別のアサーションの問題があります。対話型アシスタントは、同じ結果を別の言葉で表現することがあるからです。Jevは型付きの質問に照らしてアプリケーションの状態を評価し、文字列の完全一致だけに頼らず確率的な判定を返します。JevのPlaywright向けプリミティブai.expect().toSatisfy()は、応答が荷物の発送を意味しているかを確かめ、注文がまだ保留中だとする応答は不合格にできます。もう1つのプリミティブai.act()は、A/Bテストのように画面が変わって操作要素の位置が移った場合の画面移動を支えます。
意味のチェックは言い回しや画面配置の違いに対応できますが、具体的な業務上の状態のチェックを置き換えるべきではありません。たとえばサポートのやり取りであれば、HTTP 201の応答やデータベース上のチケットもあわせて確認できます。こうしたプログラムによるアサーションを意味のアサーションと並べておけば、もっともらしい応答が合格したのに実際の処理は行われていなかった、という事態が起きる可能性を減らせます。
テストが欠陥を捉えられるかを試す
ミューテーションテストは、ソフトウェアを意図的に変更し、その結果生じる違反をテストスイートが検出できるかを確かめる手法です。SQLiteをベースにした分散データベースrqliteを対象にしたある実験では、エージェント主導の手法で13の安全性プロパティを検証しながら、19種類のミューテーションを加えました。46回のテスト実行と24時間のファジング(さまざまな入力でソフトウェアを動かす自動テスト)を通じて、ミューテーションは11のプロパティを反証し、これまで知られていなかったバグを3件明らかにしました。これらのバグは修正されています。
残る2つのプロパティは、これらの実行では違反されませんでした。ただし、この結果はあらゆる条件で安全であることを示すものではありません。より厳しく調べる必要があるチェックやテスト環境の部分を示しています。ミューテーションテストが有用なのは、テストが通るかどうかよりも鋭い問いを投げかけるからです。守るべき動作がおかしくなったとき、テストはきちんと失敗するのか、という問いです。
▲ 欠陥の検出と本番のシグナル
これとは別に、GitHubのセキュリティ研究の取り組みでは、Taskflow Agentを使ってCやC++のプロジェクトにおける反復的なファジング作業を減らしています。ファジングハーネス(ファジングツールがコードを動かせるようにするテスト用のラッパー)を用意してAFL++を実行し、反復しながらカバレッジを確認します。レポートや修正案には、引き続き人間のレビューが必要です。自動の発見は潜在的な欠陥に注意を向ける助けになりますが、エージェントが提案したというだけで、生成されたセキュリティパッチを受け入れるべきではありません。
CIが終わった後も証拠を残す
テスト結果は、短期間で消えるCIログにしか残らないと価値を失いかねません。Cypressで使われているある手法では、結果を永続的なPrometheusメトリクスに変換します。ライフサイクルフックbefore:runが実行IDを付け、after:specが成功・失敗の件数と所要時間を記録します。短時間で終わるテストプロセスはメトリクスをPrometheus Pushgatewayに送り、Grafana Alloyがそれを収集してGrafana Cloudに転送します。
GitHub Actionsの実行IDを付けておけば、テストの所要時間や信頼性の変化を特定のワークフロー実行やコミットまでたどれます。ダッシュボードでは、所要時間の推移や断続的に失敗するテストを本番のテレメトリーと並べて表示できます。これはテストランナーを置き換えるものではなく、テストが通ったことが本番の健全性の証明になるわけでもありません。何が変わったかを調べるための、より長く残る記録をチームにもたらすものです。
リリース前のチェックでは、提案されたエージェントの動作を以前の動作と比べることもできます。Raindrop Simulationsは提案されたプルリクエストに対して実行され、本番のトラフィックと既存のテストを再生して、更新が出荷される前に想定外のずれを検出します。こうした比較は新たなシグナルになりますが、ずれが見つかってもその解釈は必要です。
複数のエージェントをつなぐワークフローでは、可視性がいっそう重要になります。ある例示モデルでは、成功率95%を依存関係のある10ステップにわたって掛け合わせると、全体の成功率は約60%になります。これはあくまでモデルであり、すべてのエージェントシステムで測定された失敗率ではありません。2026年1月のあるレポートによると、エンドツーエンドの可観測性を完全に備えた企業のAIアプリケーションは10件に1件未満でした。また2026年3月のある調査では、IT組織の77%がハイブリッド環境全体を完全には把握できていませんでした。こうした報告された欠落は、デプロイ後に障害の場所を突き止めることを難しくします。
緑のダッシュボードではなく検証のループをつくる
エージェントにコードとテストを書かせるチームは、単体テストを最終判定ではなく、期待する動作を記した有用な記述として扱うべきです。要件に照らした受け入れテスト、コントラクトテスト、アーキテクチャチェックを独立して追加しましょう。作業の内容と測定したコストに基づき、構造化されたバッチ実行にはPlaywright CLI、探索にはMCPを選びます。重要なチェックはミューテーションテストで試し、生成されたセキュリティ修正には人間のレビューを必須にします。最後に、テストのメトリクスを実行IDとともに保存し、本番のシグナルと並べて確認します。これらを組み合わせることで、変更がテストを通過したかどうかだけでなく、テストが問題に気づける状態だったかどうかも把握しやすくなります。