OpenAIの新しいDecisions APIは、答えを文章で書きません。選ぶだけです。テキストや画像と一緒に答えの候補リストを送ると、約150ミリ秒で各選択肢の確率を返し、支払うべき出力トークンもありません。集中力を見張るタイマーから動画のラフカット編集まで、7つの実用的な制作例で試すと、高速で安価な分類器がチャットモデルに勝る場面と、力が及ばない場面がはっきり見えてきます。
判断モデルはチャットモデルとどう違うのか
一般的な言語モデルは、答えをトークン単位で1つずつ生成します。トークンとはモデルが読み書きする小さなテキストの単位で、トークンが増えるほど遅延もコストも増えます。Decisions APIは生成そのものを省きます。あらかじめ決めた選択肢の集合をモデルの1回の計算でスコア付けするため、出力トークンはゼロです。
カスタマーサポートの例を見ると仕組みがわかります。「I was charged twice for my order(注文で二重に請求された)」というメッセージを、Billing、Technical、Shipping、Otherの4つの選択肢と一緒に送ると、APIはBillingを確信度100%で返します。答えは常に、渡した選択肢のどれかです。
同じ仕組みで、オープンソースのファーストパーソン・シューティングゲームを人の操作なしにプレイするボットも動かせます。スクリーンショットと座標データを、移動の選択肢(前進、後退、横移動)と行動の選択肢(射撃、リロード、ジャンプ)に組み合わせ、ボットは1秒に何度もこの判断を下し、1回あたりのコストは1セントにも届きません。
OpenAI自身の数値で比べると、次のとおりです。
| 項目 | Decisions API | 通常のgpt-6-lunaの呼び出し |
|---|---|---|
| 標準的な応答時間 | 約150ミリ秒 | 約1.6秒 |
| 料金 | 入力100万トークンあたり$0.10 | 生成したトークンごとに課金 |
| 出力トークン | なし | あり |
出力トークン、キャッシュの読み込みと書き込みにも料金はかかりません。
先に登場したライバル
この方式を考え出したのはOpenAIではありません。元OpenAIの研究者が設立したTypeSafe AIが2026年9月15日にJevを発表し、初の公開「System One」モデルとして売り出しました。時間をかけた熟考ではなく、即時の分類と構造化された確率のために作られたモデルという意味です。初期のユーザーは、数千件のサポートメールの振り分けや、不動産物件を建築様式や高速道路への近さでタグ付けするといった大量の仕分け作業に使いました。
| 項目 | OpenAI Decisions API | TypeSafe AI Jev |
|---|---|---|
| 入力100万トークンあたりの料金 | $0.10 | $0.042 |
| 入力形式 | テキストと画像 | テキストのみ |
| 主な仕様 | スクリーンショットや写真を直接読み取る | リクエストのコンテキストは64kトークン |
Jevは半額以下ですが、画像を見ることができません。Decisions APIは画像やデスクトップのライブ画面キャプチャを受け付けるため、リアルタイムに画面を見て動くボットを実現できます。この画像入力への対応が、両者を分ける決定的な違いのようです。
準備
- OpenAIの開発者プラットフォームでAPIキーを作成します。APIの利用料金はChatGPTのサブスクリプションとは別に請求されます。
- コードを書かずに試すなら、同じプラットフォームのDecisions Playgroundで入力と選択肢のリストを試します。
- アプリを作るときは、Claude CodeやCodexといったコーディングエージェントに作りたいものを説明し、APIキーはローカルの.envファイルに置きます。
▲ 画面と音声入力の即時判断
7つの制作例とわかったこと
1. 作業から外れると気づく集中タイマー
25分のPomodoroタイマーに画面認識を加えたデスクトップアプリです。コーディングなどの目標を入力すると、アプリは数秒ごとに接続されたすべてのモニターをキャプチャし、画面がまだその目標に合っているかをDecisions APIに問い合わせます。1分以上作業から外れると、テキスト読み上げで注意します。Xで広告をスクロールすると、浮かんでいる球体がオレンジ色に変わり、コーディングに戻るよう音声で促しました。作業に戻ると元の大きさに縮みました。初心者向けの定番プロジェクトも、画像入力と即時の分類を得ると能動的な見張り役になります。
2. 遅延のないmacOS音声操作
プッシュ・トゥ・トークのキーを押しながら話すと、音声認識が命令をテキストに変えます。続いてDecisions APIが、アプリの起動や終了、アプリの切り替え、ブラウザーのタブやナビゲーションの操作といった行動のリストから1つを選びます。ClaudeがこのElectronアプリを約15分で作り、命令は約120~280ミリ秒で処理されました。右のOptionキーを押しながら「Open Arc」や「Open Google Chrome」と言うと、ほぼ瞬時にアプリが切り替わりました。
制作からは2つの教訓が得られました。行動を入れ子の多段階の階層にまとめていると、「quit Spotify」の確信度は67%にとどまりました。選択肢を1つの平らなリストにまとめ直すと、確信度も速度も戻りました。また、このアプリにはmacOSのシステム設定でアクセシビリティと入力監視の両方の権限を与える必要があります。
3. Xのフィードから広告と釣り投稿を除く
Chromeの拡張機能が各投稿のテキストと画像をDecisions APIに送り、広告や手抜きのエンゲージメント狙いの投稿かどうかを尋ね、該当する投稿を展開できる細いバーに折りたたみます。Claudeは約4分でこれを書き、模擬フィードでテストしました。最初は判定が過敏で、企業の製品発表や宣伝的な言い回しを使った普通の投稿まで隠していました。投稿の右上にある「Ad」ラベルを特に確認するようモデルに指示すると、この問題に対処できます。
4. 画面録画の個人情報を自動でぼかす
FFmpegが0.5秒ごとにフレームを取り出し、Decisions APIが各フレームにAPIキー、メールアドレス、電話番号、自宅住所などの個人情報があるかを確認し、ツールが特定した箇所をぼかします。偽のメールや秘密鍵を詰め込んだ1分間のテスト録画では、次の結果になりました。
| 項目 | 結果 |
|---|---|
| 確認したフレーム | 144 |
| 検出したフレーム | 84 |
| パイプライン全体の所要時間 | 15.8秒、実際の再生より約4.6倍速い |
| APIコスト | $0.0732 |
以前の方法、つまり動画ファイル全体をGeminiにアップロードして機密データを探すやり方は、遅くて手間もかかりました。
5. 速度とコストを測るWikipediaレース
Wikipediaレースでは、モデルが各ページで最も有望なリンクを選びながら、ある記事から遠く離れた目的の記事まで移動します。Decisions API、Jev、そして標準的なチャットモデルとしてのGPT-5.5の3者を並べて走らせました。
| ルート | Decisions API | Jev | GPT-5.5 |
|---|---|---|---|
| BananaからMoon landing | 3ホップ、2.9秒、$0.00327 | 3ホップ、7.3秒、$0.00272 | 2ホップ、8.9秒、$0.0944 |
| Taylor SwiftからPhotosynthesis | 3ホップ、1.2秒、$0.00242 | 3ホップ、2.0秒、$0.00179 | 3ホップ、16.3秒、$0.1277 |
| PokémonからRoman Empire | 6ホップ、3.1秒、$0.00268 | 5ホップ、2.1秒、$0.00136 | 2ホップ、14.2秒、$0.0678 |
チャットモデルの方が短い経路を見つけることもありましたが、判断専用のモデルは1ステップあたり多くの場合約10倍速く、コストはおよそ20~50分の1でした。
6. 写真1枚からカロリーを計算
ローカルのWi-Fi経由でiPhoneのSafariから開くモバイルWebアプリで、カメラのボタンが1つあるだけです。データは無料のUSDA FoodData Centralのリストから取り、Claudeが172カテゴリー、5,412品目に整理しました。設計の要は、モデルにカロリーを推論させないことです。Decisions APIは食品のカテゴリーと1人前の量という2つの限定された選択式の質問に答え、続く呼び出しで具体的な品目を絞り込みます。そのうえで、通常のコードがデータベースの標準重量表からカロリーを計算します。
チーズバーガーの写真は約1秒、$0.000054で488キロカロリーと判定されました。一方、ベーコンを巻いた£8の特大ブリトーは特大のブリトーと分類され、わずか964キロカロリーでした。小、中、大、特大といった固定の量の区分では、推論モデルなしにこうした極端な例を扱えません。
7. 撮影素材から失敗テイクを見つける
最後の制作例は、未編集の録画から言い間違い、言い出しの失敗、言い直し、無音部分を取り除くものです。Adobe Premiere Pro内でOpus 5.5を使って編集すると精度は約98%に達しましたが、動画1本あたり数百ドルのAPI料金がかかりました。そこで、最初の大まかな選別をDecisions APIに任せます。Whisper-1がタイムスタンプ付きで音声を書き起こし、書き起こしを文ごとに分け、各行を言い間違い、言い出しの失敗、言い直し、編集の合図、採用のいずれかに分類します。
| テスト | 結果 |
|---|---|
| 4分45秒の4Kクリップ | 40回の判断を1.3秒で実行、失敗テイク7か所をすべて検出、判断に$0.0029と書き起こしに$0.029 |
| 4.25GBの未編集ファイル | 音声の抽出0.2秒、書き起こし5.7秒、判断1.7秒、無音54か所と失敗テイク7か所を指摘 |
Whisper-1は、ローカルで動かしたMLX Whisperモデルより速く、言葉がつかえる箇所の単語単位のタイムスタンプも正確でした。確信度の低い行だけをOpusのような大きな推論モデルに回せば、段階的でコスト効率のよい編集の流れができます。Claudeが生成したブラウザー上の編集画面は雑然としてわかりにくいものでしたが、きちんと動きました。
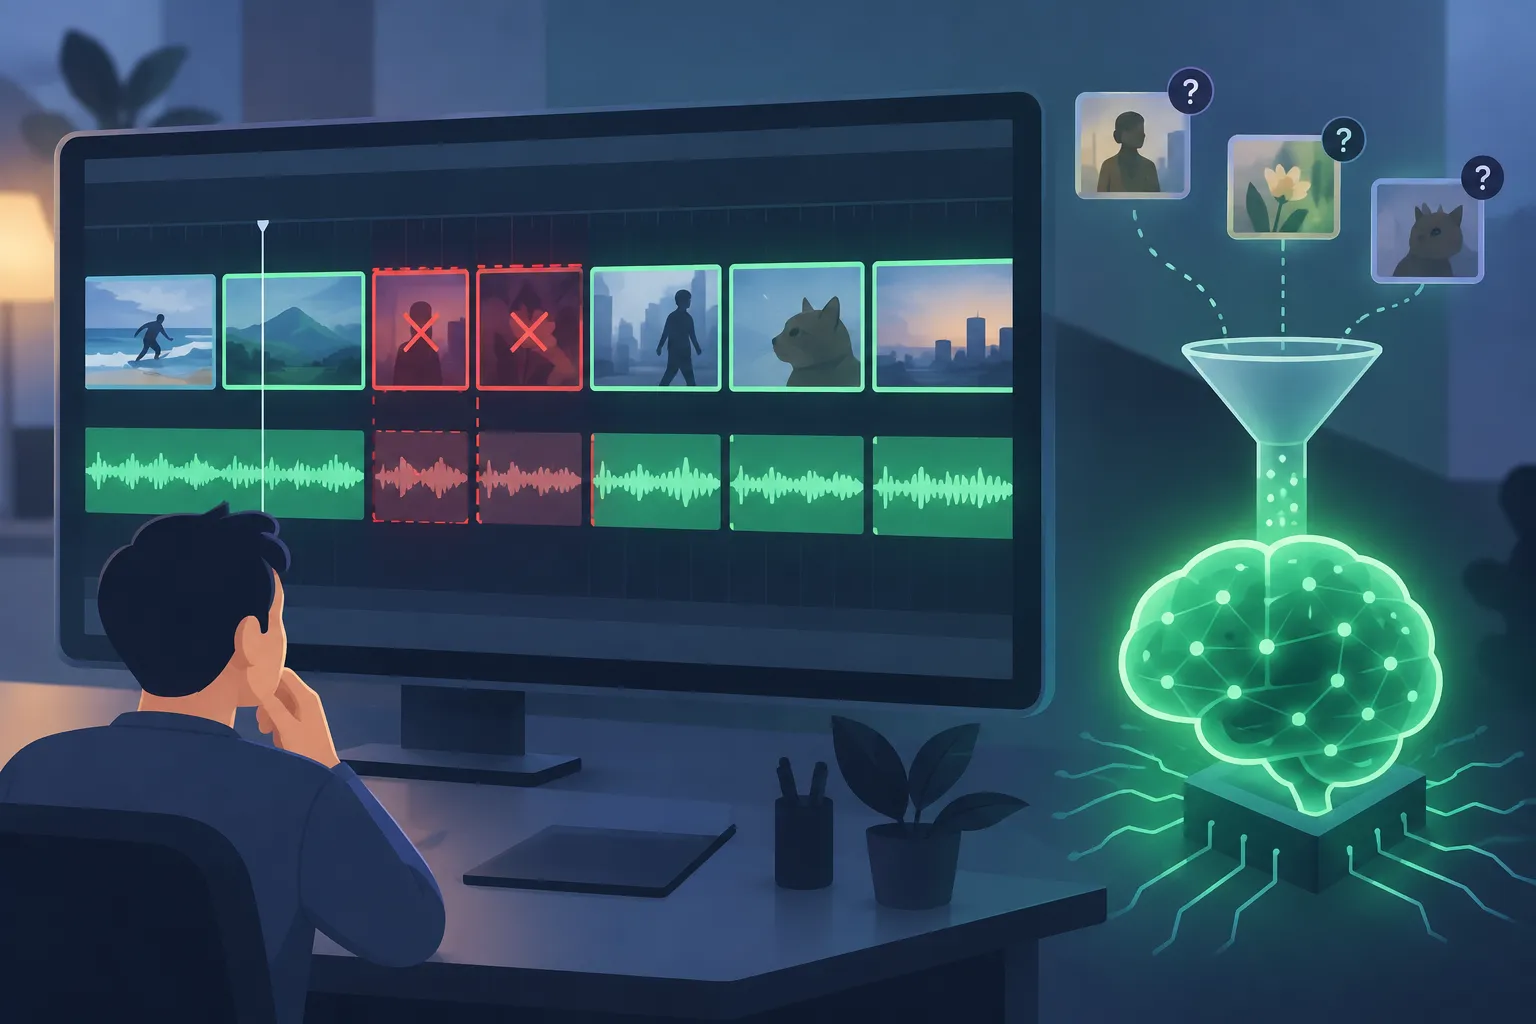
▲ 大型モデル前の安価な一次選別
頼る前に知っておきたい限界
- リストにないことはできません。ブラウザーに文字を入力する、対応する行動が決まっていないURLを開くといった音声命令は失敗しました。モデルは与えられた行動の中からしか選ばないためです。
- 複雑な例外の微妙なニュアンスは見落とします。そうした判断には、今も本格的な推論モデルが必要です。
- 入れ子の選択肢の木は確信度を下げます。1つの平らなリストの方がうまくいきます。
- 分類器は過敏になることがあります。その場合は「Ad」ラベルの例のように、探すべき具体的な手がかりをプロンプトに書きます。
- 固定の区分は極端な値で破綻します。特大ブリトーがその例です。
どこから始めるか
Decisions APIは、範囲の決まった選択を高速かつ安価に何度も繰り返す作業に向いています。画面や写真に映ったものに反応するリアルタイムのツール、テキストや動画フレームの大量の仕分け、高価なモデルの前段に置く安価な一次選別がその例です。試すなら、次の手順が理にかなっています。
- 答えがいくつかの決まったカテゴリーに収まる業務を1つ選び、Decisions Playgroundで選択肢のリストとして試します。
- 選択肢は入れ子の木にせず、1つの平らなリストにまとめます。
- モデルにはカテゴリーを選ばせ、カロリーや価格などの数値は参照表とコードに出させます。
- 確信度のしきい値を決め、それを下回る項目だけを大きな推論モデルに送ります。
- 画像入力が必要ならDecisions APIを使い、テキストのみの大量分類でコストを最も重視するならJevと比較します。