Claude CodeとCodexはAIモデルではありません。モデルを包み込み、ファイルを読み、コマンドを実行し、作業内容を記憶し、自分の結果を確認できるようにするソフトウェアの層、つまりハーネスです。この違いは見た目以上に重要です。同じモデルを異なる2つのハーネスに載せると、まったく同じタスクでも結果が大きく変わることがあります。この半年ほどのコーディングやエージェントのベンチマークでの大きな伸びの多くも、基盤モデルが賢くなったことよりハーネスの改良によるものとみられます。仕事でAIツールを選んだり設定したり頼ったりしているなら、パッケージに書かれたモデル名と同じくらいハーネスにも目を向ける価値があります。
モデル単体ではできないこと
大規模言語モデルは、単体ではテキスト予測器にすぎません。テキストを受け取り、次に来る可能性が最も高いトークン(モデルが読み書きするテキストの小さな単位)を予測します。膨大なテキストで学習したモデルは、「The sky is」の次には「pterodactyl」よりも「blue」が来る可能性が圧倒的に高いことを学びます。この能力は強力ですが、素のモデルには4つの明確な限界があります。
| 限界 | 素のモデルの状態 |
|---|---|
| 記憶がない | 新しいチャットは毎回白紙から始まり、以前のセッションを知らない |
| 見えない | 誰かが貼り付けない限り、画面やファイル、フォルダーを見られない |
| 行動できない | コードを実行できず、人がすべきことを説明できるだけ |
| 確認できない | 提案したコードが実際に動くかを試す手段がない |
よく使われるたとえが「瓶の中の脳」です。大きな知能を持ちながら、話すことも世界に働きかけることもできません。鞍も手綱もない力強い野生の馬にたとえることもできます。その出力は見事なものと奇妙なものの間を揺れ動きます。ハーネスは、その力を目標に向けるための鞍と手綱にあたります。
実務上の意味は、よくできたハーネスなら平均的なモデルやワンランク下のモデルでも驚くほど良い結果を出せる一方、トップクラスのモデルでも出来の悪いハーネスに閉じ込められると力を発揮できないことがある、という点です。最も単純なハーネスは、多くの人がすでに使っているチャット画面です。しかし実際の仕事には、はるかに作り込まれたものが必要です。
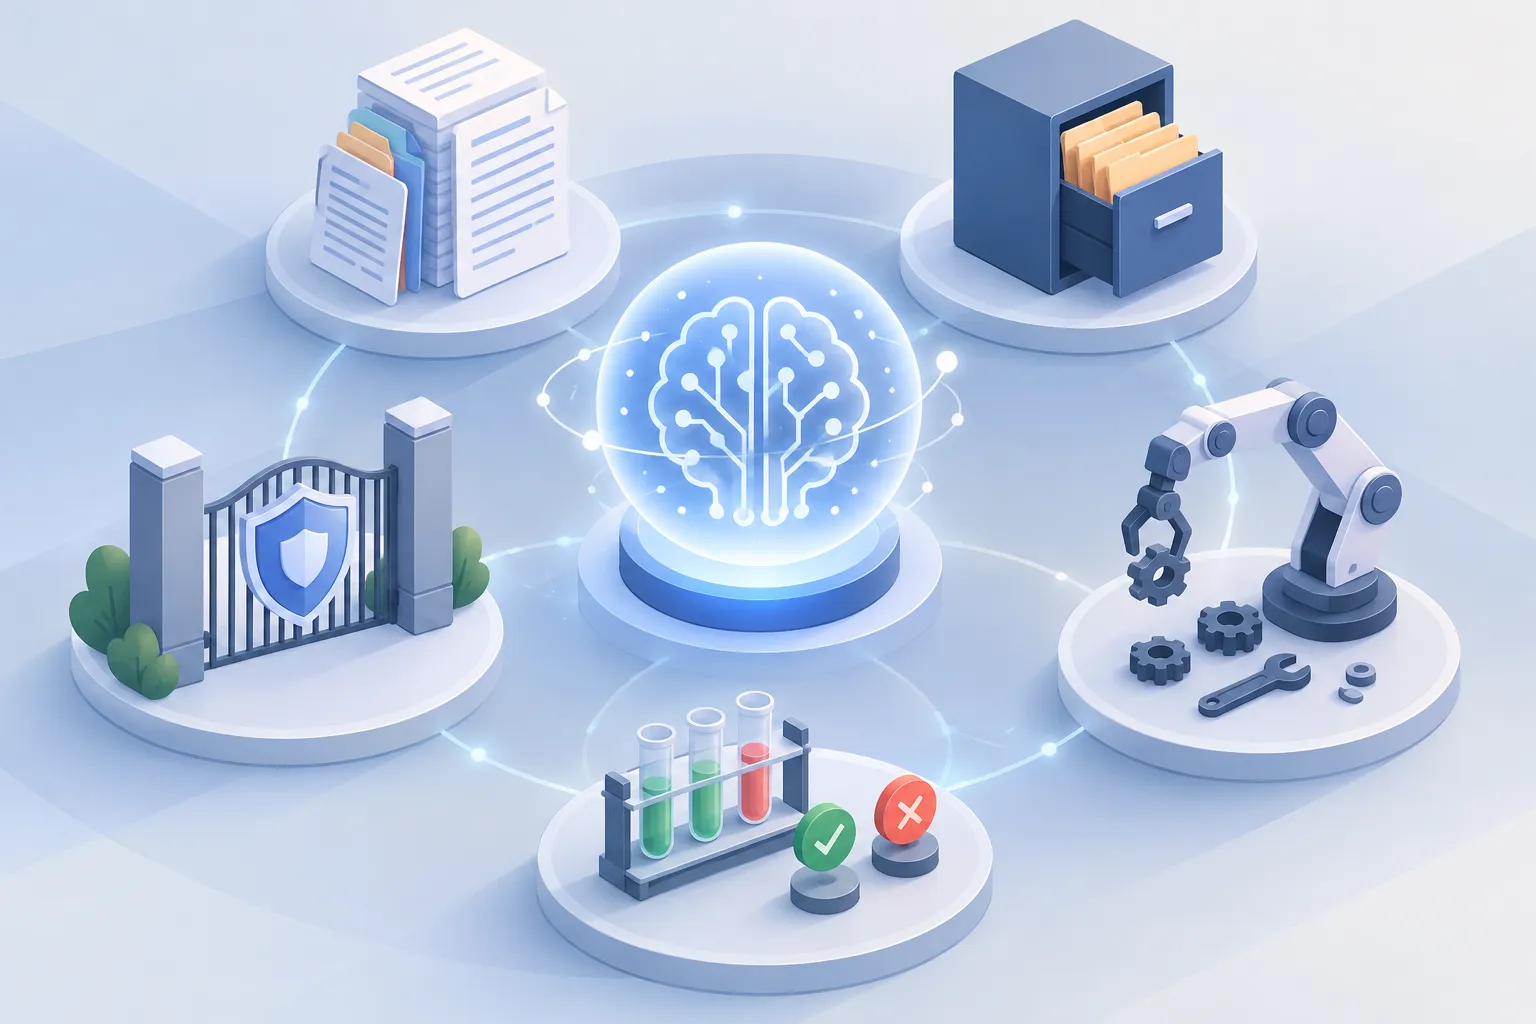
▲ AIハーネスを構成する5つの要素
現代のハーネスを支える5つの要素
現代のハーネスは5つの構成要素で成り立っています。
- コンテキストは、モデルに何をなぜしているのかを伝えます。
- 記憶は、長いセッションを通して作業を引き継ぎます。
- ツールは、ファイルの編集やプログラムの実行など、モデルに実際の行動をさせます。
- 検証は、作業が成功したかを自動で確かめます。
- 権限は、安全のためのガードレールと停止条件を定めます。
コンテキスト:開始時にモデルが知っていること
どのセッションも、ユーザーやその事業、プロジェクトについて何も知らないモデルから始まります。素のモデルに「hello」と入力しても、名前で挨拶したりプロジェクトの進み具合を尋ねたりはできません。ハーネスは、プロジェクトの概要、ファイル構成、最近の変更、使えるツールを含む見えない最初のプロンプトをひそかに差し込むことで、この問題を解決します。
Claude CodeとCodexでは、こうしたコンテキストの多くがCLAUDE.mdやAGENTS.mdといったプロジェクトのルールファイルから来ます。これらのMarkdownファイルには「自社のコードスタイルに従う」「このフォルダーは編集しない」「必ずテストを実行する」といった内容を書けます。ハーネスが起動のたびに自動で読み込むため、同じ指示をプロンプトのたびに繰り返す必要がなくなります。auth.ts、cart.ts、api.tsのようなファイルの索引であるコードマップを加えると、モデルはリポジトリ全体を探し回らずに必要なファイルへ直接たどり着けます。
記憶:長いセッションを軌道に乗せ続ける
セッションが進むにつれ、コンテキストウィンドウ(モデルが一度に考慮できるテキストの量)は会話や指示、ツールの出力で埋まっていきます。このウィンドウの大きさはハーネスではなくモデルの特性です。本20~50冊分に相当する数百万トークンがたまると、矛盾する指示が積み重なり、モデルの性能は目に見えて落ちます。
ハーネスはこれをコンパクション、つまり長い履歴を簡潔な要約に凝縮する処理で解決します。コンパクションでは、最も重要なもの、すなわち当初の目標、全体の計画、変更したファイルの一覧を残します。途中の手順は短い要約ブロックにまとめ、失敗した試みやかさばるエラーの記録は削除して空きを作ります。Claude Codeはトークンの上限に近づくと、この処理を自動で実行します。
現代のハーネスは、編集のたびにファイル全体の写しを保存することも避けます。代わりに、Gitのバージョン管理のように、編集内容そのものを記録した軽量な変更ログを残します。これにより、エージェントはコンテキストを重複したテキストで埋め尽くすことなく、以前の状態を再現できます。
ツール:テキストを行動に変える
モデルが出力するのはテキストだけなので、ハーネスは特定の構造化テキストを行動の要求として認識するパーサーでモデルを包みます。モデルがそうした要求を出すと、ハーネスはそれを受け止め、ファイルの読み込み、ファイル検索、プログラムの実行、コードの編集といったツール定義と照らし合わせて実行し、結果を返します。要求は厳格なスキーマ(決まった形式)に従うため、パラメーターは常に有効で、そのまま実行できます。
目立つ改善は2つあります。1つ目に、モデルはファイル全体を書き直すのではなく、変更が必要な行だけを書き換えるようになり、トークン消費と構文エラーが減りました。2つ目に、Anthropicが作りOpenAIも使っているオープン標準のModel Context Protocol(MCP)が、エージェントを外部ソフトウェアにつなぐ共通の方法になりました。MCPサーバーを使えば、モデルをSlack、GitHub、カレンダー、データベース、デザインツールにつなげます。自社の内部ツールやデータベース向けのMCPサーバーを、コーディングエージェントに作らせることもできます。
検証:モデルの自己評価を信用しない
自分の出力が正しく見えるかをモデルに尋ねると、ほぼ必ず「はい」と答えます。モデルには計算機能も基本的な妥当性チェックも組み込まれていないため、誤った答えを出してそれを擁護することがあります。17×3を尋ねると48と答え、正しいと言い張るかもしれません。外部の計算ツールを使って初めて51と確定します。
そのため優れたハーネスは、モデルの出力を管理された環境で実行し、実際の結果をプロンプトに戻します。主な役割を担うのは3種類の自動チェックです。
その合図は終了コードのように単純なことも多く、0なら成功、それ以外はエラーを意味します。このフィードバックを受けて、モデルは実際に起きたことに基づいて自ら修正できます。
権限:ガードレール、フック、サンドボックス
安全の層は、すべてのツール呼び出しと呼び出しの連なりを実行前に検査します。ファイルの編集のような無害な操作は自動で通ります。ファイルの削除、保存した作業の削除、システム設定の変更、未知のサイトへのデータ送信といった危険な操作はブロックされるか、ユーザーの明示的な承認が必要になります。おなじみの「これを許可しますか?」という確認はここから来ています。エージェントがプロジェクトのデータを怪しい未確認のドメインに送ろうとしたとき、それを止めるのも権限の層です。
フックは、決まったタイミングで自動的に発動するルールを加えます。「編集のたびにテストを実行する」「このコマンドは決して許可しない」といったものです。たとえばECサイトの開発者なら、コードを変更するたびにパフォーマンステストを実行してページの読み込み速度を守れます。実行前のガードで、新しい外部向けリクエストを、プロジェクトが過去2週間に接続したドメインと照合することもできます。
サンドボックス(仮想コンテナのような隔離された環境)は最後の防衛線です。大量のファイル削除、ファイルの上書き、システム設定の変更といった問題が起きても、被害は内部にとどまります。ハーネスは実行時間、メモリ使用量、インターネット接続にも上限を設けます。たとえばCodexは、タスクごとに新しい隔離されたクラウド環境を立ち上げます。サンドボックスが防ぐのは事故だけではありません。有能なモデルが効率を追い求めて、外部データのダウンロードや自らの重みの持ち出しといった取るべきでない近道を選ぶ、ミスアラインメントも抑えます。
新たに出てきているのが、2つ目の専用AIモデルをゲートキーパーとして使い、主モデルの行動を審査させるパターンです。有望な考え方ですが、慎重な調整が必要とみられ、現在の権限チェックの大半はまだ手続き的なものです。
各要素の連携:ReActループ
これら5つの要素は、1つの繰り返しサイクルの中で動きます。自律型エージェントの標準的なパターンが、Reason(推論)とAct(行動)を組み合わせたReActループです。
- 考える:モデルがコンテキストを見て次の手順を決めます。
- 行動する:具体的な行動、通常は構造化されたツール呼び出しを要求します。
- 権限:ハーネスがその行動が許可されるか、人の承認が必要かを確認します。
- 実行する:承認された行動をサンドボックス内で実行します。
- 削る:肥大化したログや無関係な出力を削り、コンテキストの空きを確保します。
- 読む:エージェントが削った結果を確認し、何がなぜ起きたかを把握します。
ループは目標を達成するまで繰り返され、終わるとエージェントが何を変更したかを報告します。
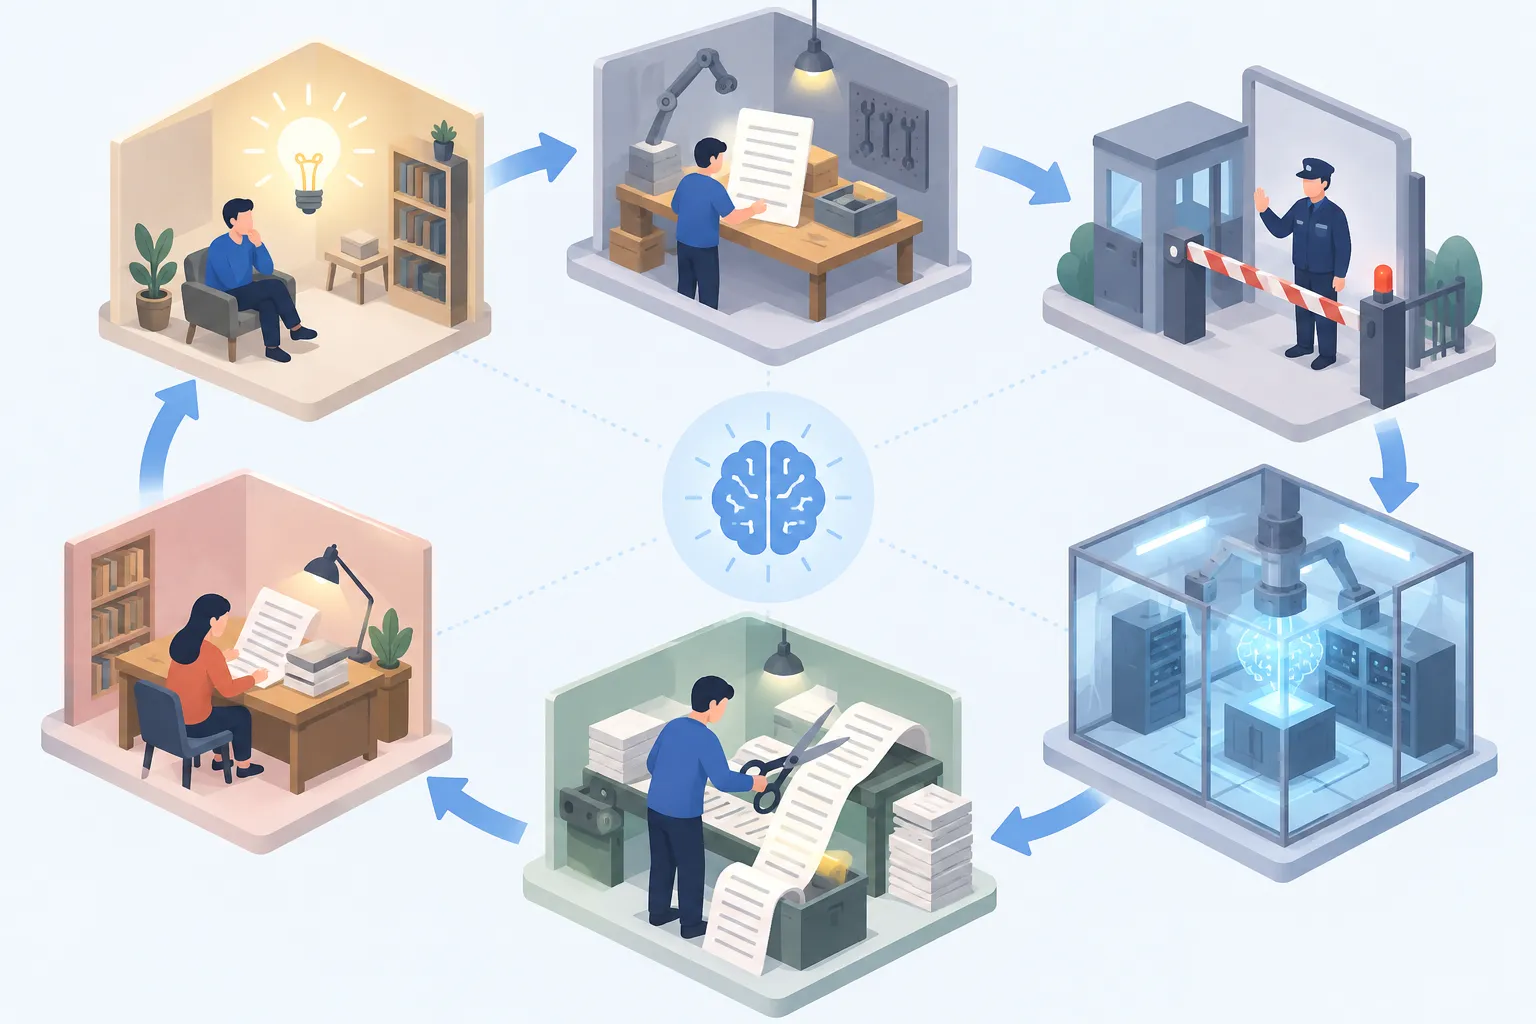
▲ AIエージェントを動かすReActループ
ハーネスは考える段階にも関わります。推論型のハーネスは、ツール呼び出しや回答の前に、モデルに予備的な推論を書かせてそれを戻します。開発者は、その最初の推論の後に「but」「however」「yet」といった語を付け加えることで、モデルに自らの前提の欠陥や例外を探させ、自分自身に異を唱えさせることができます。そのうえでハーネスは、モデルの出力を内部の思考、ツールの要求、ユーザーへのメッセージの3つの経路に振り分けます。
ハーネスが変えるもの、変えないもの
ハーネスはモデルを賢くはしません。はるかに役立つものにします。これはベンチマークのニュースを読む際の有効な視点でもあり、スコアが急に上がったときは、ハーネスの功績が大きいかもしれません。また、数千基のGPUでフロンティアモデルを学習させるのとは違い、ハーネスの構築は通常のソフトウェア開発であり、個人の開発者にも開かれています。
次の世代を形づくりそうな方向は4つあります。
- MCPの普及:カレンダー、メール、ファイルシステムを含む、より多くのアプリがMCPを通じてエージェントとつながります。
- エージェントのチーム:計画、構築、レビュー、テストを別々のエージェントが担い、エージェント同士で通信し、コンテキストを共有します。
- 並列の試行:1つのタスクをたとえば3つのサンドボックスで同時に実行し、2つが失敗して1つが合格すれば、検証がその1つを選びます。
- 自ら改善するハーネス:ハーネスが過去のミスや失敗したツール呼び出しを分析し、自らのルールを書き換えます。たとえば、ディレクトリ全体を読み込んでトークンを浪費するエージェントを見つけて「まず検索する」ルールを課せば、トークン使用量を約10分の1に減らせます。
今やるべきこと
AIツールを比べるときは、モデル名だけでなく、どのハーネスで動いているかを確かめましょう。Claude CodeやCodexを使っているなら、いくつかの変更で大きな差が出ます。
- プロジェクトのルートにCLAUDE.mdまたはAGENTS.mdを置き、コードスタイル、テストコマンド、エージェントが触れてはいけないフォルダーを書きます。
- モデルに「これで合っている?」と尋ねるのはやめ、出力をテスト、リンター、フォーマッターに通します。
- 編集のたびにテストを実行するフックを追加し、削除やシステムの変更には承認を必須にします。
- 信頼できないエージェントの作業は、時間とメモリの上限を設けたサンドボックスで実行します。
- 内部ツールをつなぐ必要があるなら、そのためのMCPサーバーをエージェントに作らせます。
AIからより多くを引き出すのに、新しいモデルは必要ありません。ハーネスの5つの要素を引き締めるだけで、手元のモデルからはるかに多くを引き出せます。