AIエージェントと検索拡張生成(RAG)、つまり検索で取得した資料をモデルの応答用コンテキストに加える手法は、回答だけを見てもわからないほど多くの場所へ機密データを運びます。ある文書は検索ストア、プロンプト、モデルの作業コンテキスト、接続されたツールへと移動しながら、最終的な回答には一切現れないことがあります。そのため、セキュリティ上の最初の問いは、AIシステムが何を答えたかだけではなく、データがどこから来てどこへ行ったかです。
回答を評価する前にデータを追う
AIのワークフローは、いくつもの地点で社外秘の資料を取り込みます。学習データセットに社内記録やソースコードが含まれている場合があります。利用者は、モデルに送る指示であるプロンプトに機密情報の断片を入力することがあります。システム指示やポリシー文書も、すべての利用者に見せる想定ではない社内情報をコンテキストとして与えることがあります。RAGは社内ドキュメント、スプレッドシート、データベースから資料を取り出し、モデルが応答の生成に使うコンテキストに加えます。AIエージェント、つまりモデルを使ってツールを選び呼び出すシステムは、データベースへの問い合わせ、コードの実行、外部サービスの呼び出しを行えます。1つのエージェントが別のエージェントを次々に起動することもあります。
経路ごとに、確認すべき露出の問いは異なります。従業員が機密資料を未承認のチャットボットに貼り付け、それがモデルの学習に使われる可能性はないか。検索システムが、アクセスを制限すべきファイルをアプリケーションから利用できる状態にしていないか。エージェントが情報を別のツールやエージェントに渡していないか。社内で無許可に導入されたAI、いわゆるシャドーAIは、既存の審査や統制をすり抜ける場合にさらなる課題となります。ある調査では、31%の組織がAIインシデントに直接関連するデータプライバシー侵害を経験していました。
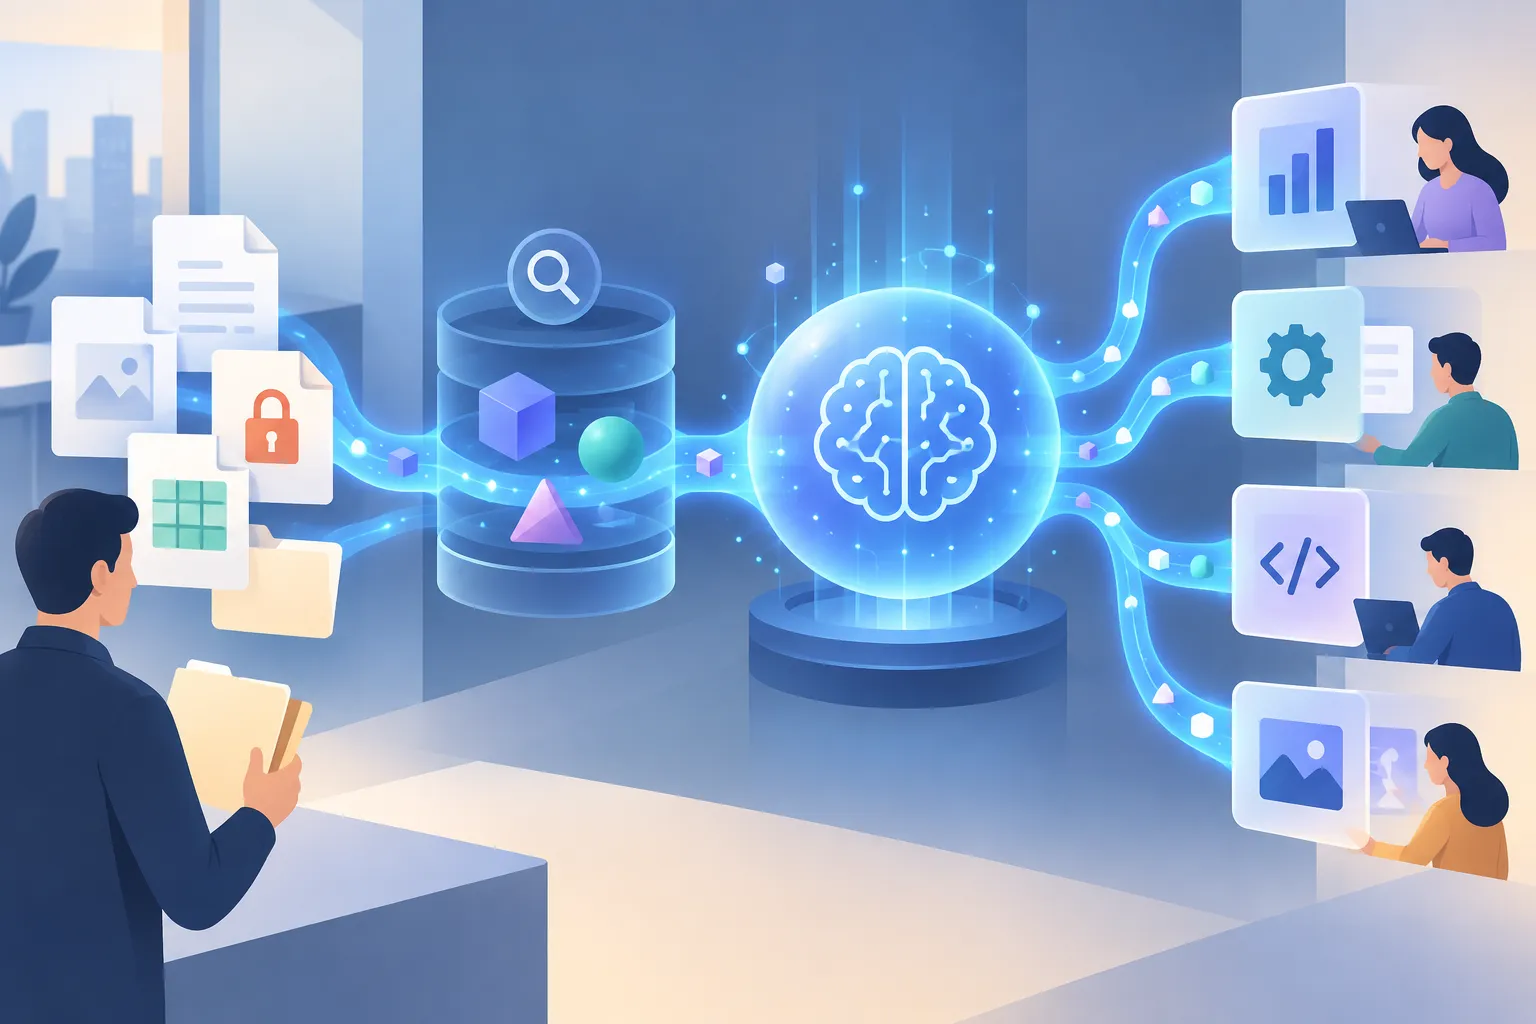
▲ 検索とツールをまたぐデータの連続性
従来のデータ損失防止(DLP)ツールは、ファイルや一般的なネットワーク通信に含まれる機密情報を監視します。しかし、元のテキストがベクトルデータベースに保存される数値表現であるエンベディングに変わるときや、データがエージェントの連続した処理を通って移動するときの動きは見落とす可能性があります。使われているAIアプリケーションを見つけるだけでは、どの機密記録がそこに届き、その後どうなったのかはわかりません。
可視化に向けた2つの流れ
実務的な点検では、アプリケーションやデータ処理システムを指すAIワークロードと、それらのシステムを使う従業員を指すワークフォースを分けて考えます。どちらにも、監視、追跡、そして結果をわかりやすく示す仕組みが必要です。
| 流れ | 監視 | 追跡 | 提示 |
|---|---|---|---|
| ワークロード | AIアプリケーション、RAGの取り込み処理、ベクトルデータベース | 元テキストからベクトルへの変化とその後の転送 | 出所、変換、到達先のマップ |
| ワークフォース | AIアプリケーションに関わるアップロードとダウンロード | コピー&ペーストの操作と、元ファイルと派生ファイルの関係 | 従業員によるAI出力の利用と共有の状況 |
ワークロードについては、RAGの取り込み処理、AIアプリケーション、ベクトルストアを1つの流れのつながった部分として点検します。元文書を、変換後の表現や下流の到達先と結び付けます。ワークフォースについては、信頼できるファイルとAIアプリケーションの間の移動を観察します。機密性の高い元ファイルから誰かが新しい文書を作った場合は、元ファイルの分類を見失わないよう、親子関係を保持します。
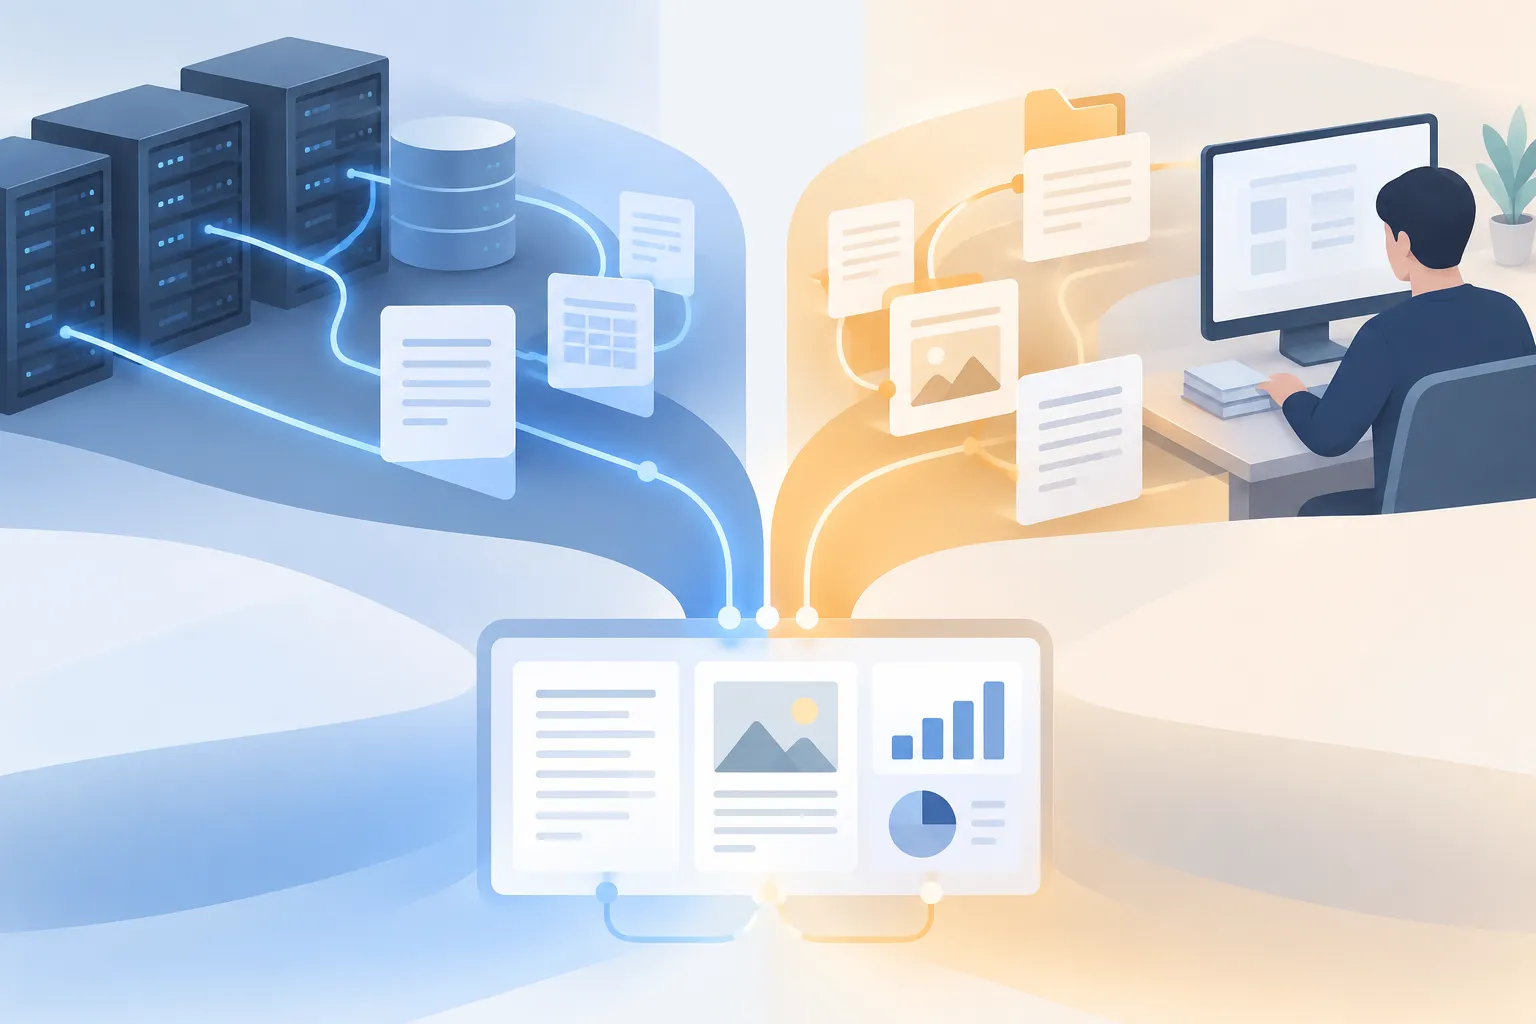
▲ システムと従業員の利用を合わせた監視
どちらの流れも、それだけでは完結しません。エージェントの検出では、モデル、プロンプト、呼び出されたツールを特定できても、元になったファイルの機密度はわかりません。エンドポイントDLPは従業員の端末上の操作を把握できても、RAGパイプライン全体は見えないことがあります。クラウドとオンプレミスのデータ検出はリポジトリを分類できますが、その後データをAIシステムに持ち込む操作を見逃す可能性があります。目指すべきは、これらの視点をつなぐことであり、1つのダッシュボードを全体像として扱うことではありません。
調査でつなぐべきもの
データリネージ、つまり情報がどこで生まれ、どう変わり、どこにたどり着いたかの記録を統合して見られるようにすると、互いに関連する3つの機能を支えられます。
- 継続的な検出と分類: 対象となるソース全体で、個人を特定できる情報、保護対象の医療情報、財務データ、知的財産を識別します。
- エンドツーエンドの追跡: 検索、ベクトル表現への変換、モデルでの利用、エージェントのツール、派生ファイルを通じてつながりを保持します。
- 状況を踏まえた調査: 利用者の役割、データの機密度、転送先を突き合わせ、露出の可能性を評価します。
システムをまたぐポリシーの適用と共通のコンソールは、これらの機能をまとめる助けになります。状況を踏まえた調査を自動化すれば、分析にかかる時間を数週間から数分に短縮できます。同じデータフローの証拠に基づく報告は、EU AI Act、GDPR、SOC 2、HIPAA、ISO 27001に関連する対応を支えることができます。
まずはデータの流れを図にする
学習データセット、プロンプト、検索用リポジトリ、システム指示に入る機密情報を洗い出します。次に、それぞれの入力を、それを扱うアプリケーション、従業員、エージェントのツールと結び付け、最終的な回答だけでなく変換と到達先も記録します。既存のエージェント、エンドポイント、リポジトリ向けのツールが統合された視点を提供し、一貫したポリシーを適用できるかを確認します。出所から到達先までたどれる経路があれば、セキュリティチームはAIの利用を続けながら露出を見つける足がかりを得られます。