プルリクエストの段階で待ち構えるセキュリティレビューは、AIエージェントのスピードに追いつけなくなっています。アイデアが1〜2週間で本番環境に届き、エンジニアリング部門以外の社員まで自分で社内ツールを公開する今、マージの関門でコードを確認するのでは遅すぎ、時間もかかりすぎます。SpaceXとxAIのあるセキュリティエンジニアは、別のモデルを提案しています。セキュリティチームが会社のポリシーを、エージェントがコードを書きながら取り込めるコンテキストとしてまとめて渡すという考え方です。主な手段は、AIエージェントを外部のツールやデータにつなぐオープン標準であるModel Context Protocol(MCP)のサーバーと、コーディングツールのフックです。そしてその土台として、従来の予防的な統制がこれまで以上に重要になります。
プルリクエストの関門が機能しなくなった理由
従来のソフトウェア開発ライフサイクルは決まった順序で進んでいました。製品要求仕様書と設計書を書き、コードを書き、プルリクエスト(PR)を出し、同僚の承認を待ち、自動テストを実行し、ステージング環境にデプロイし、品質保証を経て、ようやくリリースするという流れです。この12〜18か月の間に、コーディング向けに作られた大規模言語モデルがこのタイムラインを崩しました。開発者は今、チャットやエージェントの画面の中でコードを生成し、デバッグし、リファクタリングしており、複数のモデルセッションを同時に動かすことも珍しくありません。アイデアから動くプロトタイプ、本番環境までの道のりは数か月から1〜2週間、ときには数日に縮まりました。長いステージングの代わりに実際のユーザーからのフィードバックを検証の手段とする企業もあります。
より大きな変化はエンジニアリング部門の外で起きています。採用部門などの社員は、もはやエンジニアにツール作成を依頼するチケットを出しません。AIモデルにプロンプトを与えてツールを書かせ、自分でホストします。こうしたツールはエンジニアリングチームを一度も通らないため、静的解析、セキュリティレビュー、標準的なテストをすべて素通りします。
セキュリティチームが追いつけない理由は数字に表れています。
| 要因 | 一般的な水準 |
|---|---|
| セキュリティエンジニアとソフトウェアエンジニアの比率 | 約1対100 |
| 1人の開発者が並行して動かすエージェント | 4〜5個(リポジトリやタスクごとに1つ) |
| PR段階のセキュリティスキャン1回あたりの遅延 | 5〜10分 |
| コードを生成する非エンジニア | 1社あたり数百〜数千人 |
静的アプリケーションセキュリティテスト(SAST)と、オープンソースの依存関係を調べるソフトウェア構成分析(SCA)は、PRごとに数分の待ち時間を生みます。これが5つの並行エージェントの分だけ積み重なると、チェックはボトルネックになります。一部のコーディングツールでは、エージェントがレビューコメントを読み、修正を書いて自ら再プッシュできるため、ばかげたループが起きることもあります。レビューボットが欠陥を指摘し、別のエージェントがパッチをプッシュし、両者がコメントの応酬を続けるのです。この見方では、セキュリティ検証はもっと早い段階、つまりコードが生成されている最中に行うのが適切です。
セキュリティルールをエージェントの作業フローに組み込む
AIエージェントを禁止してもうまくいきません。セキュリティチームはむしろ、作り手がすでに働いている場所に出向き、会社のポリシー、安全なコーディングパターン、そして「舗装道路(paved road)」、つまり事前に承認された、最初から安全な作り方を、エージェントが直接読める形に変える必要があります。
特に有効な方法は2つあります。
- エージェント型エディタのフック。 Cursorなどのコーディングツールはフックに対応しています。フックとは、決まったタイミングで自動的に実行されるユーザー定義の処理です。セキュリティチームはここにガードレールを仕込み、エージェントが作業しながら会社のルールを確認するようにできます。
- セキュリティチームが運営するMCPサーバー。 エージェントや開発者が、目の前のタスクに合ったセキュリティガイダンスをサーバーに問い合わせます。たとえばサーバーレスのクラウドインフラを構築するためのルールです。返ってきたポリシーはモデルのコンテキストウィンドウ、つまり現在のタスクで参照する作業記憶に入るため、次に書くコードが会社の要件に沿うようになります。
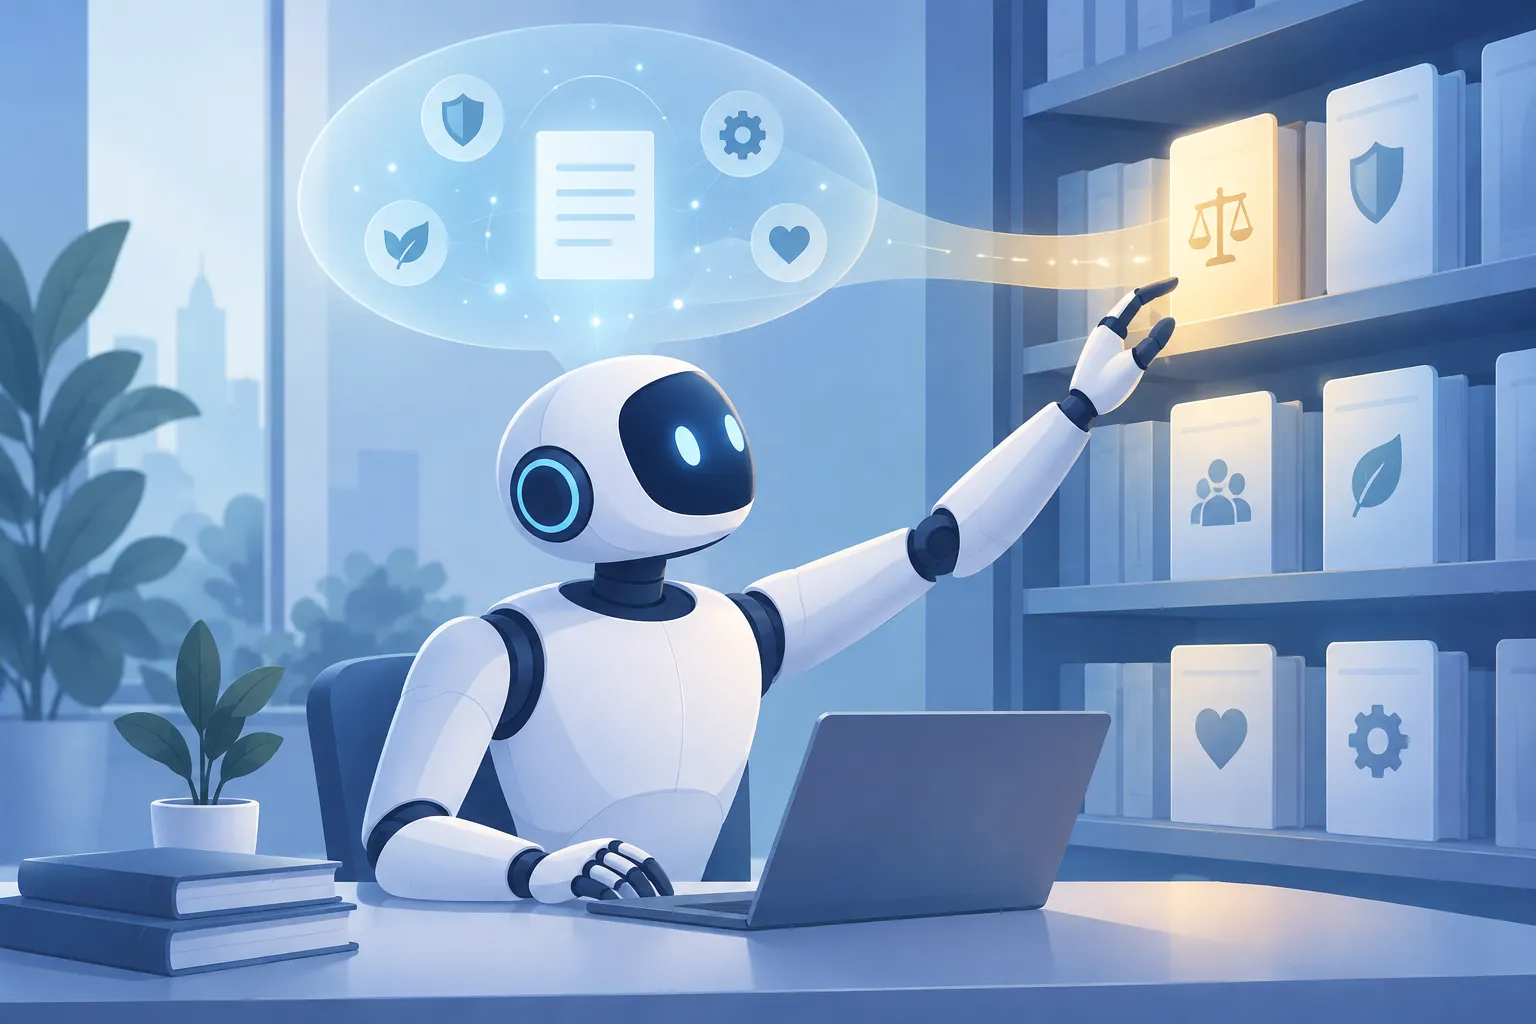
▲ セキュリティポリシーを照会するエージェント
舗装道路という考え方は変わりませんが、届け方が変わります。静的なドキュメントやコピー&ペースト用のテンプレートに代わり、エージェントが関数呼び出し(function calling)、つまりモデルが構造化された形式で外部の関数を呼び出す仕組みを通じて使えるAPIエンドポイントとツール定義が中心になります。ガイドラインを呼び出せる形にしておけば、誰かがポリシーのWikiを探し回らなくても、エージェントが自ら調べて準拠を保てます。
シフトレフトがようやく現実的に
開発の早い段階でセキュリティの問題を見つける「シフトレフト」は、常に人の限界に縛られてきました。開発者は疲れ、文脈が足りず、締め切りに追われていたからです。エージェントにはそうした限界がありません。大量のリントルールを取り込み、バックグラウンドでセキュリティチェックを走らせ、見つかった問題を修正できます。たとえばTerraform向けのエディタのリンターが、公開状態のAmazon S3バケットや範囲の広すぎる信頼ポリシーを検出すれば、エージェントはその場で修正できます。ローカルのリンター、承認済みライブラリの一覧、組織のポリシールールをエージェントに渡しておけば、PRが作られる前に自分の作業を整えられます。
新しいAIセキュリティツールより基本の統制が先
よくある失敗は、新しい「AIセキュリティ」製品を追いかけて予防的な統制をおろそかにすることです。この言葉自体の定義もまだあいまいで、10人の実務者に聞けば10通りの答えが返ってくるかもしれません。AWSのService Control Policies(SCP)、GCPの組織ポリシー、リソース制御ポリシーといったクラウドのガードレールは、エージェントが上書きできない確かな制限です。実行時のサンドボックス化、ネットワーク分離、OSレベルの分離も役立ちますが、IDとアクセスの管理やクラウドの境界の代わりにはなりません。
権限も同じくらい重要です。過剰な権限を持つエージェントが本番データベースを丸ごと削除したという報告もあります。レビューなしで本番環境にコードやインフラの変更を直接プッシュできる書き込み権限をエージェントに与えるのは、避けるべきパターンです。更新や削除など状態を変えるあらゆる操作には、監査証跡と人間による明示的な承認が必要です。
もう一つの柱は説明責任です。メールを読んだりSlackのメッセージを送ったりする個人の「相棒」型エージェントは、ユーザーに代わって動くため、責任はそのユーザーにあります。一方、クラウドで監督なしに動く自律型エージェントには、そもそも責任を問えません。IBMの古い原則にあるとおり、機械は責任を負えないので、経営上の判断を下すべきではありません。そのため自律型エージェントには、IDの面とネットワークの面の両方で厳しく絞り込んだアクセスと、明示的に定義された機能が必要です。
エージェントと操作の種類に合わせて統制を変える
エージェントは大きく2つのグループに分かれ、さらにブラウザで動く3つ目の種類があります。
| エージェントの種類 | 役割 | 主な統制 |
|---|---|---|
| コーディングエージェント | リポジトリ、ビルド、デプロイパイプライン、社内インフラを扱う | 変更への人間の承認、隔離された実行環境 |
| Q&Aエージェント | 呼び出した人のIDで社内データを照会し、回答をまとめる | 既存のIDの仕組み、セキュリティ用MCPサーバー、OpenTelemetryのログ |
| ブラウザエージェント | ユーザーに代わってWeb上の作業をこなす | IslandやChrome Enterpriseなど管理された企業向けブラウザの中だけで動かす |
より役に立つ区別は、操作の種類かもしれません。公開状態のS3バケットを探すような読み取り専用の照会は、認可の境界が守られていれば、チャット型とコーディング型のどちらのエージェントが実行してもリスクは同程度です。作成、更新、削除の操作ははるかにリスクが高く、綿密な監視と人間の関与が求められます。テレメトリーを収集するオープンソースの標準であるOpenTelemetryを使えば、どのエージェントがいつ、どのツール、エンドポイント、データ資産に触れたかを記録できます。
MCPサーバーは通常のAPIを包んだものなので、ネットワークやAPIゲートウェイの層で管理できます。組織がネットワーク上で特定のサービスのAPIをブロックすれば、そのAPIに依存するMCPサーバーは単に動かなくなります。
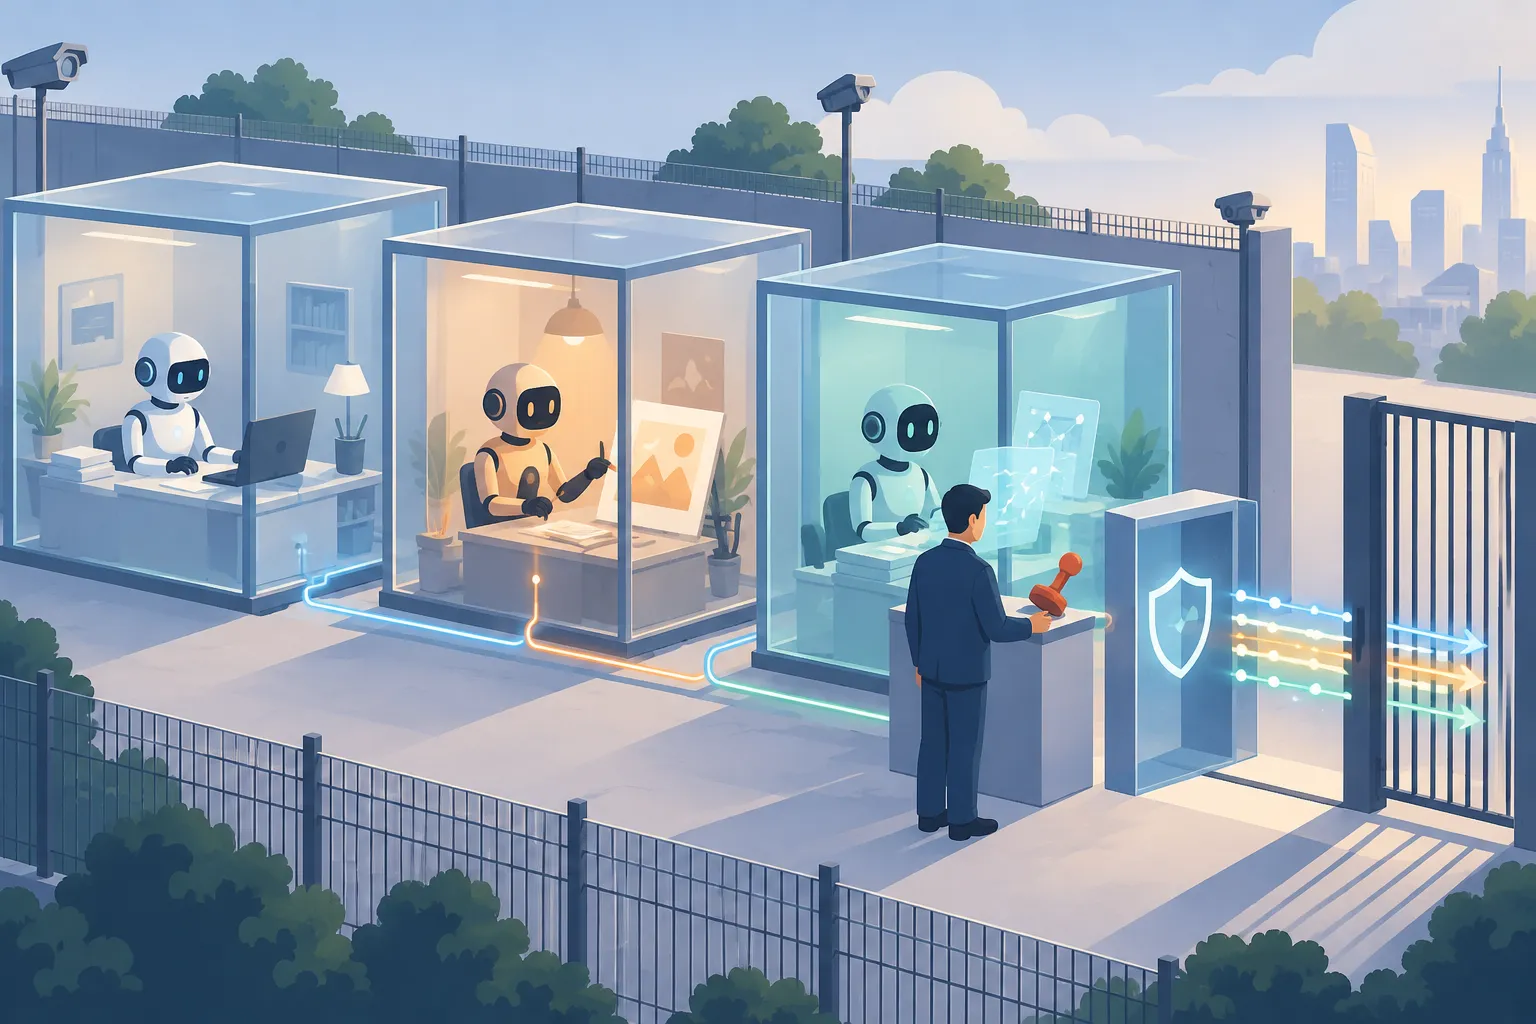
▲ エージェントの隔離とアクセス制御
ほかにも、エージェントを社員のノートPCではなく隔離されたクラウドのサンドボックスで動かすこと、外向きのネットワーク通信をフィルタリングすること、リクエストに認証情報を差し込むエグレスプロキシを使い、秘密情報がモデルのコンテキストに入らないようにすることが推奨されます。OSレベルの隔離と外向き通信の制御は、エージェントが大量の外部呼び出しを行うため、いまだに解決の難しい課題です。データ側にも手当てが必要です。個人を特定できる情報などの機密資産に印を付けるカタログやラベルがあれば、エージェントは触れてはならないものをプログラムで見分けられます。
セキュリティチームが自前でツールを作れる時代
エージェントは、セキュリティチームにとっての「作るか買うか」の計算も変えます。以前は社内のセキュリティハブを作るにはフルスタックのスキルを持つエンジニアが必要でしたが、今は明確なアイデアを持つ実務者なら自分で作れます。特に重要なのは、商用ベンダーが作る理由をほとんど持たない、組織固有のツールです。
一例がポリシー拒否の説明ツールです。開発者がKubernetesのアドミッションコントローラー(ポリシーに基づいてクラスターへのリクエストを許可または拒否する仕組み)やAWSのSCPによってHTTP 403エラーを受け取ったとき、従来はエラーのスクリーンショットを撮ってSlackのチャンネルに貼り、セキュリティチームに理由を尋ねるのが定番でした。セキュリティチームが作ったSlackボットなら、拒否の内容を読み取り、どのポリシーが発動したかを説明し、設定ミスの箇所を示し、変更すべき値を具体的に提案できます。例外が本当に必要な場合は申請手続きを案内し、承認が必要なときだけ人間のエンジニアを呼び込みます。このワークフロー一つで、繰り返し発生するセキュリティのチケットや作業の中断を25〜30%減らせると見積もられています。同じパターンはHIPAAやPCI DSSといったコンプライアンス分野にも広げられます。
エージェントを作ったことのない実務者には、シンプルな進め方が勧められています。
- 1〜2週間、AIモデルを日々の仕事の個人的なコパイロットとして使う。
- タスクを3つに分ける。AIに完全に任せられるもの、人間の監督付きで任せられるもの、人間が担い続けるべきもの。
- 同じ手順を繰り返す仕事を見つけ、自動化ワークフロー、エージェントのツール、社内アプリに変える。
たとえば大量に届くバグバウンティ報告の一次トリアージは、コードベースをコンテキストとして持たせたエージェントに任せられます。
ただし落とし穴もあります。セキュリティチームは管理者権限やroot権限の認証情報を持っていることが多く、セキュリティ用のエージェントが乗っ取られたりなりすまされたりすれば、深刻な被害につながりかねません。セキュリティチームは、開発者に課しているのと同じポリシーとサンドボックスのルールを自らの自動化にも適用すべきです。そして、秘密情報をプロンプトにさらさずにエージェントへ認証情報を渡す方法のような難しい問題を解決したら、その解決策を全社で使える舗装道路にするべきです。
エージェントの乱立に備える
今日、ほとんどの企業でAIを本当に使いこなしているチームは1つか2つにとどまります。それを超えて広げようとすると、クラウド時代のマイクロサービスの乱立と同じような「エージェントの乱立」が起きるおそれがあります。当時の答えはKubernetesとクラウドネイティブ基盤による標準化でした。この見方では、今の答えは、承認済みテンプレートとテレメトリーを備え、プラットフォームチームとセキュリティチームが共同で作る社内AIプラットフォームです。そうすれば従業員1万人以上の企業でも、どのエージェントが動いているかを把握し、基準に合わないデプロイを隔離し、インシデントに素早く対応できます。
セキュリティチームが今できること
エージェントのセキュリティは、最後の関門で止める方式から、エージェントがすでに働いている場所に会社のルールを置いておく方式へと移りつつあるように見えます。まず取り組むとよいのは次の点です。
- ポリシーをツールとして公開する。 セキュリティガイドラインと舗装道路を、エージェントが作業前に照会できるMCPサーバーや呼び出し可能な関数にする。
- チェックを前倒しする。 リンターやポリシーチェックをPRの段階ではなく、エージェントのローカルのループで実行する。
- 基本を確認する。 SCP、組織ポリシー、最小権限のアクセス、データ分類が整っているかを確かめる。
- 書き込み操作に関門を設ける。 本番環境を変える操作には、人間の承認と監査証跡を必須にする。
- 実行環境を隔離する。 エージェントをサンドボックスで動かし、外向きの通信と認証情報を管理する。
- ルールを内側にも適用する。 高い権限を持つセキュリティチームのエージェントほど、最も厳しい基準で管理する。