高性能なモデルは、企業向けAIエージェントを構成する要素の一つにすぎません。エージェント(タスクを実行するAIシステム)には、企業の意思決定を理解し、限られた権限の範囲内で動作し、割り当てられた業務をこなせることを示すことも求められます。Salesforceのプレジデント兼最高プラットフォーム・エンジニアリング責任者であるロハン・クマール氏は、最も難しいのはビジネスの文脈だと指摘します。企業は膨大なデータを保存していても、そのデータを役立つものにする判断の理由までは記録していないことがあるからです。
決定の記録は、決定のすべてではない
従業員が上司に社内規定の例外を認めてもらう場面を考えてみます。業務システムには承認という結果が保存されても、その背景にある事情や判断は残らないことがあります。後でエージェントが似たケースに直面しても、記録された結果だけでは、どう対応すべきかがわからない可能性があります。
同じ欠落は、通話やチャット、会議の中で決定が下される場合にも生じます。文字起こしが残っていても、肝心の理由は取り出しにくく、活用しにくいままになりがちです。こうした暗黙知をエージェントが扱える情報に変えるには、データベースへのアクセスを一つ増やすだけでは足りません。
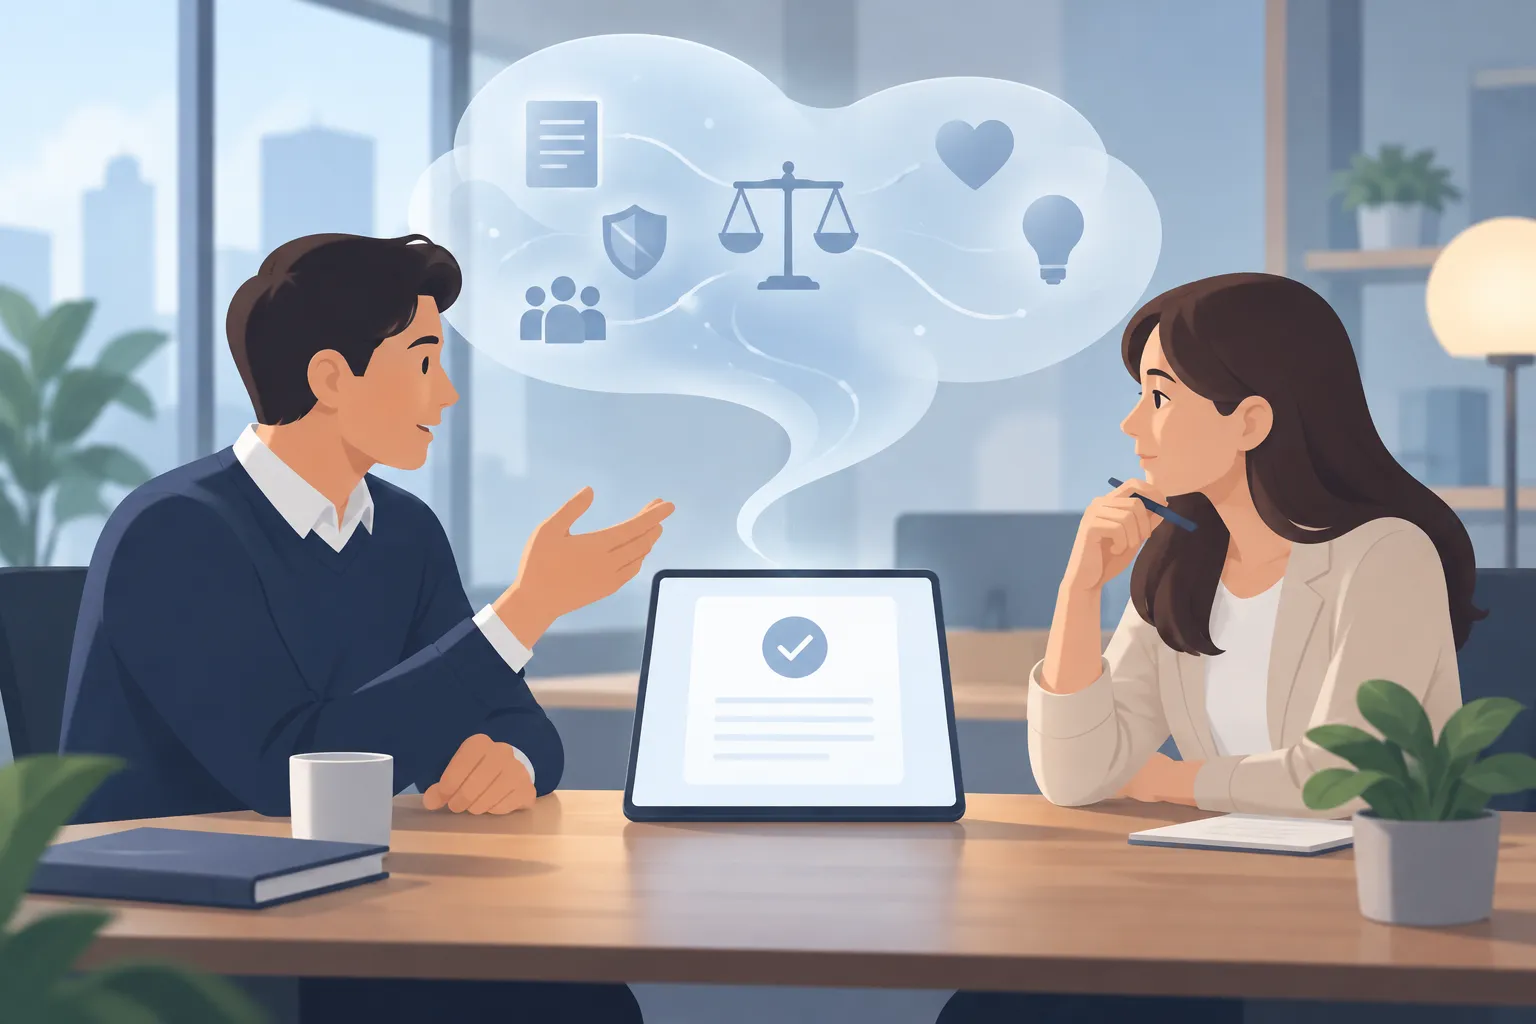
▲ 決定記録から抜け落ちた判断の理由
クマール氏は、企業向けエージェントの能力を三つの要素に分けます。エージェントのコード、基盤となるモデルが持つ汎用的な知能、そして個々の企業についての知識です。三つ目は汎用的な推論能力だけでは得られません。Salesforceは、28年にわたるCRMの経験と約10年にわたるデータ・AI研究を生かしたCRM向け推論モデル「Cora」を発表しています。その領域に特化して作られたモデルであっても、個々の企業の業務や意思決定の履歴は別に必要になります。
判断は業務の現場でとらえる
ソフトウェアエンジニアは、多くの設計上の選択を記録したソースコードを残します。一方、業務部門では、ある例外や対応を別の選択肢より優先した理由が、構造化された形で残りにくい傾向があります。モデルのコーディング能力が向上しても、それだけで的確な業務判断ができるようにならない理由の一端はここにあります。
クマール氏は、エンジニアが現場の担当者と直接協働すべきだと主張します。意思決定が行われる様子をその場で観察し、どの情報が重要かを学び、その知識をソフトウェアとして表現するということです。その中には、エージェントが業務情報や機能を利用するための定義済みのインターフェースであるAPIも含まれ得ます。狙いは、あらゆる判断が厳格なルールに従っているかのように扱うことではありません。最終的な行動の記録だけに頼るのではなく、関連する文脈や判断のロジックをテストや実運用で使える状態にすることです。
エージェントには無制限のアクセスではなく「ハーネス」を
エージェントハーネスとは、エージェントの構築、実行、テスト、統制に使う周辺の仕組みです。企業では、コードを実行したりAPIに接続したりする以上の役割が求められます。クマール氏が提案する管理策は次のとおりです。
- 評価: 信頼できる質問と期待される回答を厳選して集めたゴールデンセットでエージェントをテストし、その挙動を確認する。
- 中央レジストリ: 組織全体のエージェントを把握し、どれが稼働中で、どれを停止すべきかを管理する。
- エージェント固有のID: エージェントを呼び出した従業員の権限をすべて自動的に引き継がせるのではなく、タスクに限定した権限を与える。
- データポリシー: 情報を分類し、エージェントが機密情報と、公開情報や制限の緩い情報とを区別できるようにする。
権限の区別が重要なのは、個人の広範な認証情報で動くエージェントが想定外の動作をした場合、本来のタスクとは無関係な情報を漏らしかねないからです。アクセス範囲の限定はエージェントが到達できる範囲を狭め、評価は与えられたアクセスでエージェントが何をするかを確かめます。どちらも他方の代わりにはなりません。
エージェントが求める前に文脈を整えておく
エージェントをあらゆるデータレイク、データウェアハウス、ソフトウェアサービスに接続し、生のデータをそのままプロンプトに流し込むことは、有用な文脈を与えることと同じではありません。トークンとは、モデルが処理するテキストの単位です。「トークンマキシング」とも呼ばれるこの力任せの手法は、大量のトークンを消費する一方で、信頼できる回答を生むとは限りません。
クマール氏は、信頼できる文脈のレイヤーをあらかじめ用意しておくことを提案します。エージェントがリクエストを受けた時点ですべての処理を行うのではなく、午後11時から午前5時のような利用の少ない時間帯に、バックグラウンド処理でデータを整理しておくという考え方です。その過程で、業務データに一貫した意味を与えるセマンティックモデルや、業務上の概念とその関係を体系化するオントロジーを構築できます。エージェントが何を使ってよいかは、引き続きデータの分類によって決まります。
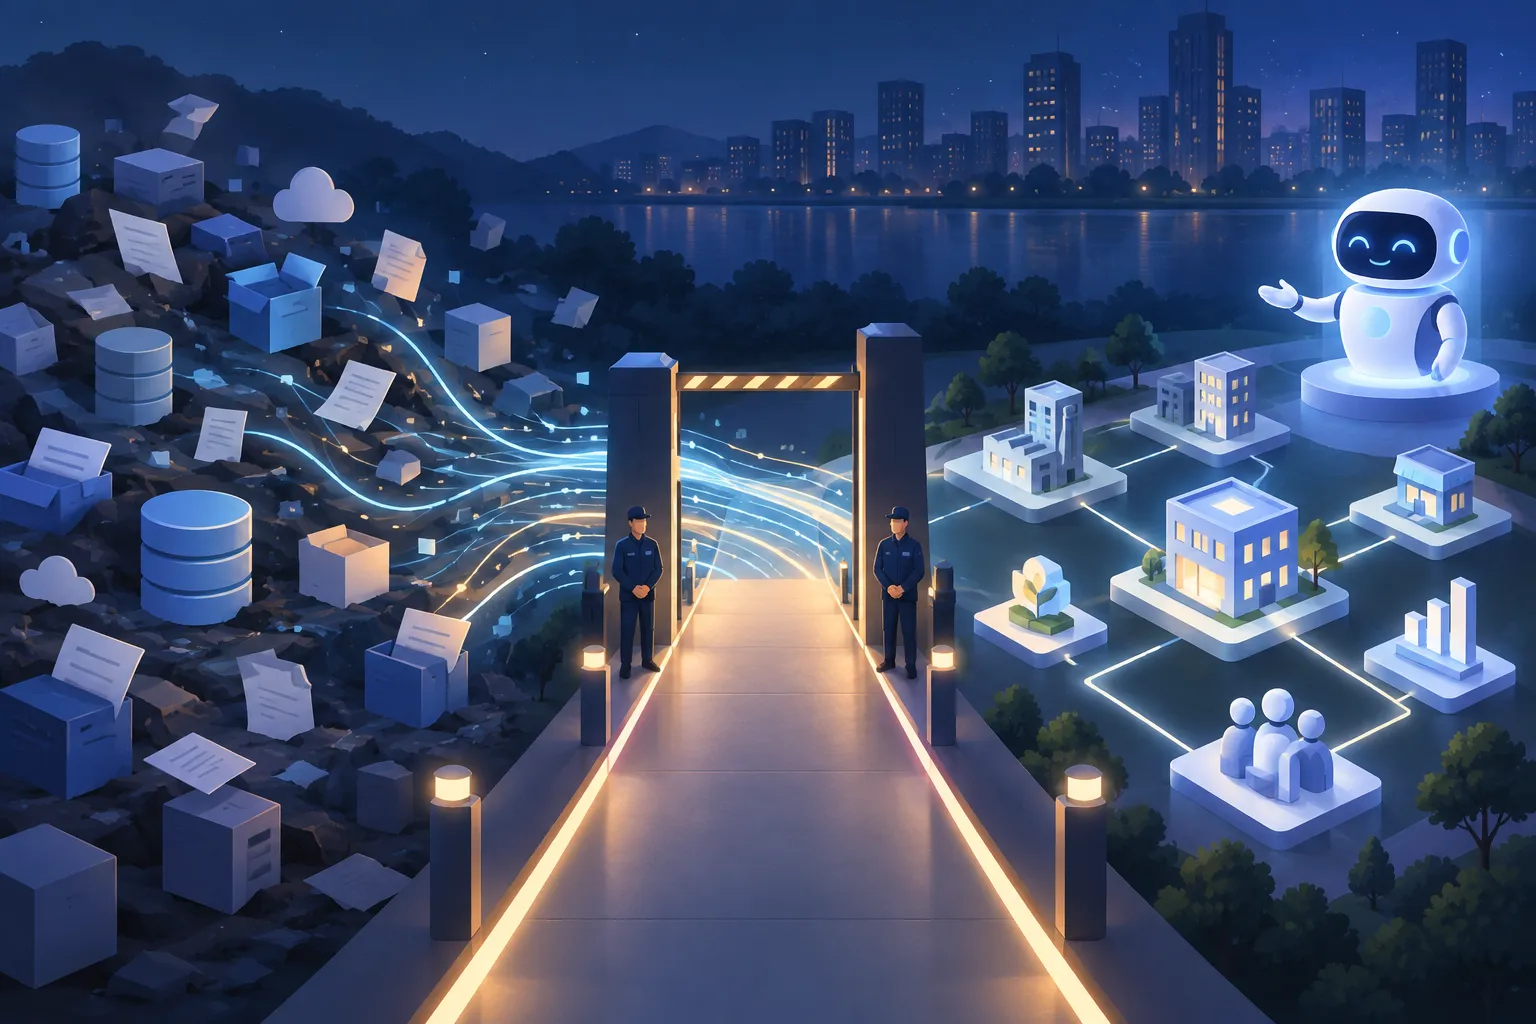
▲ エージェント向けに整理された業務文脈
こうした準備が難しいのは、企業の情報がさまざまなストレージシステムや形式に分散しているためです。ナレッジグラフは、それらを結びつける方法の一つです。エンティティをノードとし、その関係をクエリ可能なリンクとして表します。たとえば、「顧客」が「ケース」を持ち、そのケースが「ポリシー」に従う、という関係です。こうしたつながりを整理しておけば、エージェントはすべての情報源の生データを受け取らなくても、必要な業務上の関係を見つけやすくなる可能性があります。
モデルのコストをタスクに合わせる
ハーネスにはモデルルーティングも必要です。求められる性能と利用料金をもとに、タスクごとにAIモデルを選ぶ仕組みです。一部の業務では高性能なモデルを使う価値がありますが、日常的なリクエストすべてにそうしたモデルを使えば、企業での導入コストが過大になりかねないとクマール氏は指摘します。
実務上の問いは、結果の改善が追加コストに見合うほど意味を持つかどうかです。能力を上げても業務上の実質的な効果がないなら、ハーネスはその作業を、より軽量で安価なモデルに振り分けるべきです。この考え方では、モデルの選択は文脈の準備やアクセス制御と同じハーネスの一部であり、後から別途決めるものではありません。
エージェントの活用を広げる前にすべきこと
組織が記録してこなかった判断の理由は、より強力なモデルでも取り戻せません。整理されたデータ基盤があっても、過剰な権限が安全になるわけではありません。取り組むべきは、これらの要素を並行して整えることです。
- 承認や例外を記録している業務フローを見直し、その理由も記録されているかを確認する。
- エンジニアが意思決定を行う担当者を観察し、関連する文脈をエージェントが読み取れるソフトウェアに落とし込む。
- ゴールデンセットでエージェントをテストし、中央で登録したうえで、認証情報を割り当てたタスクに限定する。
- 利用を認めたデータをクエリが来る前に整理し、エージェントが実際に担う業務について、モデルの性能とコストを比較する。
これらのステップによって、エージェントの業務知識、挙動、アクセス、費用が見える化されます。どのタスクをエージェントに任せられるかを判断するための、より明確な根拠にもなります。