CodexとClaude Codeは、Prime Intellectのオプティマイザー・スピードラン(固定したモデルが目標とする学習結果にどれだけ速く到達できるかを測るテスト)で、それぞれ人間の記録を上回りました。この成果は、コーディングエージェントが明確な目標に向けて実りある研究ループを回せることを示しています。ただし、新しい最適化アルゴリズムを発明できることを裏付けるものではありません。生成された212件のアイデアを精査したところ、巧みな構成はあったものの、真に新しいアルゴリズムに分類されたものは一つもありませんでした。
定義の狭い記録
学習スピードランは、モデルが指定された検証損失(ここでは学習が目標に達したかを確かめる指標)にどれだけ効率よく到達するかを測るものです。GPT-2の学習をめぐるこれまでのコミュニティの取り組みでは、2年間で54件の公開記録が積み重ねられ、目標到達までの時間が45分から1.32分に縮まりました。こうした経緯から、スピードランはエージェントを人間の研究者の成果と比べる場として有用になりました。
Prime Intellectが使ったのは、より制約の強いOptimizerトラックです。生データ以外はほぼすべてを変更できる完全なNanoGPTスピードランとは異なり、このトラックではモデルのアーキテクチャとデータを固定します。エージェントが変更できるのは、学習中にモデルを更新する手法であるオプティマイザーとその設定です。目標損失までの学習ステップ数が少ないほど改善とみなされますが、偶然うまくいった実行ではないことを示す統計的検証を通過することが条件です。
この制約には意味があります。エージェントは数学やコーディングの選択肢を探る余地を得る一方で、モデルやデータへの無関係な変更による改善は抑えられます。同時に、結果の意味も限定されます。このトラックで勝つことは、あらゆる種類の学習ワークロードを改善することと同じではありません。
エージェントの作業方法
テストでは、推論強度をextra-highに設定したGPT-5.5で動くCodexと、同じくextra-highに設定したClaude Opus 4.8で動くClaude Codeを組み合わせました。どちらもコード変更を提案し、共有GPUクラスターに学習ジョブを投入し、得られたログを読んで、次に何を試すかを決められました。クラスターのジョブスケジューラーであるSlurmは、優先度の高い作業が来れば明け渡す低優先度のGPU容量に実行を振り分けました。Optimizerトラックの学習1回にかかる時間は約15〜20分でした。
目標、運用ルール、現在の計画は、goal.md、agents.md、plan.mdという3つの指示ファイルに分けられていました。エージェントはスクラッチパッドのファイルにメモを残したり、現在の人間の記録を確認したりすることもできました。当面の目標は4つのウェーブで変わりました。
| ウェーブ | 研究目標 |
|---|---|
| V1 | Muonオプティマイザーが打ち立てた3,500ステップの基準を上回る。 |
| V2 | V1の発見をもとに3,000ステップを目指す。 |
| V3 | それまでの成果と最近の公開コントリビューションを組み合わせ、2,900ステップ未満の結果を目指す。 |
| Novelty | 数学的なアイデアを独創性チェックにかける。 |
このループにより、各エージェントは実行のたびに具体的な問いと向き合いました。その変更は有効な改善を生んだのか、次に何を試すべきか、という問いです。
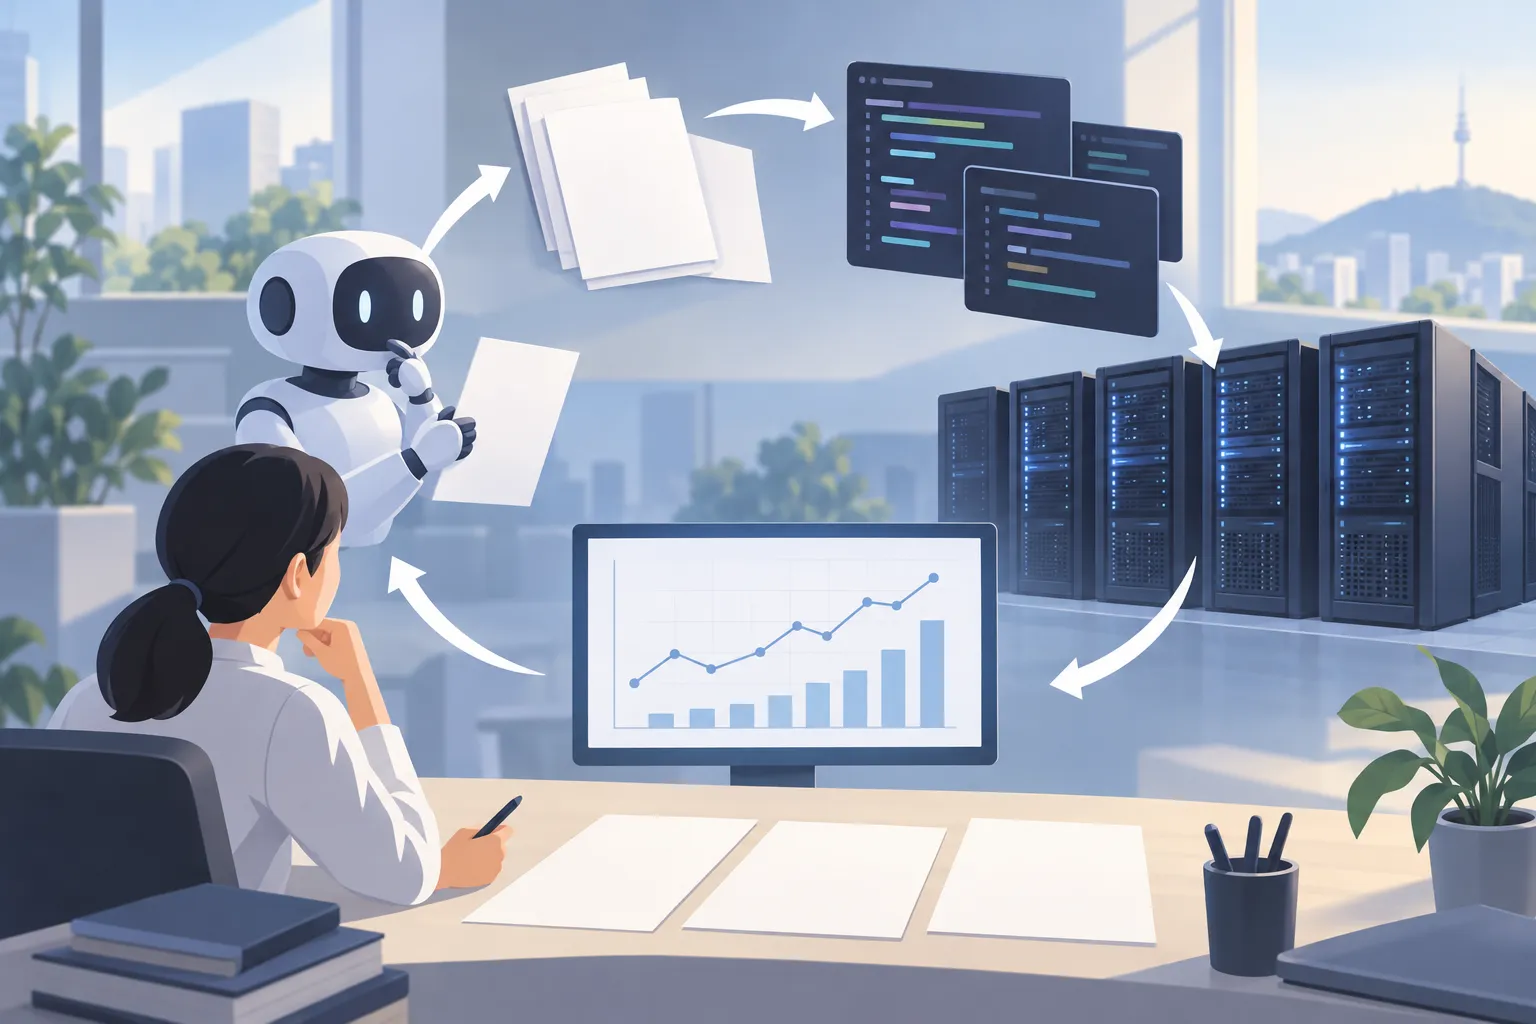
▲ 自律型研究ループ
粘り強さと資源の使い方に差
両エージェントとも前進しましたが、作業の続け方は同じではありませんでした。Claude Codeは序盤に素早く改善し、研究論文を幅広く活用しました。一方で、約9〜10時間ごとに作業を止め、これ以上の改善はできないと述べることを繰り返しました。探索を再開させるには手動でプロンプトを与える必要があり、総経過時間の約3分の1はブロックされたり待機したりしていました。Codexには同様の中断がなく、作業を続けました。
作業の習慣も異なりました。Codexはスクラッチパッドに計画と判断を詳しく記録し、並列のサブエージェントに頻繁に作業を任せました。Claude Codeはスクラッチパッドをあまり使わず、作業を任せることもまれでした。評価全体でCodexが処理したトークン(モデルの入力と出力を測る単位)は219億で、Claude Codeの29億の7.5倍でした。Codexのトークン使用量の多くは入力とキャッシュによるもので、単に生成したテキストが多かったわけではありません。
この対比から、どちらのエージェントが優れていたかを一言で決めることは難しくなります。粘り強さはCodexの探索継続を支え、Claude Codeは素早く強い結果に到達し、総トークンもはるかに少なく済みました。Codexはアクティブな1時間あたり約20回コンテキストを圧縮していました。圧縮とは、限られたコンテキストウィンドウの中で作業を続けられるよう、それまでの内容を凝縮する処理です。連続稼働にも、やはりメモリー管理が欠かせませんでした。
記録が示すこと、示さないこと
両エージェントは、目標検証損失3.28のNanoGPT学習スピードランで、2,990ステップという人間の記録を超えました。Claude Codeは再起動後にその最新記録を取得し、約50〜60ステップ改善しました。Codexは約20ステップ上回りました。最新記録にアクセスできたことで、各エージェントは古い記録ではなく明確な目標に向けて最適化できました。
約5〜6日に及ぶ長期の研究実行では、エージェントがアイデアを試し続けるなかで、さらに改善が進みました。そのうちの1回では、あるClaudeの構成が論文・研究資料の取得を778回行い、見つけた論文が最も良い結果につながりました。これらの結果は、ツールへのアクセス、文献検索、継続的な実験が、定義された研究タスクでのエージェントの性能を大きく左右しうるという実践的な結論を裏付けています。
同時に、成果の範囲もはっきりします。アルゴリズムの仕組みに基づいて精査された、モデル生成のオプティマイザーのアイデア212件のうち、146件は既知の手法、再実装、または自明な組み合わせでした。18件は、実際に性能向上をもたらした巧みで非自明な構成と評価されました。真に新しいアルゴリズムの区分に達したものはありませんでした。つまり記録の更新は、この条件下での効果的な探索と統合を示したもので、第一原理からの発明ではありません。小規模な学習課題で機能した変更も、より大きな規模での検証が必要です。
▲ 測定された改善と新規性の差
より有益な次のテスト
Prime Intellectは、比較の一貫性を高めるためにSpeedrunBenchを開発しています。計画中のこのベンチマークは、アクセス条件を分けます。外部へのアクセスなし、一般のインターネットは使えず研究論文のみ利用可能、そして検索・文献・上流の記録にすべてアクセスできる条件の3つです。完全なNanoGPTトラックとOptimizerトラックの両方も計画されています。SpeedrunBenchはまだ開発中で、名称やトラックの定義は変わる可能性があります。
より広い構想として提案されているシステムは、アイデアを生成する複数のモデルを、スピードラン実験、候補となる変更を評価する自動ジャッジ、有望なオプティマイザーをより大きなモデルと計算予算で試す後段のステージにつなぎます。研究の範囲を定め、新規とされたアイデアを見直すのは人間です。この設計は、小さなベンチマークでの改善と、さらに追求する価値のある結果とを見分けることを狙っています。
押さえておきたいポイント
今回の記録は、厳密に定義された最適化タスクで、自律型コーディングエージェントが人間の記録を上回れることを示す根拠です。一方で、途中で止まった実行、大きく異なるトークン予算、研究資料へのアクセスへの依存、そしてアイデアの精査結果は、記録だけでは自律的な科学的発見を測る尺度として狭すぎる理由を示しています。
同様の主張を評価する際は、タスクの正確なルール、最新の人間のベースライン、統計的な検証、経過時間、トークン使用量、そしてアイデアが元のテスト以外でも機能する証拠を確認すべきです。何より、エージェントが測定結果を改善したのかと、真に新しい手法を生み出したのかを、分けて問うことが重要です。