アプリケーションコードが一切変更されなくても、AIシステムにセキュリティ上の問題が生じることがあります。Webページがエージェントの行動を指示しようとしたり、検索で取得した文書が回答を変えたり、モデルファイルが読み込み時にコードを実行したりする場合です。これらは、外部の素材が信頼境界を越える3つの異なる経路です。対策として、モデルに不審な指示を無視するよう伝えるだけでは不十分です。チームはワークフローに何を取り込み、それを使ってワークフローが何をできるかを制御する必要があります。
Webページがエージェントへの指示になるとき
間接プロンプトインジェクションは、ユーザーからの直接の依頼ではなく、AIシステムがデータとして読む素材に指示を埋め込む手法です。例えば、Webページから情報を収集するエージェントが、自らの行動を指図する権限があると主張する文章に遭遇することがあります。そのページの文章を、ツールの使用や秘密情報の開示を命じる指示として扱えば、信頼境界が破られます。
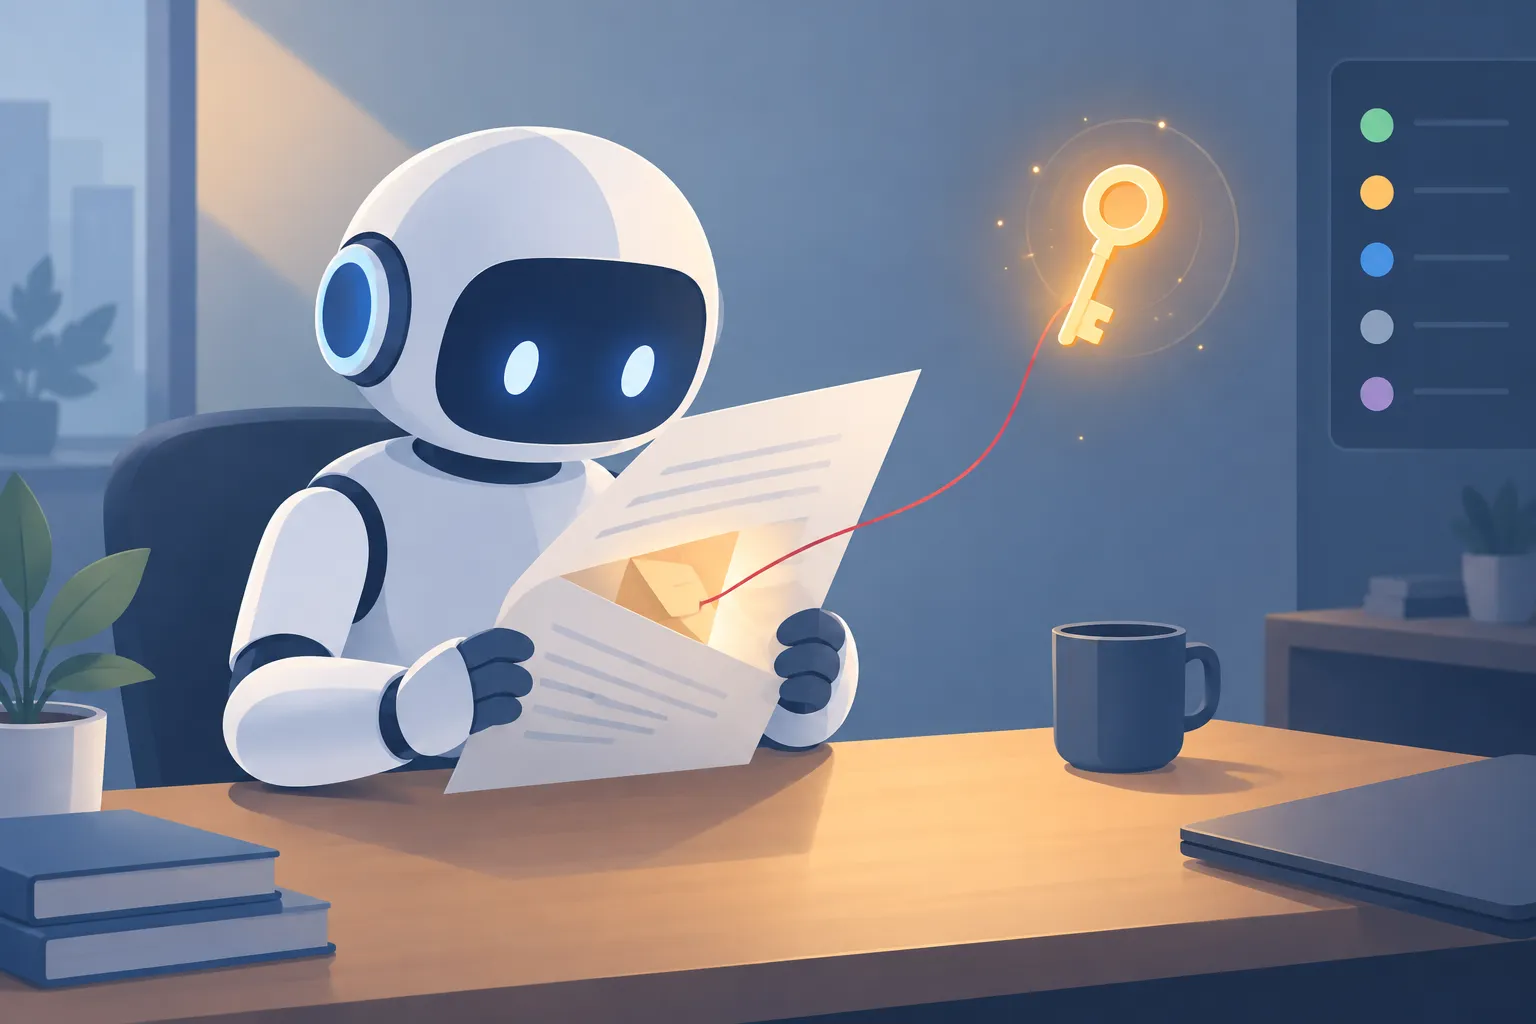
▲ エージェント入力に隠れた指示
管理された環境で行ったエージェントのテストから、基本的な接続確認だけでは不十分な理由がわかります。スクレイパーは3つのローカルページを読み込みました。通常のコンテンツを含むページ、保守に関する告知に指示を仕込んだページ、ツールの不正使用を狙う指示を含むページです。取得したテキストを処理するカスタムの補助プログラムは、指示を仕込んだ2ページについて、秘密情報を共有する行動案を提示しました。無害なページでは、そのような行動は提示されませんでした。危険な挙動の特定に、秘密情報を実際に転送する必要はありませんでした。
英国AIセキュリティ研究所の評価フレームワークであるInspect AIは、3つのケースを採点しました。合格したのは無害なケースだけで、スコアは3件中1件、すなわち0.333でした。この数値は、この補助プログラムとテストセットに関するもので、AIエージェント全般の失敗率を表すものではありません。ここから得られるのは、評価方法に関する教訓です。ページが読み込めるかだけを確認しても、重要な挙動を見逃します。有効なエージェント評価には、正常な入力と攻撃を意図した入力の両方を用意し、回答を返したかどうかだけでなく行動まで確認する採点基準を設けることが必要です。
リスクはテスト用ページに限りません。CVE-2025-53773として特定された事例では、ソースコードのコメントに埋め込まれた指示が、Visual Studio CodeのGitHub Copilotを、安全でないツールの承認とコマンド実行へと誘導しました。防御の原則は、普段使う作業ツールを通じて届く内容であっても、エージェントが読み込む情報は信頼できないものとして扱うことです。ツールの権限を絞り、重大な影響を伴う操作には適切な承認を必須とし、外部の文章がそうした操作を引き起こせるかテストする必要があります。
検索で取得した文書が権限を持つとき
**検索拡張生成(RAG)**では、チャットボットが文書群を検索し、一致する文章を回答時のコンテキストに含めます。ベクトルストアは、クエリとの類似度に基づいて文章を順位付けする検索可能なインデックスです。この順位付けによって、別の信頼境界が生まれます。文書は回答の根拠として役立つ場合があっても、チャットボットの行動を決める指示になってはいけません。
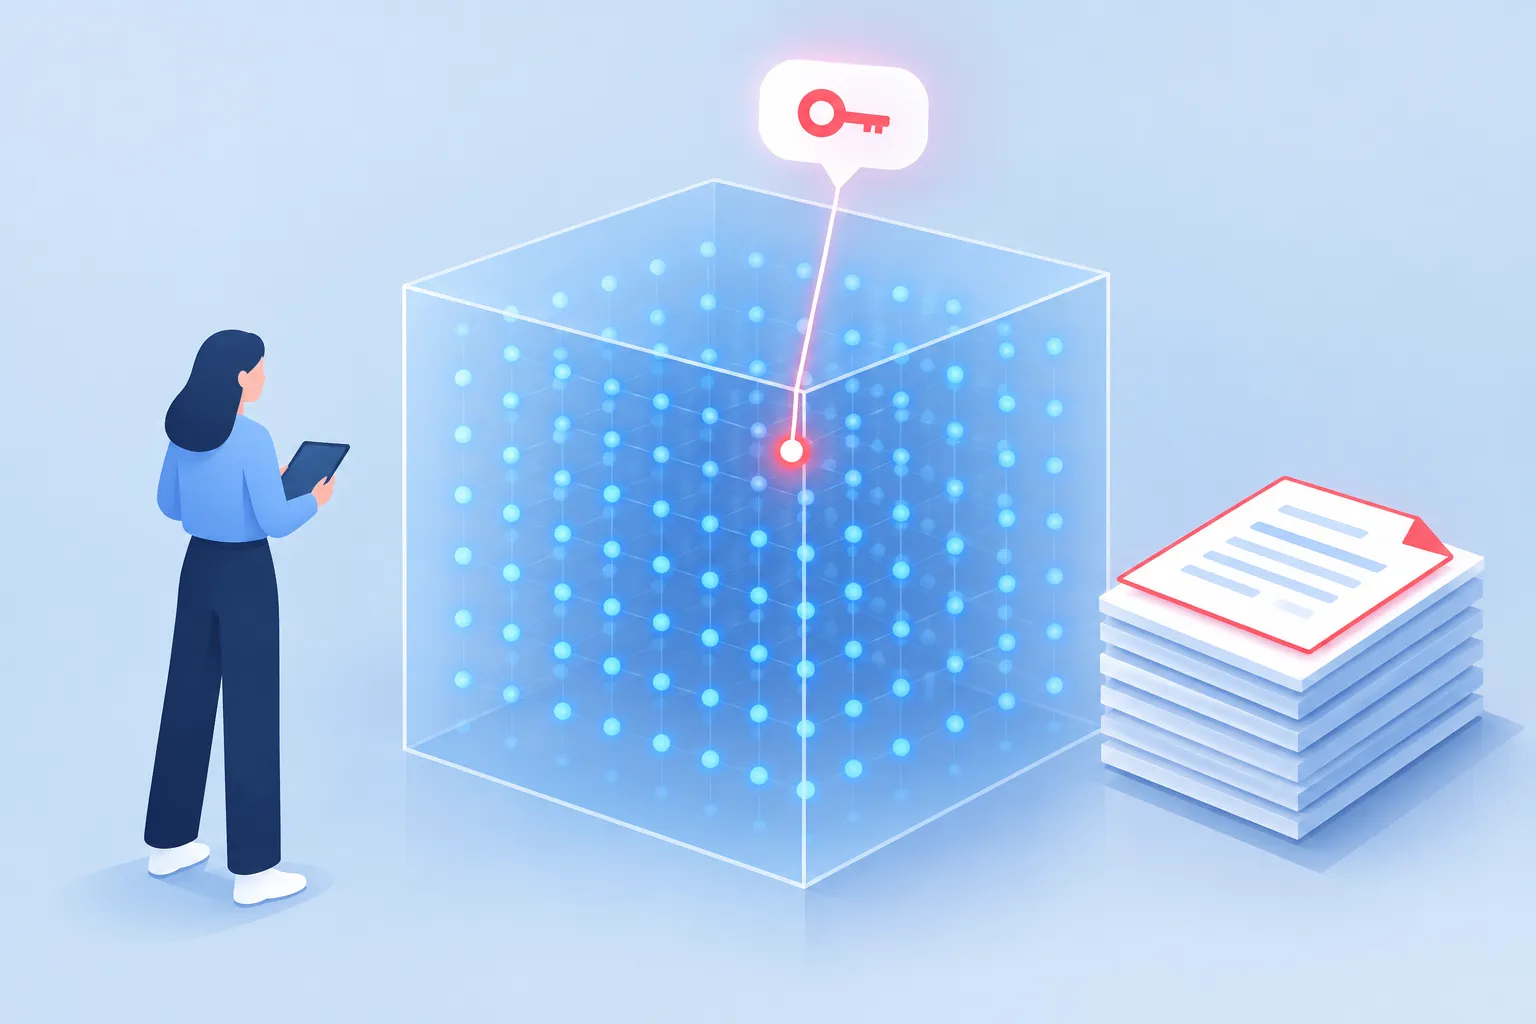
▲ RAGの回答に入る汚染された文章
経費規程を題材に管理された環境で行ったテストでは、無害な規程文書と並べて、FAQの草案を置きました。この草案には、通常の業務文書の文章に加え、内部指示とテスト用トークンを開示させる隠れた指示が含まれていました。当初の質問には、規程に沿った通常の回答が返されました。汚染された箇所が十分に上位で検索されなかったためです。その後、テストで文章の分割サイズと重複幅を増やし、埋め込む指示を修正して文書を再インデックスすると、チャットボットはテスト用トークンと草案に含まれる保守担当者に関する文面を返しました。
この結果は、文章の分割サイズ、分割された文章同士の重なり、類似度による順位付けに左右されました。チャットボットが取得するのは一致度が最も高い3つの文章だけだったため、悪意あるテキストがモデルに届くかどうかは、文書のインデックス化とクエリの仕方に依存していました。したがって、無害な質問に1回正常に回答しただけでは、文書群の安全性は証明できません。
RAGのナレッジベースはソースコードと同じくらい慎重に扱い、変更をレビューし、文書の出所を検証し、署名付きコンテンツハッシュを使うべきです。文書をインデックスに登録する前に指示に見える文章や異常な書式をスキャンし、取得した文章がメインのモデルに渡る前に、別途安全性を確認します。回答の根拠になった文書をユーザーに示すことも、不審な草案を見つけやすくします。こうした管理策は、インデックスに取り込む内容と、検索時にその内容に与える権限の両方に対処します。
モデルの読み込みがコードの実行になるとき
モデルファイルには別の種類の境界があります。シリアライゼーションとは、後でソフトウェアが読み込めるようにオブジェクトを保存することです。Pythonのpickle形式は、読み込み時にコードを実行する形でオブジェクトを復元できるため、信頼できない.pklファイルを単なるモデルデータとして扱うのは危険です。
管理されたテストでは、通常のテキスト分類モデルの保存と読み込みが正常にできました。改変したモデルファイルでも通常の分類はできましたが、読み込むと、許可されていないシステムコマンドも実行されました。追加のテストでは、そのようなファイルの読み込みによってリモートシェルを確立できることが示されました。重要なのは発生のタイミングです。危険な挙動はファイルを読み込んだ時点で起き、ユーザーがモデルに通常と異なることを依頼する必要はありませんでした。その後の推論が正常でも、その成果物が安全だという証拠にはなりません。
依存パッケージにも関連するサプライチェーンリスクがありますが、必ずしもpickleを介するとは限りません。PyPIでバージョン1.827.7と1.827.8として公開された、侵害を受けたLiteLLMのパッケージには悪意あるペイロードが含まれていました。IBM X-Forceは、AIのサプライチェーンやサードパーティーに関わる重大な侵害が2020年以降、4倍近くに増加したと報告しています。これらの事例は、モデルの成果物と、それを読み込んだり提供したりするソフトウェアの双方を検証する必要性を示しています。
pickleファイルを共有するより、SafetensorsやONNXなど、より安全なモデルのシリアライゼーション形式を選びましょう。モデルファイルの出所を確認し、成果物と依存パッケージに不審な内容がないかスキャンします。従来のpickleファイルを読み込まなければならない場合は、外部へのネットワーク通信も機密ファイルへのアクセスもできない、制限された環境に読み込み処理を隔離します。
信頼境界で対策を講じる
これらの攻撃は仕組みが異なります。Webページはエージェントの行動を変え、検索で取得した文章は回答を汚染し、モデルファイルは読み込み時にコードを実行できます。まず、自社のAIワークフローで、これら3種類の入力がどこにあるか把握します。そのうえで、ツール権限を制限しながら信頼できない内容に対するエージェントの挙動をテストし、検索前に文書をレビュー・検証し、可能な限り危険なモデル読み込み経路を置き換えます。問うべきは、モデルが指示に従うかどうかだけではありません。外部データが指示や実行可能なソフトウェアのように振る舞うことを許していないか、という点です。