不少Claude Code用户为了压低账单,会安装第三方GitHub仓库、各类插件或复杂的技巧。其实这些做法很可能大多没有必要。Anthropic从一开始就把Claude Code设计成尽量节省用量,每次发布新版本还会自动加入更多这类机制。如果账单依然偏高,原因通常是几个日常习惯悄悄抵消了这些节省,而其中大多数都会引发同一件代价高昂的事:Claude按原价重读整段对话。
为什么每条消息都比上一条更贵
token是Claude计费的基本单位,大小约相当于一个短单词。为token付费有两种方式:消耗Claude月度订阅的固定额度,或者通过API密钥按token付费。
不妨把Claude想象成一位技术高超、却完全失忆的施工承包商。它在两条消息之间什么都不记得,所以每发一条新消息,从第一条提示词开始的整段对话都会重新发给模型。Claude每一轮读入的全部内容就是它的上下文,用户要为它在整个上下文中读取的token付费。这就是为什么长对话每条提示词的成本高于短对话,也是为什么早早加载的文件会在之后每一轮继续产生读取费用。相比之下,新开的对话从零token开始,不产生费用。
提示词缓存减轻负担
Claude Code用提示词缓存来应对这个问题。它像一种短期记忆,用来保存对话中没有变化的部分。读取已缓存的上下文,费用约为正常输入价格的十分之一甚至更低,只有新增内容按原价计费。
缓存有两个弱点。一是中途发生变化会让缓存失效,例如在对话进行到一半时在Claude的Sonnet和Opus模型之间切换,Claude Code随后就会按原价重读整段对话。二是停止工作后缓存会过期:
| 付费方式 | 闲置时的缓存保留时间 |
|---|---|
| 月度订阅 | 约1小时 |
| API密钥或额外额度 | 5分钟 |
Anthropic对此相当重视。Anthropic Engineering一篇介绍如何构建Claude Code的文章提到,内部工程师会监控缓存命中率的告警,也就是输入中从缓存读取的比例,一旦这一比例降得过低,就会宣布SEV,即正式事故。对用户来说道理相同:趁缓存有效时工作最省钱。
Claude Code已经替你做了什么
除了缓存,Claude Code还内置了三种防止上下文膨胀的机制:
- 连接器按需加载: 连接器把Claude接入Slack、GitHub等应用,每个连接器都附带冗长的使用说明和模式定义。Claude Code一开始只加载连接器的名称,等工具真正运行时才读入细节。要浏览邮件、笔记、日历、任务或代码托管类连接器,可以点击加号图标,打开连接器菜单。
- 长输出会被截短: 当终端命令或工具返回大段文字时,Claude Code会截短进入上下文窗口(模型一次能容纳的文本量)的内容,并把完整输出另存为一个文件。Claude只在需要查看时才会打开这个文件。
- 子智能体承担繁重工作: 遇到庞杂的大任务时,Claude Code可以在独立对话中启动辅助的子智能体,它们只向主对话返回简短摘要。子智能体本身也消耗token,因此只在大而复杂的任务上划算,不适合小脚本或简单提问。
当上下文窗口接近上限时,Claude Code还会自动压缩对话,这项功能叫作auto-compact。推高账单的并不是功能缺失,而是削弱这些内置节省机制的习惯。
习惯一:把/compact当作节食
用/compact压缩一段长对话,感觉应该能降低账单。设想有人花了90分钟、来回60条消息制作一个落地页,发现响应变慢后执行了压缩。
为了写出替代原对话的摘要,Claude得先把整段对话从头到尾再读一遍,就像助理在起草会议纪要之前,必须先通读完整的会议记录。如果缓存仍然有效,这次读取很便宜;如果已经过期,就要按原价为全部历史付费。无论哪种情况,新摘要都会从零开始建立新的缓存。
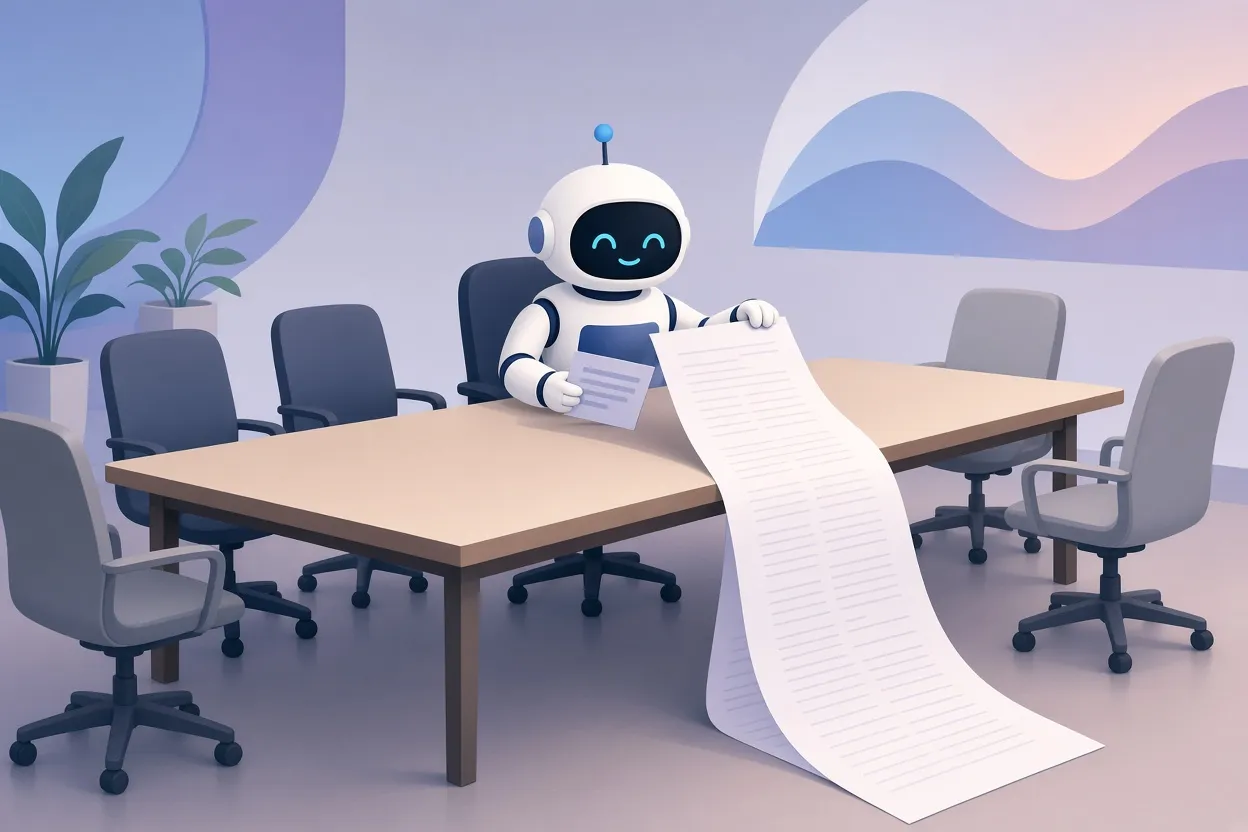
▲ 每份压缩摘要背后的全文重读
压缩的本来用途,是在接近上限或跨越重要阶段时为上下文窗口腾出空间。它不是省钱手段,而且接近上限的情况auto-compact已经会自动处理。如果确实要手动压缩,应告诉Claude要保留什么,例如/compact 保留计划和文件名,然后确认哪些要求被保留了下来,因为压缩可能会丢掉你早先给出的细节指示。
比压缩更好的做法
| 情况 | 做法 | 效果 |
|---|---|---|
| 完成了一项任务 | 运行/clear,重新开始 |
上下文归零 |
| Claude走错了方向 | 运行/rewind,而不是跟它争论 |
把对话回退到出错之前 |
| 持续进行的长期工作 | 让Claude写一份交接文档,然后/clear |
新对话只读取你决定保留的内容 |
交接文档应记录目标、已完成的工作、剩余的工作、做出的决定以及行不通的做法。由于你可以在下一次会话开始前阅读并修改它,比起压缩生成的摘要,你能更好地掌控要延续哪些内容,因此对复杂项目来说,它看来是更好的选择。如果之后可能还要回看某段对话,可以在/clear之前先运行/rename,以便从侧边栏重新打开。
习惯二:让缓存过期
每段对话背后都有一个看不见的计时器。上午一直在做落地页,出去吃了一个小时午饭,回来时缓存已经没了。这时只要问一个小问题,Claude Code就会按原价重读整段对话,然后才为后续消息建立新的缓存。
最近的Claude Code版本缓解了这个问题。当一段大对话闲置接近一小时,Claude Code会在缓存过期前将其压缩,等你回来时读取的是简短摘要,而不是原始历史。这项功能随每次发布不断改进,但生成摘要仍需完整读取一次,过程中也可能丢失细节。
在按量付费的API方案中,缓存只能保留5分钟,因此休息应安排在完成一项任务之后,而不是任务进行到一半时。
习惯三:任务中途切换模型
每个模型都有自己的缓存,Opus和Sonnet之间并不共享。为了省钱在会话中途从Opus换成Sonnet只会适得其反,因为Sonnet读不了Opus的缓存,只能按原价重读对话。开工前选定一个模型,并一直用到底。
/model opusplan设置同样需要留意。它在Plan Mode中使用Opus,让Claude在动任何文件之前先规划架构和步骤,随后在构建阶段自动切换到Sonnet。这种分工对做规划可能有用,但两个模型之间每切换一次,都会触发一次完整的上下文重读。
习惯四:还没输入就加载了太多内容
打开新对话,只输入“hi”,Claude Code在你的提示词运行之前就已经加载了文件。其中最主要的是CLAUDE.md,也就是Claude Code在每次会话开始时都会读取、并在之后每一轮一起发送的项目说明文件。一份600行的CLAUDE.md在缓存有效时花费不多,但每次缓存过期都要按原价重读。Anthropic的文档建议把这个文件控制在200行以内,只保留必要内容。
树状结构会有帮助。把CLAUDE.md当作只放顶层指引的树干,把设计、测试、部署等领域的详细规则移到单独的分支文件中。这样CLAUDE.md就成了指引Claude找到这些文件的索引,这些文件只在任务需要时才会加载。
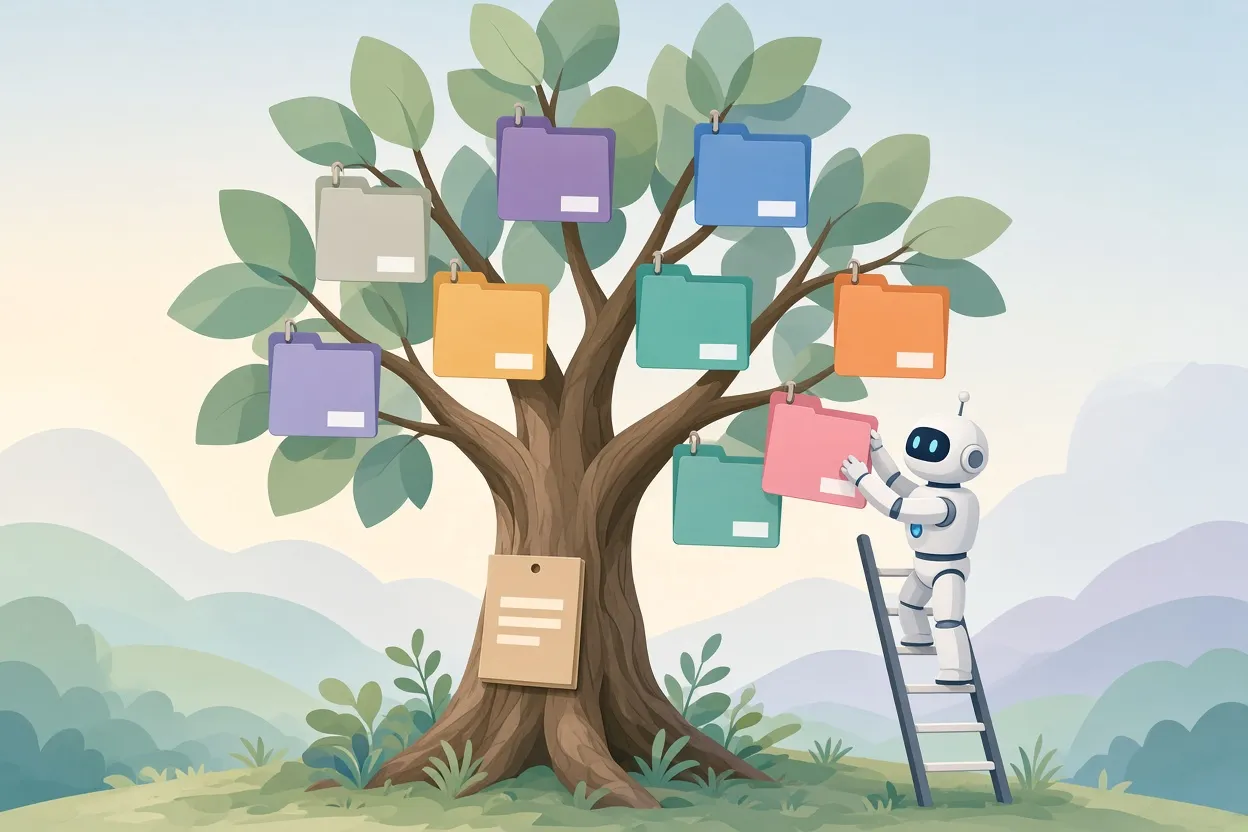
▲ 以树干和任务分支文件组织的CLAUDE.md
同样的思路也适用于其他开销:
- 带脚本的技能: 技能是Claude可以调用的一组打包指令,在被调用之前只会向上下文添加一行描述。如果技能用本地脚本完成确定性的工作,Claude就无需读取原始数据。例如一个每周销售统计技能,可以让脚本在你的电脑上汇总电子表格各行,只交给Claude一行结果,比如“销售42笔,上次为38笔”。当某个工作流程运行顺利时,可以让Claude“把这个做成技能”。
- 闲置的连接器: 通过MCP(Model Context Protocol,一种把AI工具连接到外部应用和数据的标准)接入的每个连接器,都会给每次会话增加token,每个技能也是如此。运行
/mcp,关闭日历、笔记、邮件、任务等不用的连接器。 - 掌握占用情况:
/context会显示用户消息、已读取的文件、Claude的回答和工具各占多少空间,以及还剩多少空间。/doctor会检查你的设置,确认Claude Code是否为最新版本,并标出不需要的连接器。 - 测试输出: 自动化测试套件可能输出几百行内容,几乎都只写着“PASSED”。Claude Code只截短特别长的输出,所以这些行会进入对话,并在之后每一轮被重读。解决办法是钩子,一种在Claude读取之前拦截测试输出并加以精简的过滤器。不必自己编写,只需让Claude“写一个钩子,把测试结果精简到只剩失败项”。
昂贵的默认设置和含糊的提示词
在付费方案中,Claude Code默认使用Opus并开启思考模式(thinking)。思考模式是指Claude在给出可见回答之前先进行内部推理,这些推理token按输出计费,而输出的价格是输入的5倍。用开着思考模式的Opus处理日常杂务,就像请顶尖外科医生来量体温。
- 日常编程和构建使用Sonnet。
- 用
/effort设置推理深度。选项从low(“快速,适合简单任务”)到medium、high,再到max(“最慢、最深入”)。重命名文件这类简单任务选low即可。 - 在Claude修改文件之前切换到Plan Mode,先就步骤达成一致。
提示词同样重要,但重要的方式与许多人想的不同。你输入的文字只占上下文的一小部分,决定成本的是提示词把Claude的注意力引向哪里:
| 提示词 | Claude读入对话的文件 |
|---|---|
| “修复这个bug” | 6个:购物车、结账、页头、页脚、登录和搜索 |
| “修复结账文件里的日期bug” | 1个:结账 |
删减提示词里的字几乎省不了什么。点明具体文件,才能避免Claude去扫描其他所有文件。
小结:三条规则和一周后的复查
大多数意外支出都可以追溯到本可避免的重读:压缩、切换模型、过大的CLAUDE.md,以及午饭期间过期的缓存。以下三条规则能让缓存为你所用:
- 一项任务只用一个模型。
- 趁缓存有效持续工作,休息安排在任务与任务之间。
- 任务完成后运行
/clear,在新对话中开始下一项任务。
此外,把/compact留到上下文窗口快满时再用,把CLAUDE.md控制在200行以内,关闭闲置的连接器,简单工作使用Sonnet并把effort设为low。
然后衡量效果。/usage会按技能、子智能体和连接器显示今天和过去7天的token消耗。现在记下数字,做出调整,一周后再查看一次。用量降低,意味着订阅额度更宽裕,API密钥的账单也更少。说到底,最便宜的token,是Claude能从有效缓存中读取的那些。