Harness²是Google Cloud AI Research与美国西北大学推出的研究框架,目标是在不改动底层模型的前提下,让AI智能体把工作做得更好。它不重新训练权重,而是让智能体在工作过程中自行编辑模型周围的指令、规则和辅助文件。在一项仲裁文书审查任务的测试中,Gemini 3.5 Flash经过一轮自我编辑,55项自动检查中的通过数从20项增至22项,花费约$11。提升幅度不大,但与研究团队报告的平均水平基本一致,而研究团队自己的案例研究中还有提升幅度大得多的例子。
为什么改harness而不是改模型
大多数让智能体变得更聪明的努力,都集中在模型本身:要么重新训练,要么用新数据微调权重。Harness²从另一种定义出发:智能体等于模型加上它的harness,而harness是指模型之外一切塑造其行为的东西,包括指令、文件、工具、约束和配置。
在这种方法下,模型权重自始至终保持锁定,智能体唯一能改的就是自己的harness。由于不需要重新训练,既没有训练费用,也不会出现灾难性遗忘,即模型在学习新东西时丢失原有能力的倾向。
这个思路类似新员工的成长过程:第一天会犯错,于是记下笔记、整理出检查清单,第二天就能做得好得多。Harness²为智能体提供了同样的反馈循环。关键在于,智能体是对照任务的评判标准给自己的成果打分,全程看不到标准答案。
智能体可以改写的八个文件
该框架用八个模块化文件包裹模型,智能体可以修改的正是这些文件:
- 系统提示词:智能体开展工作的基础指令
- 护栏:智能体必须始终遵守的规则
- 记忆:从之前的工作中延续下来的笔记
- 工具指南:关于如何正确调用工具的说明
- 子智能体:承担部分工作的辅助智能体
- 技能:汇集特定领域诀窍的操作手册
- 脚本:智能体可以直接运行的代码
- 运行时插件:在任务运行过程中介入的附加组件
一轮自我改进如何进行
研究团队用一项财务工作来演示这个循环:智能体需要把发票、服务故障记录和订阅抵扣额核对后整理进同一个工作簿,过程中还要处理空白单元格和被重复计算的行。每一轮分为五步:
- 运行:智能体先用未经修改的原始harness完成一次任务。
- 提出:拟定两类修正方案。一类是对任何任务都应有帮助的通用习惯,另一类则包含该领域的专业知识。
- 验证:在保留任何改动之前,把每个修正方案单独放到同一任务上试一遍。
- 整合:只把证明有效的修正方案纳入最终的harness,然后由智能体重新完成正式交付物。
- 反思:智能体把学到的东西浓缩成一条经验,存入永久性的库文件,供之后的运行继承。
验证这一步最为关键。研究团队指出,如果不先在沙盒中逐一测试每项改动就贸然编辑harness文件,准确率往往会下降,智能体反而变得更差。找到需要修正的地方似乎只完成了一半工作,另一半是确认每项修正确实有效。
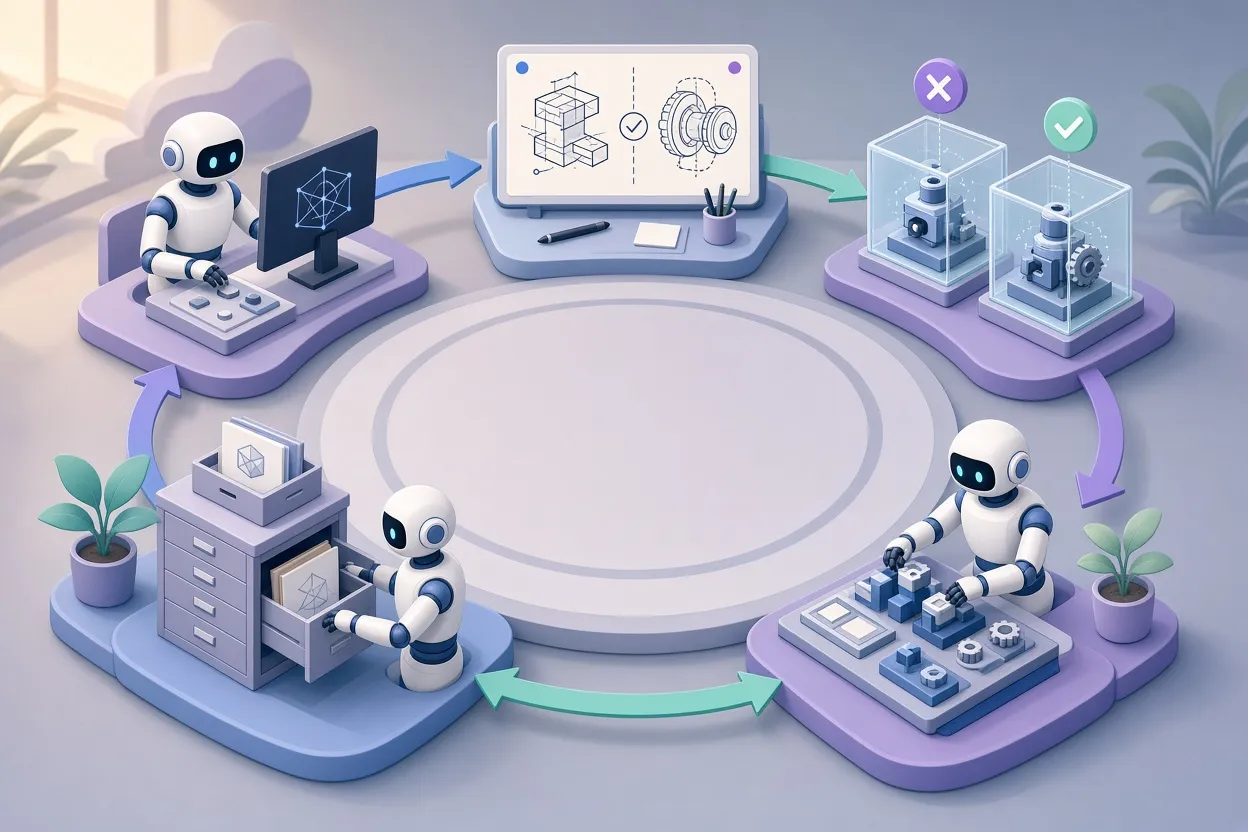
▲ harness改进的五步循环
用Gemini 3.5 Flash进行的法律审查测试
为了看看轻量级模型的表现,测试让Gemini 3.5 Flash完成谷歌官方基准测试集中的一项法律任务。案例涉及国际商会(ICC)框架下的仲裁。智能体需要审查第3号程序令草案,将其与之前的程序令和策略备忘录进行比较,并生成一份带批注的红线稿(标出所有拟议修改的修订稿),以及一封列明主要异议的信函。
首次尝试中,智能体通过了55项自动检查中的20项,得分36.4。随后它检查了自己遗漏的地方,修改了两个harness文件。一是新写了一份领域操作手册SKILL.md,要求逐行对照之前的程序令比较草案,并以结构化方式核查审理期限和证据规则。二是在systemprompt.md中加入一条条件指令,只要任务是仲裁审查,就加载这份手册。
| 指标 | 首次尝试 | 编辑harness后 |
|---|---|---|
| 通过的检查项 | 55项中的20项 | 55项中的22项 |
| 得分 | 36.4 | 40.0 |
| 运行时间 | 446.4秒(约7.5分钟) | 736.9秒(约12分钟) |
组装最终的harness用了45.0秒,整个调整与重跑周期的API费用约为$11。在3.6分的提升背后,有三项标准从未通过变为通过:与第一号程序令交叉引用、恢复4.5至5天的审理安排,以及删除一项标准费用条款。也有一项标准朝相反方向变化:一项与以苏黎世为审理地点相关的检查,在首次尝试中通过,第二次却未通过。
▲ 仲裁程序令审查测试
与论文结果的对比
把Gemini 3.5 Flash的结果放在论文数据旁边看,意义就更清楚了。
| 设置 | 改进前 | 一轮改进后 |
|---|---|---|
| 同一仲裁任务,前沿模型的最佳案例 | 44.4 | 94.5 |
| 论文全部法律任务的平均值 | 79.9 | 81.9 |
| 同一仲裁任务,Gemini 3.5 Flash | 36.4 | 40.0 |
使用前沿模型的最佳案例显示了一轮改进所能带来的收益,但在全部法律任务中,平均提升为2.0分。Gemini 3.5 Flash提升3.6分,接近这一平均趋势。比较合理的理解或许是:一轮改进通常能提高几分,而在harness明显有缺漏的任务上,偶尔会出现大幅跃升。
修改带来显著回报的五项任务
论文还介绍了修改harness后成绩大幅提升的案例。在每个案例中,模型都没有变化,改变的只是智能体的工作规则。
| 任务 | 智能体做出的修改 | 得分 |
|---|---|---|
| 核对电影制片人的预算备忘录 | 一条通用护栏,要求重新打开并核实其输出的每个数字 | 43.1到77.8 |
| 处理销售工作簿 | 一条技能指令,要求用加权平均计算衍生佣金率 | 23.6到100.0 |
| 构建可离线运行的单页网页应用 | 一条护栏,禁止从外部CDN获取代码,并把脚本、样式和数据内联 | 64.0到100.0 |
| 综合研究资料 | 一个运行时插件,在额度耗尽前强制尽早写出草稿 | 72.0到100.0 |
| 一项编程基准测试 | 严格的工具指南,禁止伪代码形式的工具调用 | 60.0到100.0 |
CDN即内容分发网络,是向网页提供脚本、字体等文件的外部服务。那项研究任务因为不断触及预算和上下文上限(模型一次能处理的文本量)而反复超时,于是智能体编写了一个名为deliverable_watchdog的插件。当token用量接近上限时,这个插件会停止进一步的检索查询,确保一定能写出草稿。token是模型处理文本的单位。在编程案例中,模型原本会以伪代码的形式输出虚假的工具调用,新的指南让它只使用有效的原生工具调用。
试用前需要了解的注意事项
Harness²以harness2代码仓库的形式发布在GitHub上,已获得约6,000个星标。不过,它是Google Cloud AI Research与美国西北大学的实验性学术代码,并不是谷歌正式支持的企业级产品。
部署需要一整套开发者工具:
从这份清单来看,缺少技术支持的业务人员目前还难以部署它。自我编辑也存在风险:正如苏黎世审理地点那项检查所示,修好某些问题的改动,可能会破坏原本正常的部分。此外,每轮循环都会增加时间和费用。在法律测试中,两次运行合计耗时近20分钟,单个任务花费约$11。
运营智能体的团队能从中学到什么
Harness²的核心启示是:模型可以保持不变,而智能体能通过周围的文件持续改进。这种方法看来最适合智能体每周都在执行可预测的重复性工作的团队,因为一次运行中得到的经验可以带到下一次。
即使不安装这个框架,自行运营智能体的团队现在也可以运用它的原则:
- 在更换模型之前,先在harness上投入精力,包括系统提示词、工具定义和护栏。
- 每次只在沙盒中测试一项提示词或技能的改动,只合并有效的改动。
- 把改进分成两类:一类是通用习惯,例如重新检查输出文件;另一类是领域知识,例如仲裁规范。
- 为长时间运行的研究型智能体配备看门狗,在token或时间预算耗尽之前强制生成粗略草稿。
- 让网页交付物自成一体,把样式、脚本和数据内联,使其无需CDN也能离线运行。
- 编写工具指南,禁止伪代码形式的工具调用,并要求使用原生调用格式。