如今,Claude Code约90%的代码由Claude编写。Anthropic介绍了工程师如何跟上这样的产出。答案并不是让更多人去读更多行代码。Anthropic不再把“是否有人读过这段代码”当作安全标准,而是换成两个问题:哪里可能出错,以及哪种自动或人工检查最能发现这类问题。由此形成的是一套五层审查:人工签核的力度随风险高低调整,快速回滚则是最后一道防线。6月至9月,Claude Code团队合并的拉取请求(即先经过审查、再并入代码库的代码变更提议)增加了一倍多,其中需要回退的比例下降了40%以上。对于把越来越多编码工作交给AI智能体的团队,这套设计看起来是一份有用的范本,但其中的数字和成本需要仔细解读。
逐行阅读为何行不通了
转变源于规模。2026年5月,Anthropic的主单体仓库(容纳多个项目的单一代码仓库)每天合并约2,500个变更;到了9月最忙的一天,这一数字达到30,401个。单个工程师的速度同样很快:2026年3月,Claude Code的创造者鲍里斯·切尔尼表示,他在多个终端标签页中并行运行五个Claude会话,每天交付20至30个拉取请求(PR)。按这样的节奏,由人逐行阅读每一处变更根本不可能。
因此,Anthropic把“有人读过”视为衡量质量和可靠性的一个不精确的替代指标。它现在的目标是让大多数PR在至多一人参与的情况下合并,而这个人可以就是作者本人。为了让这一目标名副其实,团队盯着两项指标:回退率和生产环境事故率。只要其中任何一项上升,团队就并没有节省时间,只是把审查代码的工夫转移到了事后收拾残局上。
五层“瑞士奶酪”
Anthropic把这套机制比作安全管理中的瑞士奶酪模型:每一层拦截不同类型的问题,而穿过所有层的漏网之鱼,则靠快速回滚的能力兜住。
| 层级 | 运行时机 | 作用 |
|---|---|---|
| 1. 自我验证 | 打开PR之前 | Claude运行测试、构建并比对截图,再由全新的辅助智能体检查变更 |
| 2. Claude Code Review | 每个新PR自动触发 | 多个智能体查找缺陷,另一些智能体投票判断哪些属实 |
| 3. 安全审查 | 自动 | 在每项发现被修复或驳回之前阻止合并 |
| 4. 持续集成(CI) | 自动 | 标准检查,外加写明测试与回滚计划的PR模板 |
| 5. 人工审批 | 视风险等级而定 | 零人、一人或两人 |
| 最后防线 | 合并之后 | 快速回退 |
第1层:在作者的会话中先行检查
第一轮审查在PR创建之前就已进行。在工程师自己的Claude会话中,Claude运行测试、构建应用,并截图与设计稿比对。随后,它把差异(即发生变化的代码行)交给一个子智能体。子智能体是从全新上下文开始工作的辅助智能体,不带有编写代码时的那段对话。
第2层:查找者与投票者
打开PR会触发Anthropic的自动审查工具Claude Code Review。若干“finder”智能体并行扫描变更,提出候选缺陷,例如“draft可能为null”“失去焦点时save()可能执行两次”“缺少await”“值未被使用”。接着,“voter”智能体判断哪些候选是真正的问题,只有这些才会成为审查评论。这样分工,是为了减少依赖单个智能体时出现的幻觉(言之凿凿的错误说法)和误报。
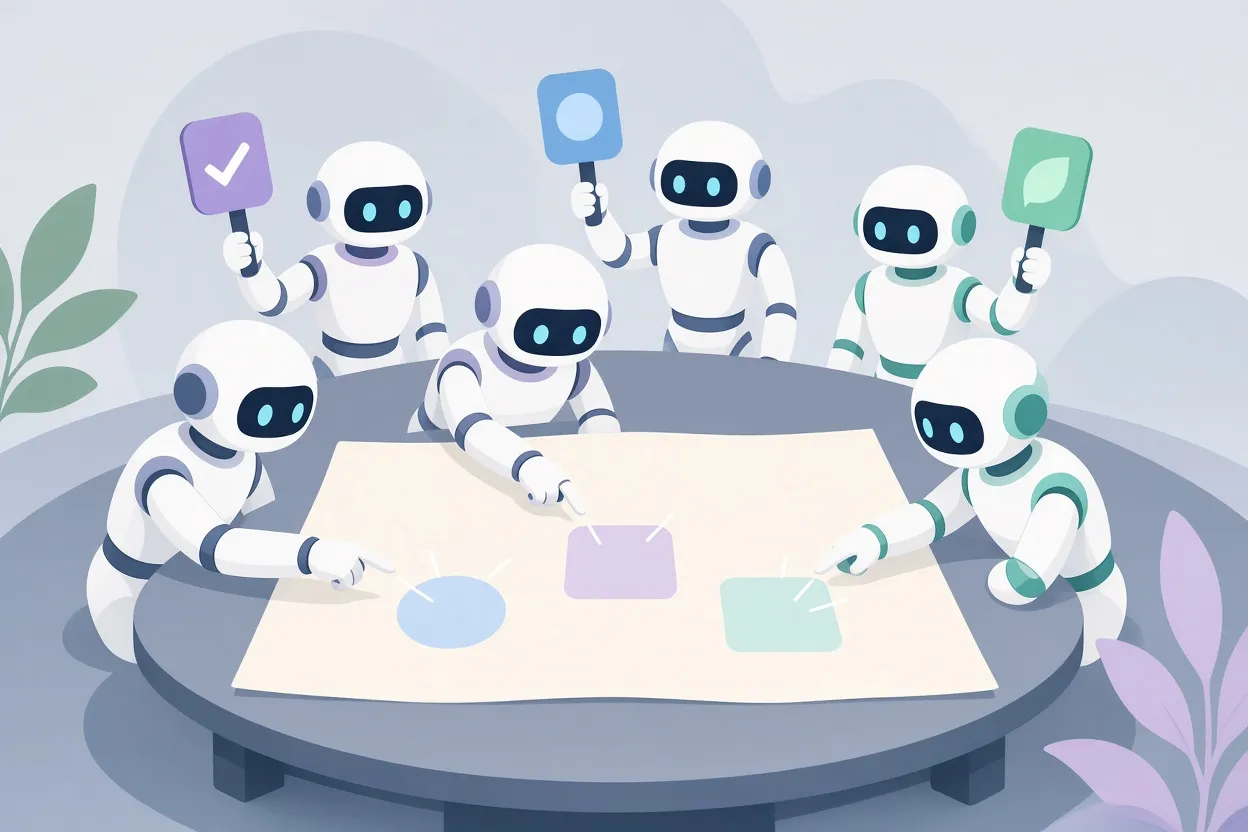
▲ 查找与投票的智能体
当Claude在许多PR中犯同样的错误时,工程师不会逐个手动修改PR,而是用代码检查规则(自动检查代码风格与正确性的规则)或在CLAUDE.md中加一行说明,从源头消除这种模式。CLAUDE.md是Claude Code在会话开始时读取的指令文件。例如,如果Claude总是调用过时的辅助函数legacyFormatDate,而不是现行的formatDate,团队可以添加一条禁止旧函数的ESLint规则,并把这一约定写进CLAUDE.md。
代码负责人还会编写一个REVIEW.md文件,告诉审查者在自己负责的代码部分中什么算失败、哪些内容可以忽略:
- 与事实不符的文档:README称
autoSave设置默认开启,而config.ts将其设为false。 - 指向错误的配置:
DATABASE_URL指向生产环境,而不是预发布环境。 - 可以跳过的文件:无需审查的自动生成客户端代码。
第3层和第4层:安全审查与CI
自动安全审查是一道硬性关卡。一旦发现漏洞,例如查询中未转义的输入,PR就无法合并,直到问题在新的提交中修复,或被标记为误报并写明理由。此后是标准的CI检查,即每次变更都会自动运行的构建和测试。每个PR还要遵循一份模板,写明变更如何测试、如何回滚。
第5层:按风险决定人工审批
只有到最后一层才由人正式签核,而签核人数取决于风险,而不是作者的判断。文档变更属于低风险,放在功能开关(让团队先发布代码、同时让新行为保持关闭的开关)之后的代码也是如此。
| 风险等级 | 典型变更 | 人工审批 |
|---|---|---|
| 低 | 文档、放在功能开关之后的代码 | 0人,前提是自动检查通过且作者受信任 |
| 中 | 普通产品逻辑、缓存等敏感部分 | 1人 |
| 高 | 安全关键路径、最高级别代码 | 2人 |
每个PR的风险等级由一个AI分类器判定,另一个独立的分类器再复核是否需要人工监督。
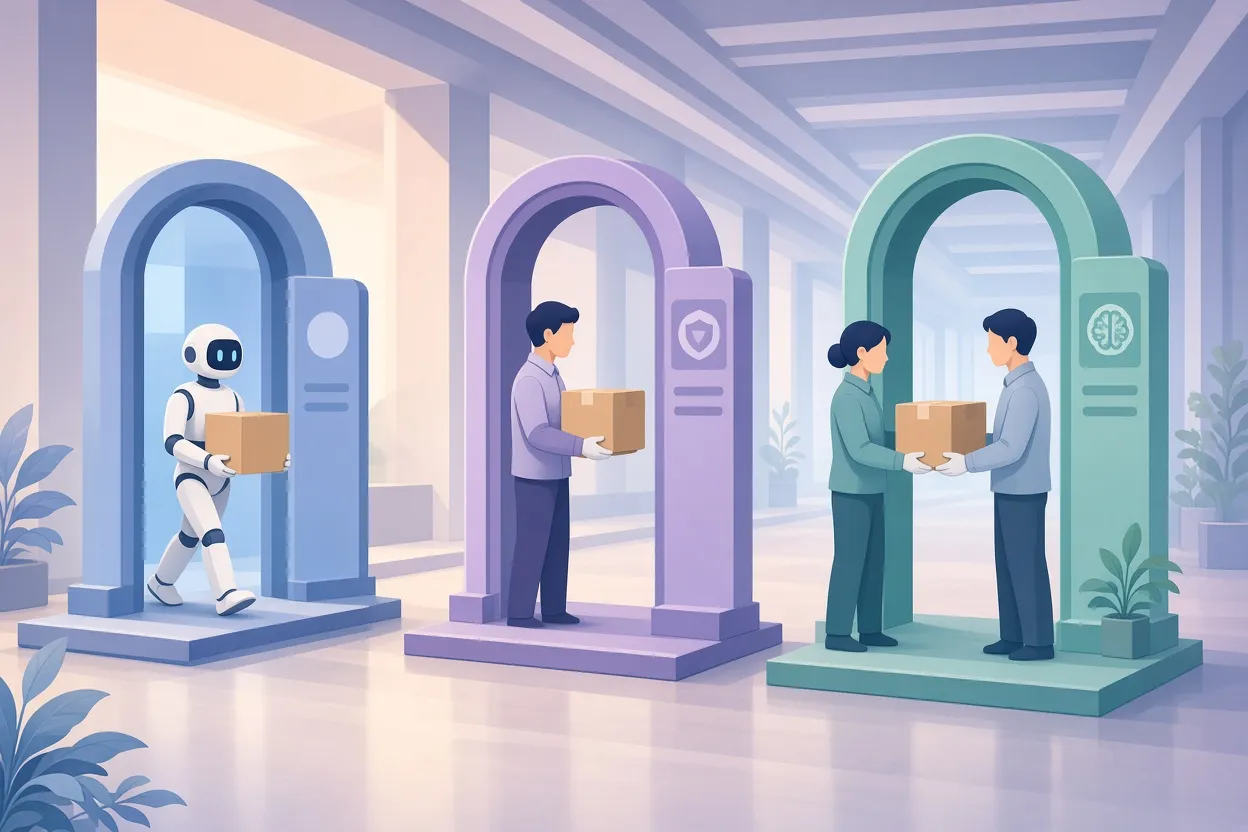
▲ 按风险等级的人工审批
每天测试审查者
自动审查者的价值取决于它的实际表现,所以Anthropic每天都对它进行测试。生产环境事故和回退会被转化为测试用例。熟悉相关代码领域的工程师先核实每个用例,再将其加入评估集,审查者每天都要接受全套用例的评分。针对审查者的提示词、工具或模型提出的修改,只有在总分提高时才会被采纳。
如果只按发现的缺陷数量评分,就会产生扭曲的激励:一个对每一行都提出意见的审查者看起来会非常出色。为此,Anthropic还会记录作者如何回应审查评论,从而衡量噪声并予以扣分。
当智能体审查智能体
当作者和审查者都是AI智能体时,就会出现一个新问题:审查可能永无止境。有一次,内部一个命令行工具的PR在一夜之间经历了50多轮审查和修复,直到一名工程师介入。分析反复出现的轮次后,Anthropic发现,被指出的问题中约59%针对的是第一轮审查时就已存在的代码,而不是最近修改引入的缺陷。换句话说,这个循环一直在翻旧代码,而不是在发现新缺陷。
三项改动解决了这个问题:
- 三轮上限。 三轮之后,系统会让作者智能体退一步,重新思考解决思路。
- 只审查差异的后续轮次。 之后的轮次只审查自上一轮以来发生变化的代码行。
- 按缺陷类别标记。 如果“user可能为null”同时出现在
api.ts、form.ts、list.ts和menu.ts中,审查者会一次性报告这四处,作者智能体便能在一次提交中全部修复。
| 指标 | 改动前 | 改动后 |
|---|---|---|
| 一轮即通过的PR | 65% | 78% |
| 需要五轮或以上的PR | 8.9% | 1.5% |
| 通过所需的平均轮数 | 2.08 | 1.32 |
两点提醒:回退与成本
醒目的回退数据值得再看一眼。被回退的PR占比下降40%,听上去是明显的进步,但同期PR数量增加了一倍多。数量翻倍、回退率降至原来的60%,按绝对数计算,回退次数反而增加了约20%。占比下降本身并不意味着出问题的次数变少,因此还应同时查看绝对数。
另一点是成本。Hacker News上的评论指出,Anthropic之所以负担得起大量消耗token的多智能体审查,是因为它内部有充裕的token(AI模型处理文本的基本单位)。由于模型是自己的,它可以针对一个PR调用模型数十次。外部客户使用Claude Code Review,平均每次审查要花$15-25。对一般企业或独立开发者来说,规模一大,这笔开销可能就难以说得过去。
留给人的部分
这些机制都没有把工程师排除在流程之外,而是把他们转向机器不擅长的决策:系统架构、权衡证据、判断某个功能到底该不该做,以及审查最关键的代码。
Anthropic的问责原则是“You land it, you own it”,即谁合并,谁负责。合并变更的工程师,要在它于生产环境中出问题时负责调试和修复。遥测(关于软件在生产环境中运行情况的自动采集数据)、快速回退和功能开关,让这种责任落到实处。AI可以缩短编写和审查代码的时间,但运维责任仍然完全由工程师承担。
团队可以借鉴的做法
要运用其中的核心理念,并不需要Anthropic那样的规模或token预算:
- 让CLAUDE.md保持简短。 把反复出现的规则交给代码检查工具和自动化测试,而不是写出越来越长的指令。
- 编写REVIEW.md。 告诉审查者每个目录中什么算失败,以及哪些文件可以跳过。
- 给审查循环设上限。 智能体之间的审查在三轮后停止,此后只看新的变更,并一次性标记同类缺陷。
- 让人工审批与风险挂钩。 在高风险、涉及安全或涉及架构的变更上,绝不把机器人的批准当作人的批准。
- 从两个角度追踪回退。 既看占比也看绝对数,并让合并变更的人对其负责。
在推行自动审查之前,先按自己的PR数量估算每个PR的审查成本。减少人工审查的目的是节省时间,而不是把这些时间转移到事故处理上。