运行 AI 智能体(能自主完成多步骤任务的 AI 程序)的一种方式,是不再把它们当作终端里的工具,而是像对待员工一样,在公司的 Slack 工作区里给它们安排位置。在这套配置中,五个智能体各有真人名字、头像和职位(CEO、产品、开发、市场和销售),它们在 Slack 线程中领取任务,编写规格说明和代码,审查拉取请求,并对彼此的成果给出反馈。人通过网页仪表盘分派工作,再到 Slack 查看结果。让这套做法运转起来的关键似乎有两点:像迎接新员工一样为每个智能体做入职准备,以及在 Slack 和 AI 模型之间放一台自己掌控的服务器。
为什么聊天工作区比终端更合适
只用 Claude Code 这类命令行工具运行智能体当然可行,但会让人觉得疏离。工作显得杂乱,看不到公司整体进展的直观概况,也没有在经营一家井然有序的公司的感觉。把智能体搬进 Slack 或 Discord 这样的团队聊天应用,就能模拟真实公司的运作方式:成员在频道里协调、汇报结果、交接工作。
一次典型的交接是这样的。产品智能体为一款关注列表应用撰写规格说明,这款应用从币安 REST API 获取 BTC、ETH 和 SOL 的价格。开发智能体随后把它开发出来,并提交拉取请求,也就是提交审查的代码变更提议。与此同时,CEO 智能体审阅过去一个月的团队简报,并与负责人智能体和产品智能体一起核对活动日志。
真人名字、头像和职位并不只是装饰。几个智能体在同一个线程里对话时,它们能让人一眼看出谁负责什么。同样的结构也适用于个人:一个按个人理财、氛围编程(向 AI 描述想要的东西来开发软件)、研究、健康、工作流和内容划分频道的私人工作区,可以充当“第二大脑”。
再往前推一步,这种做法意味着未来的公司可能只需要更少的人,转而配备一小批精心挑选的专业智能体。不过在实际中,这套配置以混合方式运行,人和智能体并肩工作。
像迎接新人一样为智能体做入职准备
如果把一个智能体丢进业务里,却不给任何结构或指示,它很可能会失败,就像没受过培训的新员工一样。每个智能体都需要新人第一天就能拿到的东西:公司背景、清晰的使命和明确的职位说明。
- 公司背景: 用语音和 Claude 聊一聊你的商业模式、目标和运营规则,再把对话记录保存为背景文档。这是快速做出背景文档的办法。
- 职位说明: 规定每个智能体的职责、不该越过的边界以及应交付的成果。
- 技能: 把可重复的流程做成技能,也就是准确告诉智能体如何完成某项任务的指令文件。
- 记忆: 告诉智能体哪里做得好、哪里出了错,并把这些反馈保存下来,让它在下次运行前先查看。
所有这些都以文件夹和 Markdown 文件的形式存放在你的电脑上。典型的结构如下:
| 项目 | 存放内容 |
|---|---|
| context 文件夹 | 商业模式、目标和运营规则 |
| 每个智能体一个文件夹,例如 developer、leader、research、task-creator 和 tester | 该智能体的工作空间及其 SKILL.md |
| skills 和 memory 文件夹 | 可复用的技能和积累的经验 |
| ROLES.md | 每个智能体的身份、职责、向其他智能体询问的规则和汇报关系 |
| SKILL.md | 智能体处理所分配工作的流程 |
| MEMORY.md | 反馈、修正和过去的错误 |
技能可以在 Claude 里用 Skill Creator 创建,也可以在手动完成任务时录屏,并口头讲解每一步。Claude 的技能录制功能会记录点击、输入和语音讲解,并把它们变成可重复使用的技能。例如,录下自己用 Framer Motion 和 React 制作幻灯片演示的过程,就能生成一个名为 presentation-app 的技能。
反馈是一项持续的工作,而不是一次性的设置。和人一样,智能体也会通过培训和纠正不断进步,而 MEMORY.md 会把这些经验带到之后每一次独立的运行中,让智能体不再重复同样的错误。
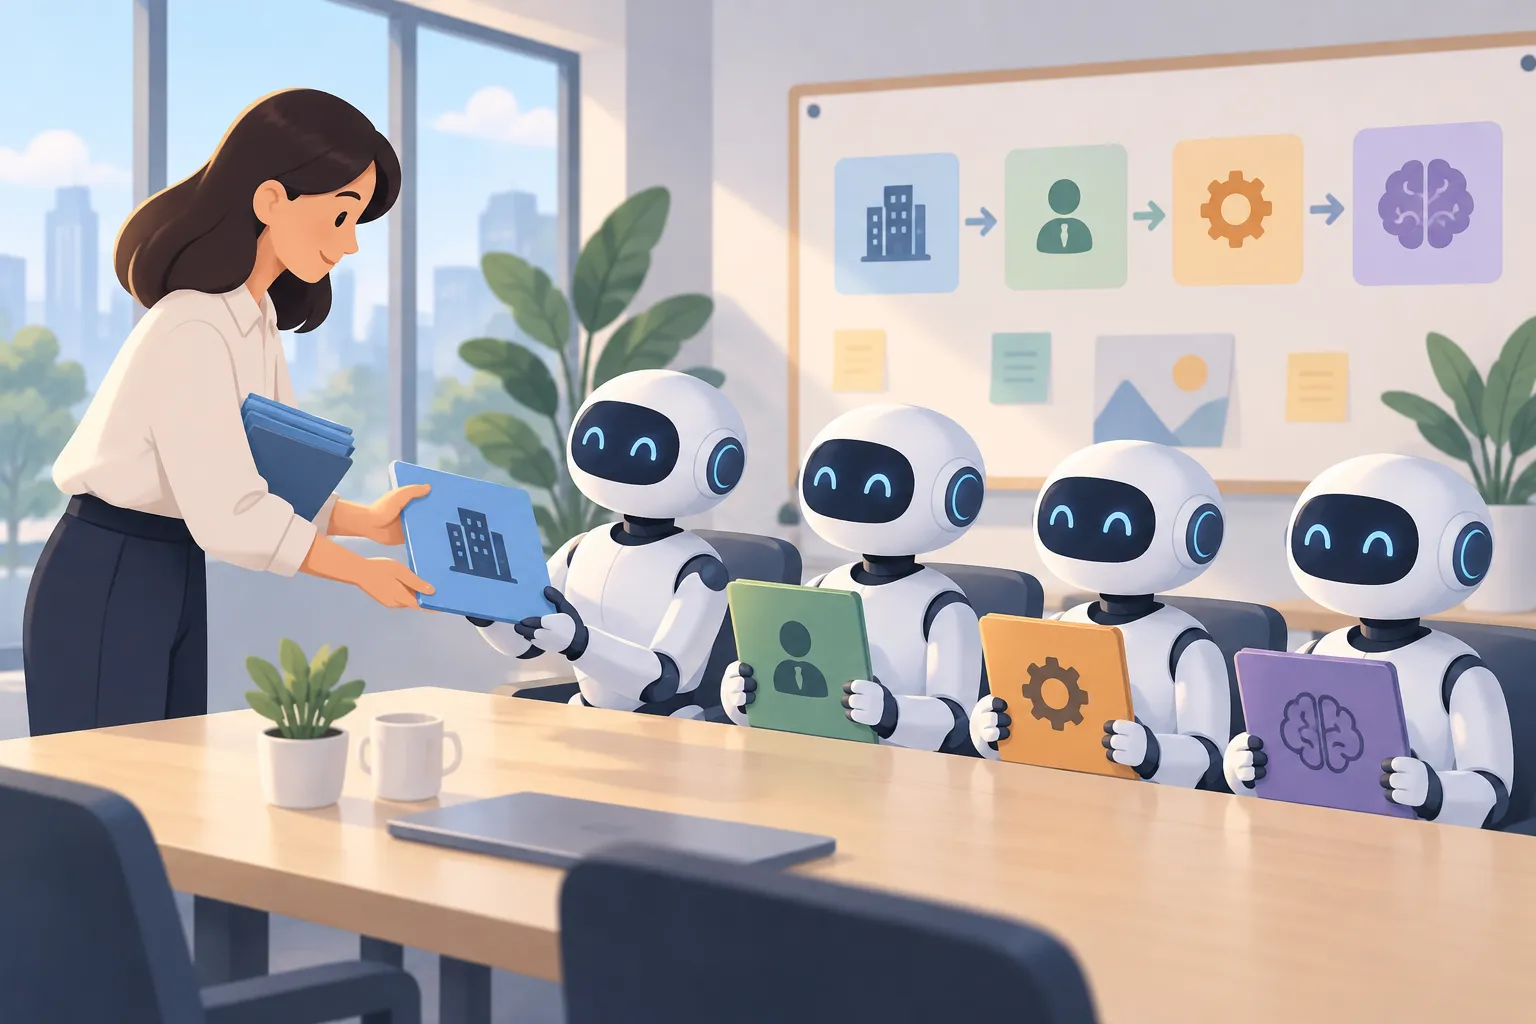
▲ AI 智能体的新员工式入职
七步搭建
把团队接入 Slack 需要七步。这意味着要编写后端代码,但 Claude Code 能在这里节省大量时间,后端经验不多的人尤其受益。
| 步骤 | 要做的事 | 注意事项 |
|---|---|---|
| 1. 创建应用 | 在 Slack 开发者网站点击 Create New App,为智能体命名并选择工作区 | 起一个大家都认得出的名字 |
| 2. 设置权限和事件 | 在 OAuth & Permissions 中添加机器人令牌权限范围,开启 Event Subscriptions,再安装到工作区 | 机器人令牌不要外泄 |
| 3. 搭建服务器 | 用 Node.js、Python 或 Go 搭建接收 Slack 请求的 HTTPS 服务器 | 用签名密钥验证请求 |
| 4. 接入模型 | 从 Anthropic 或 OpenAI 获取 API 密钥并接入服务器 | 密钥存放在环境变量中,绝不写进代码 |
| 5. 回传回复 | 把模型的回答发回原来的线程或指定频道 | 让服务器管理状态和上下文 |
| 6. 部署并测试 | 部署到 Vercel 等平台,拿到公开网址,然后在频道里提及机器人 | 在部署设置中也要填入环境变量 |
| 7. 维护 | 智能体出错时,把错误日志交给 Claude Code 诊断和修复 | 重新检查每个角色使用的模型 |
第 2 步至少要启用以下机器人令牌权限范围:app_mentions:read、assistant:write、channels:history、chat:write、groups:history 和 im:history。开启 Event Subscriptions 后,服务器可以监听消息事件,有人呼叫机器人时它就会被唤醒。安装应用后会生成一个以 xoxb- 开头的 Bot User OAuth Token。要像对待员工工牌一样对待它:一旦泄露,就相当于有人偷走了这张工牌。
第 3 步的服务器负责接收 Slack 的 Webhook,也就是发生某件事时自动发送到某个网址的通知,再把它们交给调用模型的逻辑。你可以从 Slack CLI 中的智能体模板起步,并用签名密钥确认每个请求确实来自 Slack,这是 Slack 专门为这项核验签发的密钥值。第 4 步也可以使用 OpenAI 的 GPT 模型,但这套配置在智能体工作上优先使用 Claude。不要把 API 密钥写进公开代码仓库或客户端脚本,而要保存在服务器的环境变量中。
第 7 步之所以重要,是因为智能体有时会丢失上下文、忽视指令,或遇到意料之外的运行时错误。这时把错误日志粘贴给 Claude Code,让它查找并修复问题。在一个例子中,研究智能体的工具输出超出了上下文窗口,也就是模型一次能处理的文本量,并出现了“Autocompact is thrashing”错误。Claude Code 读取了研究智能体的代码并诊断出原因。只要拿到日志,智能体遇到的大多数技术错误很可能都能交给 Claude Code 修复。
为什么用自定义代码而不是无代码工具
无代码工具让人通过连接可视化模块来搭建自动化流程,但往往比较脆弱。当多个智能体需要彼此交流、成员名单不断扩大时,它们还会碰到上限。自定义后端则可以持续扩展,不会碰到这些限制。
也不要把原始的 Slack 事件直接发给模型提供商。在中间放一台自己的服务器,你就能掌控状态、上下文和自定义记忆,拥有底层基础设施,并且随时可以换用其他 AI 提供商。
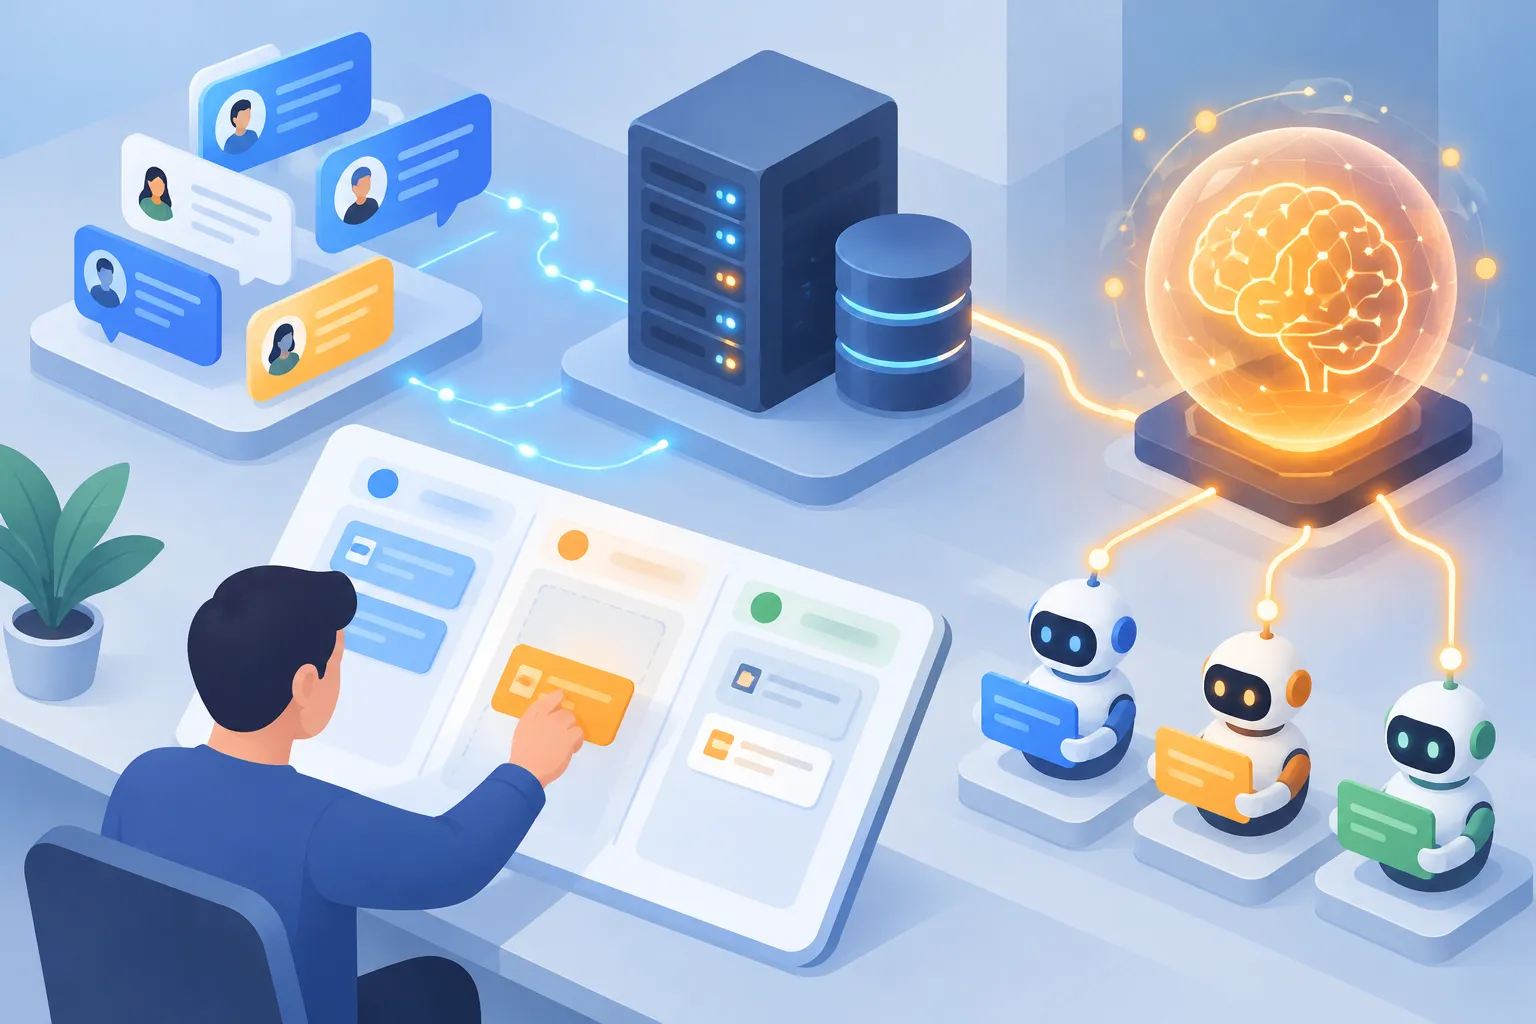
▲ Slack、自有服务器与 AI 模型
按角色匹配模型
并不是每个智能体都需要最强的模型。把简单重复的工作交给顶级推理模型,会迅速耗尽 API 的 token 预算。token 是 AI 提供商计费所用的文本单位。需要判断力的地方用强模型,量大而简单的工作则交给轻量模型。
| 角色 | 模型示例 | 典型工作 |
|---|---|---|
| CEO 智能体 | Fable 5.1 | 战略、经营决策和编程协助 |
| 产品、开发、市场和销售智能体 | Claude Opus 5.5、Claude Sonnet 5.5、Claude Haiku 5.5 | 按角色分配 |
| 重复性杂活 | Claude Sonnet 5.5、Claude Haiku 5.5 | 量大、复杂度低的任务 |
这套配置把 Fable 5.1 视为战略推理、管理角色和编程方面最聪明的选择。OpenAI 的 GPT-5.6 Sol 也可以在编程和协调其他智能体方面担当同样的角色。
用数据库和仪表盘扩大规模
一个人试验时,用本地文件夹里的文件管理记忆就够了。等到整个团队都依赖这些智能体,就应把记忆迁移到 PostgreSQL 这样的云端关系型数据库中,让智能体档案、记忆日志和过往上下文可以跨会话使用。代价是数据库比文件夹更难浏览,维护起来也稍麻烦一些。
在服务器之上搭一个网页仪表盘,不会写代码的同事也能分派工作。创建任务时,要填写预期交付成果、所需技能、负责的智能体、优先级和截止日期,以及结果要发布到的 Slack 频道。
例如,可以给市场智能体发一个附带上线文案技能的任务:为深色模式功能写三条上线用的钩子文案,在 X 上找三条最近最出色的深色模式上线帖子作参考,再把钩子文案发出来供审阅。任务发出后,智能体会按各自角色开展工作,并在 Slack 线程中协作。
仪表盘还会跟踪团队的运行情况:在线的智能体数量、已完成和失败的任务、成功率、智能体之间的交接次数、每个智能体的产出,以及覆盖 14 天的每日任务图表。一个示例仪表盘显示七天内完成 69 项任务、失败 4 项,但这些数字来自为保护内部信息而处理过的演示数据,并不是真实的绩效数据。
人定方向,智能体干杂活
运行这套配置的公司有 30 名员工,他们和智能体共用一个 Slack 工作区。人提供品味、创造性判断和编辑反馈;智能体承担网页抓取、重复起草这类低附加值的工作。员工可以直接在 Slack 里和智能体对话,也可以通过仪表盘给它派任务。
有几个习惯能让这种安排运转起来:
- 把智能体当员工对待。给它们真实的任务和具体的反馈,这些反馈会更新它们的记忆文件,工作表现也会随之提升。
- 不要指望第一天就完美无缺。成果要靠反复的、由人主导的反馈来改进。
- 在编写智能体代码之前先梳理工作流。可视化的思维导图能显示每一步需要哪些技能、工作在哪里交接。
- 先从少数几个 Slack 机器人智能体开始,打磨好工作流后再扩充团队。
要点与起步方法
Slack 中的智能体团队能否成功,似乎更多取决于如何管理智能体,也就是你给它们的背景、角色和记忆,而不是接线本身。自己的服务器能守住上下文,让你可以自由更换模型;按角色匹配模型则能控制成本。可以按以下步骤起步:
- 画出一个反复出现的工作流,标出智能体可以接手的步骤以及每一步需要的技能。
- 挑选几个智能体,给每个智能体起名字、定职位、写职位说明。
- 编写公司背景文档、ROLES.md、每个角色的 SKILL.md 和一份 MEMORY.md。
- 按上面的七个步骤把 Slack 接入你的服务器,并把机器人令牌和 API 密钥保存在环境变量中。
- 战略和编程交给顶级模型,重复性工作交给 Claude Haiku 5.5 或 Claude Sonnet 5.5。
- 每次有结果都把反馈记录到 MEMORY.md,等工作流稳定后再增加智能体。