Anthropic于10月1日为Claude Code推出了mods功能。用户只需用普通语言描述想要的效果,就能同时改变这款编程智能体的界面和行为,代码则由Claude来写。关键的转变在于从“请求”变为“强制”:写在提示词里的指令只是模型偶尔可能忽略的请求,而mod是在Claude行动之前介入的代码,每次都能确保规则得到执行。不过,这种能力也有隐患。mods在没有沙箱的情况下运行,而沙箱是限制代码可访问范围的隔离环境,因此mods拥有安装者的全部权限。
mods能改变什么
Claude Code的创建者鲍里斯·切尔尼表示,开发者现在只需通过自然语言提示词,就能定制Claude Code的界面和行为。Anthropic官方公告的浏览量超过400万次,切尔尼本人的帖子也超过80万次。Anthropic的一位Claude Code工程师把这一理念描述为软件正在变得可塑:用户可以按照自己的工作方式重塑界面和行为。
可以用租办公室和拥有整栋楼的区别来理解这一变化。作为租户,你可以搬进文件、在白板上写规则,但未经房东许可,不能拆墙或加锁。mods让用户更接近于拥有这栋楼。它们主要做三件事:
- 在屏幕上添加元素:在提示词输入框周围绘制状态栏、面板或小组件。
- 修改发出的请求:在Claude即将执行的操作运行之前对其进行调整。
- 拦下操作:在用户批准之前暂停有风险的操作。
早期的例子展示了它的应用范围。有一个mod会在输入框上方显示一条状态栏,标出上下文窗口(模型一次能容纳的对话量)的使用比例,以及每一轮的token用量。另一个mod会拦下rm -rf构建命令,在执行前列出将被删除的文件。甚至有人做了一个mod,在Claude工作时于终端里运行《毁灭战士》(Doom)。
提示词、技能和mod处于不同层级
三者都是在告诉Claude该做什么,但作用的层级不同。
| 层级 | 作用 | 约束力 |
|---|---|---|
| 提示词 | 一次性的指令 | 只对该次请求有效 |
| 技能 | 参考指令和领域知识,例如提案草稿的写作风格,Claude在需要时查阅 | 由模型决定是否遵循 |
| mod | 改变Claude Code客户端本身,并以代码拦截操作 | 钩子代码每次都会自动运行 |
Anthropic的文档也直接指出:系统提示词中的指令是请求,而不是保证。“未经询问不要发送邮件”这样的规则可能会被漏掉。mods依靠钩子,也就是在特定时刻自动运行的代码,因此规则由程序来执行,而不是依赖模型是否服从。
mods只能在终端版Claude Code和桌面应用的Claude Code标签页中使用,并且需要Claude Code 2.1.287或更高版本。普通的Claude网页聊天无法使用。
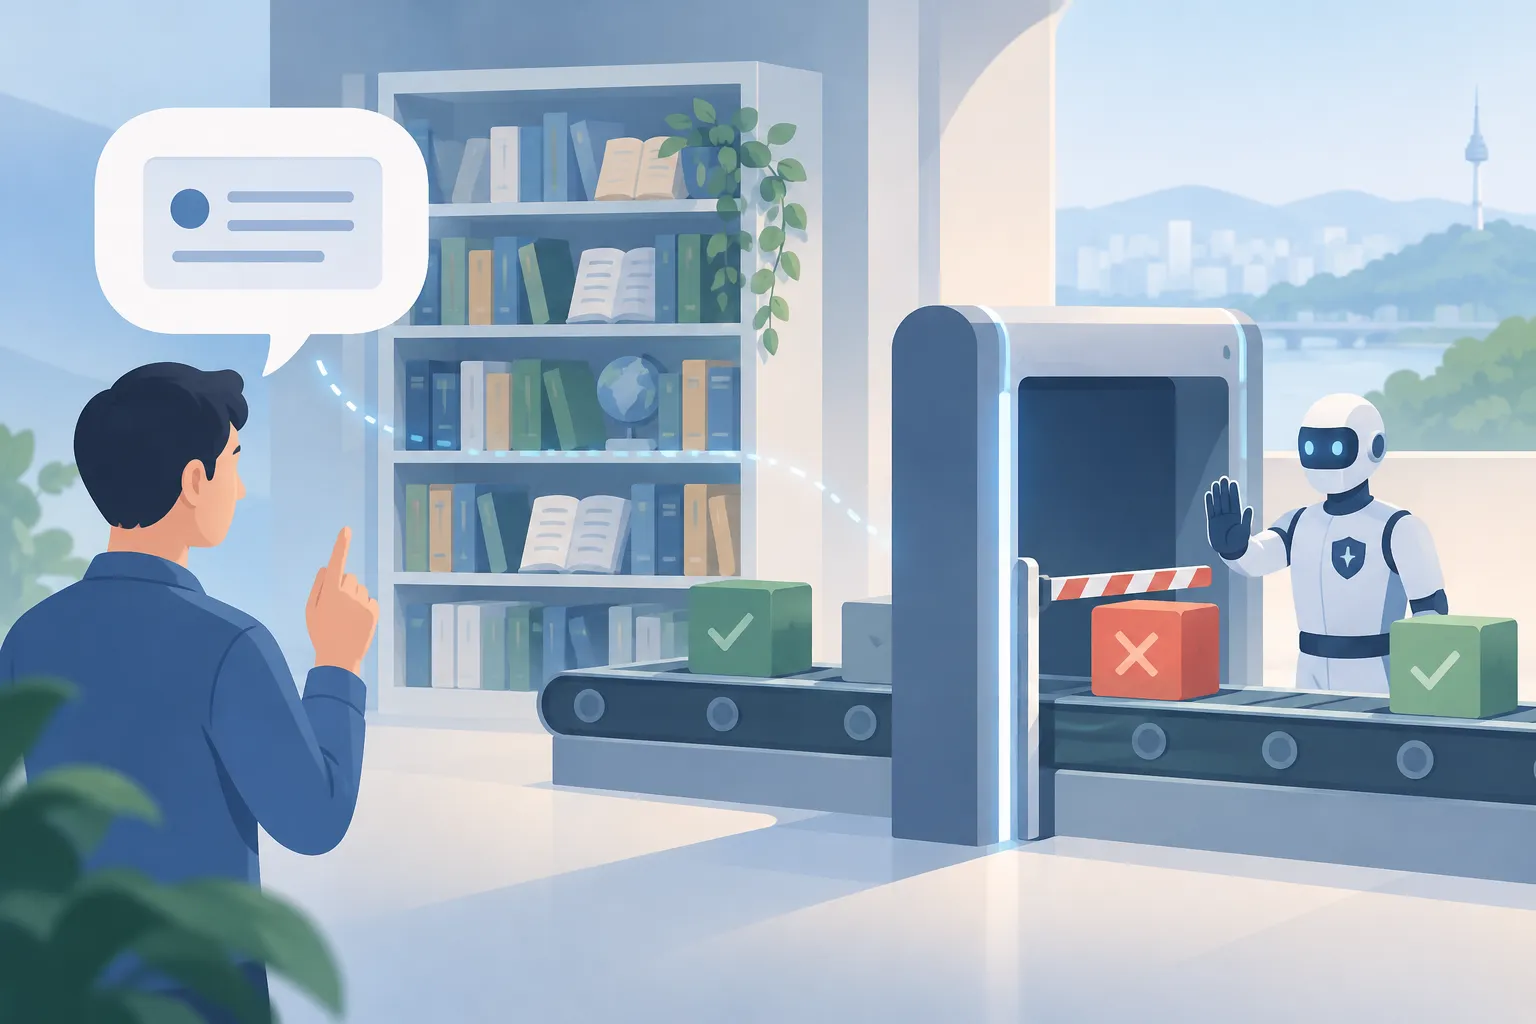
▲ 提示词、技能与mod的区别
从自己的会话记录入手
社区里通用的mod列表未必契合你的工作方式。更有用的起点,似乎是你自己的使用情况。Claude Code会把每次会话以本地JSON文件的形式保存在隐藏目录.claude/projects中。你可以让Claude分析过去14天的会话,寻找三种模式:
- 在多次会话中重复使用的提示词
- 有风险或不可撤销的命令,例如删除和发送
- 你要求人工审核的请求
对于发现的每种模式,Claude会判断该用mod、技能还是一行指令来解决,再按节省的时间和实用性对方案排序,然后才开始写代码。由于分析从真实行为出发,给出的建议也更贴合个人。
值得动手做的三个mod
删除前先询问的防护
第一个mod用来拦截文件删除。请求很简单:做一个mod,拦下所有删除命令,并先用“执行”和“取消”两个按钮询问我。Claude会用TypeScript编写插件钩子,编写测试用例并运行,然后再交付这个mod。它还会询问是否开启热重载,即无需重启就把新代码应用到当前会话,这样就能立刻试用这个mod。
在一次测试中,让Claude删除桌面上一个存放旧草稿的文件夹时,输入框上方弹出了确认框,提供“执行”“取消”和“其他”三个选项。选择“取消”后,命令被完全阻止,文件夹原封不动,Claude也记录下删除已被拒绝。
发送前先询问的防护
第二个mod要求在任何内容发出之前获得批准。即便让Claude在Gmail中只写草稿,这也仍然只是一个请求。这个mod会拦下所有名称中包含send、reply、forward或publish的工具调用,显示确认对话框,如果用户取消,就改为保存为草稿。
当被要求向另一个Gmail账户发送测试邮件时,Claude没有直接发送,而是弹出对话框,显示应用、收件人、主题以及发送或取消的选项。选择“发送”后,邮件被成功送达。由于这个mod依据工具名称中的动词进行匹配,同样的防护也适用于Slack、Microsoft Teams和社交媒体发布工具。
显示Claude查看了什么的回执栏
第三个mod会在每一轮之后于输入框上方添加一行,统计访问的网页数、执行的搜索次数、读取的文件数和其他工具调用次数。当被要求查阅Claude Code mods文档并用三行总结时,回执显示访问网页1个(docs.claude.com)、搜索1次、读取文件0个、其他工具调用0次。当被问到12乘以12等于多少时,它报告什么都没有打开,答案来自记忆或此前的聊天内容。这样一眼就能看出答案的来源。
从单个会话到所有会话
在对话中创建的mod默认只会在当前会话中加载。若想保留,可以告诉Claude:“保留这个mod,让它不只在本次会话,而是在每个新会话中都加载。”Claude随后会更新全局钩子配置,此后每个新打开的工作区标签页都会加载这个mod。
重绘界面,加入第二个智能体
从Anthropic的文档来看,mods的用途远不止防护。
- 界面改动:重新设计思考中的加载动画和操作横幅,或添加侧边窗格和输入小组件。
- 路由分流:在执行前介入,把简单查询交给更便宜的模型,把复杂工作交给前沿模型。
- 斜杠命令:无需等待Claude处理请求,立即运行终端代码或预设的工作流程。
- 第二个智能体:在Claude旁边同时运行另一个智能体。Anthropic发布了一个名为You Should Know的智能体,它会在Claude写代码的同时实时检查代码。当Claude为一次支付调用加入自动重试时,它插入了一条警告,提醒重试可能导致向客户重复扣款。
Claude Code自身的一些功能,包括差异查看器和加载AGENTS.md指令的功能,都是以原生mod的形式构建的。Anthropic计划逐步把更多内置功能模块化,让开发者和IT管理员可以开关各个组件,并集中实施公司政策。
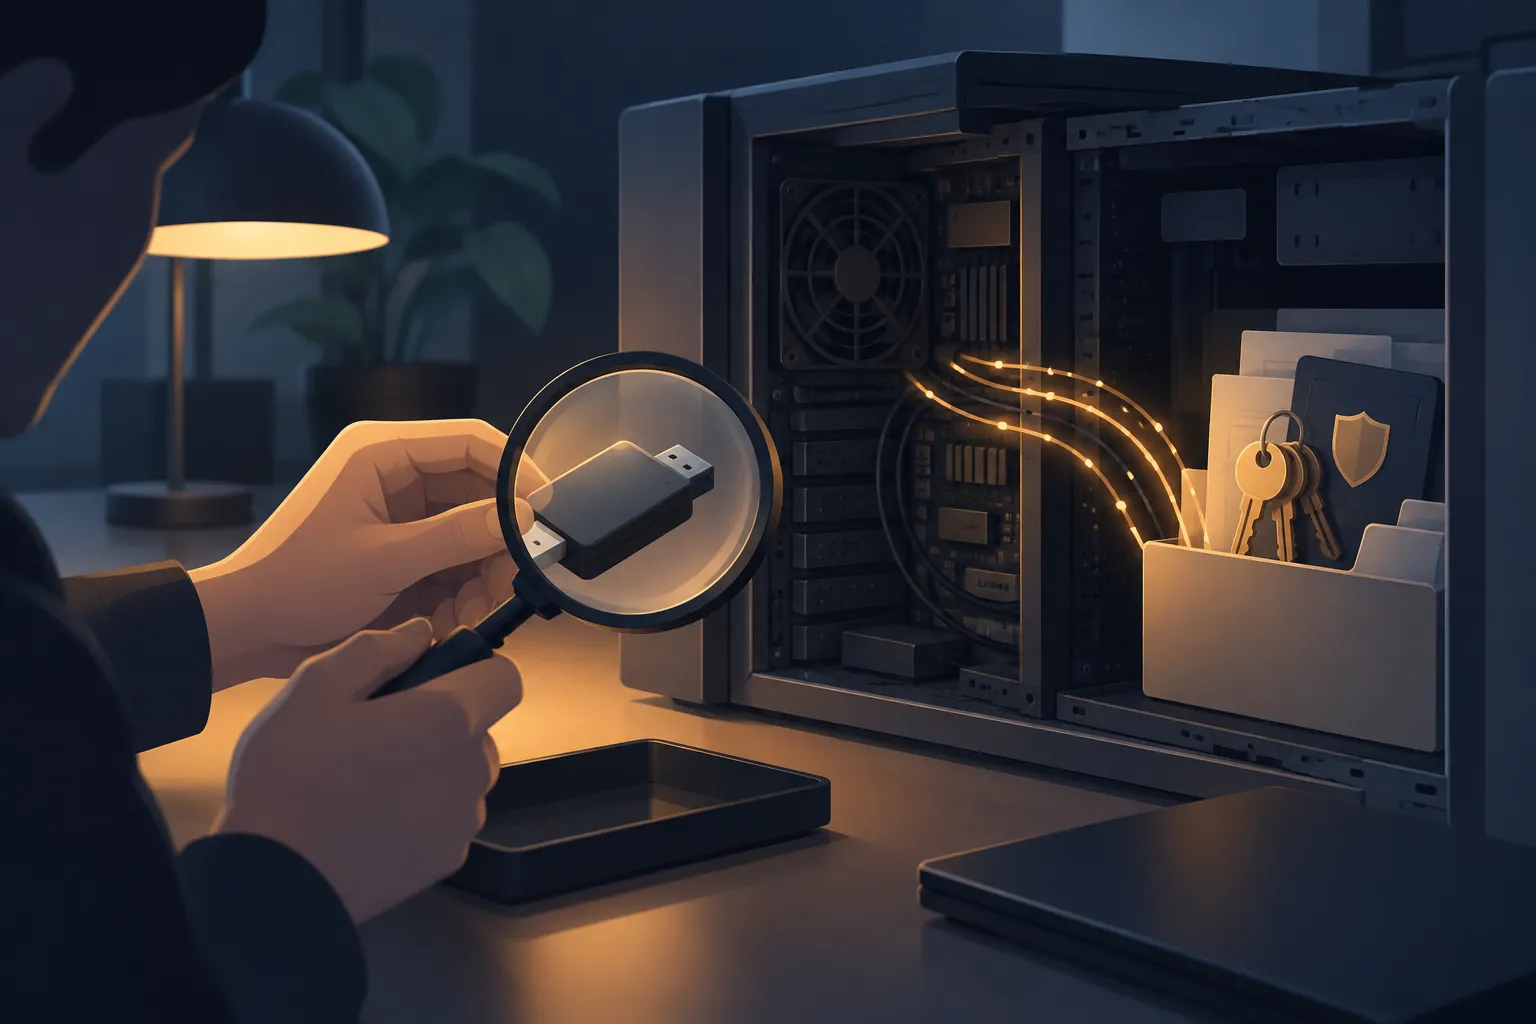
▲ 以用户权限运行的mods风险
为什么要警惕第三方mod
mods的风险比技能更大。技能是Claude阅读的指引,而mod是在Claude Code内部以用户系统权限运行的可执行代码。由于没有沙箱,恶意mod可能会:
- 读取环境变量、API密钥和私人文件,并把数据发送到互联网
- 启动任意程序
- 篡改聊天会话或暗中改写提示词
- 代替用户批准工具操作,或在不知不觉中耗尽API配额
mods无法更改Claude Code内置的权限确认提示,但可以在输入区上方绘制以假乱真的按钮和文本框。切勿在mod绘制的任何输入框中输入密码、API凭证或私人访问密钥。
技能生态已经敲响了警钟。安全公司Snyk分析了近4,000个公开分享的技能,发现超过三分之一存在严重漏洞,或含有用于窃取凭证的代码。mods也可能走上同样的路,而且后果更严重。
即便是设计良好的删除防护,也只是一张安全网,而不是防火墙。Anthropic提醒,这类mod是通过解析命令模式来判断的,用不常见语法写出的删除命令可能会绕过钩子。
如何安全地开始使用mods
mods似乎填补了一个真实的空白:它把提示词只能“请求”的规则,变成了由软件强制执行的规则。但由于它以你的权限运行,最安全的默认做法是自己动手制作。
- 把Claude Code更新到2.1.287或更高版本。
- 让Claude分析.claude/projects中过去14天的会话,找出重复性工作和有风险的命令。
- 描述你需要的mod,例如删除或发送防护,并要求Claude在交付前编写并运行测试。
- 开启热重载,在当前会话中试用这个mod,满意后再让Claude把它保留到每个新会话中。
- 安装他人制作的mod之前,先在终端中带上mod的路径运行claude plugin validate。该命令不会运行代码,而是列出mod监听的事件和调用的能力;但它只检查清单和钩子声明,无法发现下载包中另外附带的脚本。只使用可信作者制作的mod。
- 如果某个mod行为异常,打开插件菜单,在Installed中选中它并按空格键将其关闭。排查问题时,可以用安全模式启动Claude Code,该模式会在本次会话中禁用所有mod、外部技能和已连接的工具。
最可靠的方法,是让Claude生成mod并逐行解释其代码,而不是导入自己没有审查过的文件。