谷歌DeepMind的Gemma 4如今可以在普通网页浏览器中直接回答复杂请求,完全不需要调用服务器。由于模型在用户自己的设备上运行,数据不会离开本机,也没有API费用,更无需等待网络往返。Gemma 4采用宽松的Apache 2.0许可证发布,共有五种规格,从小到可以装进手机的2B模型,到单张GPU即可容纳的31B模型。对开发者来说,本地推理已经从一项实验变成切实可行的设计选择。
每周都在发布新品的研究机构
谷歌DeepMind将其使命定为以负责任的方式构建造福人类的AI。这一使命涵盖蛋白质结构预测系统AlphaFold、面向医疗和生物学的开放模型Med-Gemma等科学项目,以及数学和机器人领域的研究。在推进研究的同时,谷歌保持着很快的发布节奏,前沿模型、开放模型和平台API每周都有更新。
近期面向开发者的发布包括:
- Computer Use API:用于“计算机使用”的API,即让AI模型直接操作计算机
- Managed Agents:接收自然语言形式的高层指令,并将任务交给一组在沙盒化Linux工作站中运行的自主智能体(能够自行规划并执行任务的AI系统)的功能
- Speech-to-Speech translation API:将一种语言的语音直接转换为另一种语言语音的API
在这条产品线中,云端托管的Gemini模型处于前沿一端;Gemma 4则覆盖另一端,即开发者自行下载、自行运行的模型。
五种规格,一份宽松许可证
Gemma 4是一个开放权重模型系列,也就是说,谷歌公开了训练好的参数,任何人都可以下载。Apache 2.0许可证允许商业使用、修改以及微调(即针对特定任务对模型进行进一步训练),且无需支付许可费用。
| 模型 | 架构 | 适用场景 |
|---|---|---|
| 2B (E2B) | 小型 | 手机和浏览器 |
| 4B (E4B) | 小型 | 手机和笔记本电脑 |
| 12B | 中型 | 普通开发者笔记本电脑 |
| 26B (26B-A4B) | 混合专家 | 单张GPU |
| 31B | 稠密 | 单张GPU |
混合专家模型在处理每个请求时只调用部分专门化的子网络,而稠密模型每次都会用到全部参数。12B及以下的模型可以在普通开发者笔记本电脑上运行,2B模型则可以在配备专用AI硬件的手机上运行。更轻量的版本还能部署在Jetson Nano这类小型边缘计算板上。
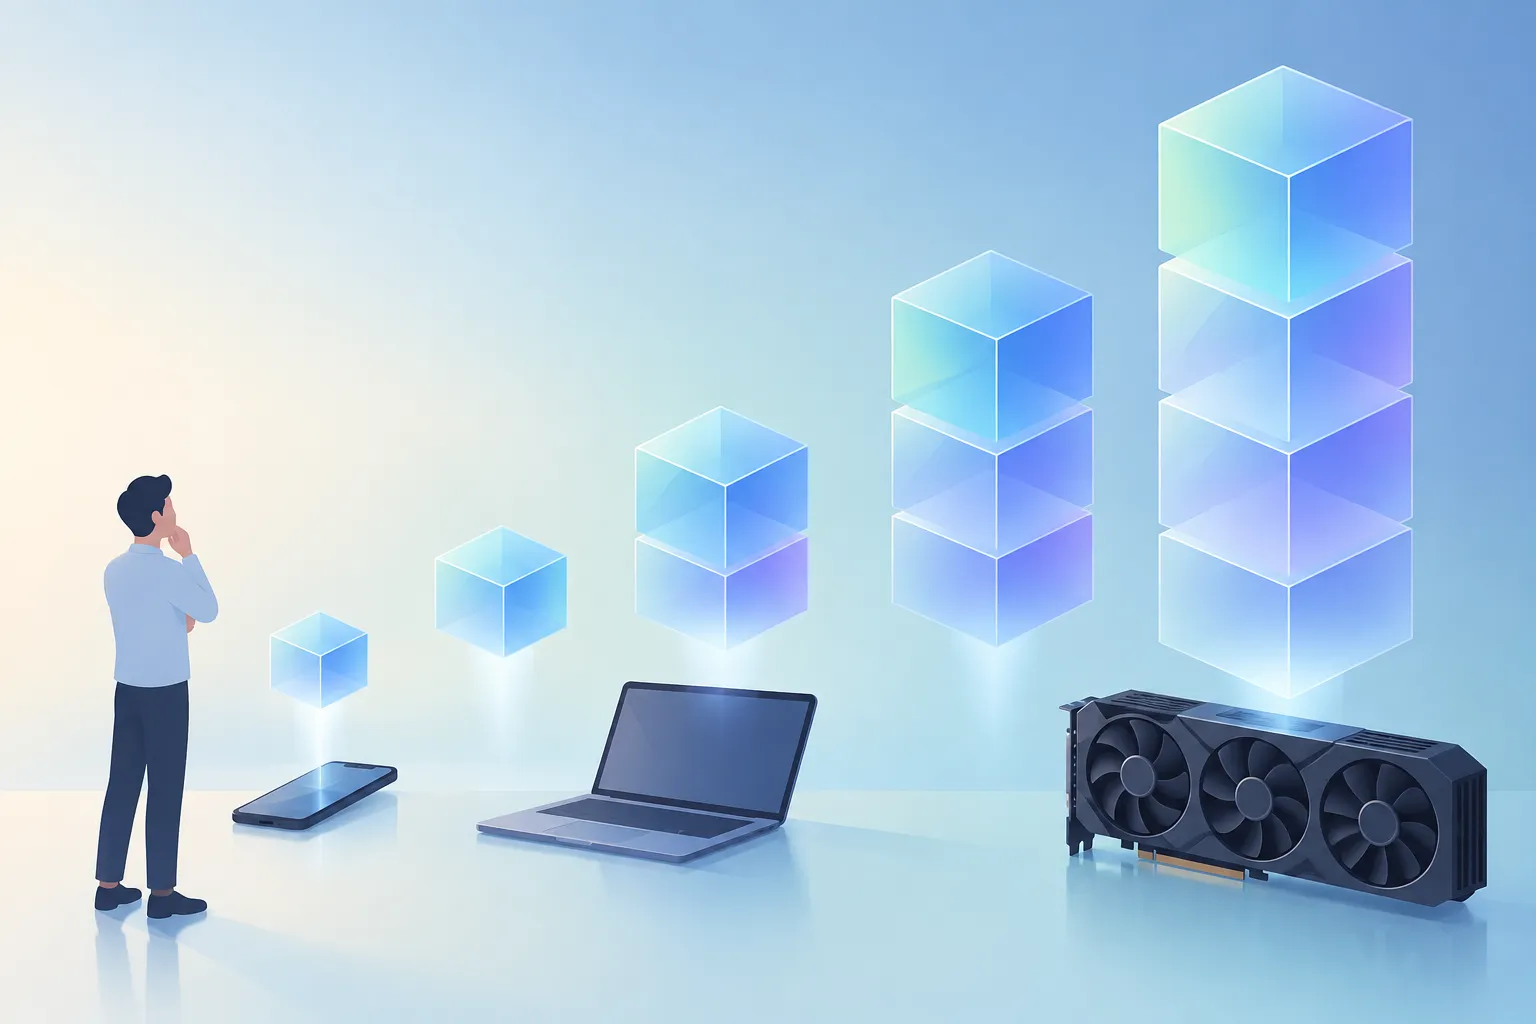
▲ Gemma 4规格与硬件的对应
不离开浏览器的推理
Gemma 4最小的模型可以完全在网页浏览器的客户端运行。这套方案结合了Transformers.js和WebAssembly(一种让浏览器运行高速编译代码的技术),在完全沙盒化的环境中执行。繁重的计算由借助Fable 5优化的定制GPU内核承担。不过,这些早期生成的内核在广泛分发之前,仍需经过调优和重写。
测试中,模型被要求制作一张带表情符号的表格,按幽默程度和刺激程度比较Harry Potter系列的每一本书,并给出阅读推荐。模型立即返回了一张结构清晰的Markdown表格,各列分别是每本书有多好笑、有多刺激、整体氛围以及推荐意见。排名未必人人认同,但关键在于,一个包含多项要求的请求在完全不接触服务器的情况下,变成了条理清晰的回答。
浏览器运行得到的测量结果如下:
token是模型读写文本时使用的小单位。预填充是模型读取提示词的阶段,解码是模型写出回答的阶段。由于这一切都在设备上完成,用户数据从不离开浏览器。对于处理个人信息或需要压低服务器成本的应用来说,这种方式似乎尤其有用。
Google AI Edge Gallery中的端侧AI
Google AI Edge Gallery是一款支持Android、iOS和macOS的应用,用户可以在离线状态下直接在设备上试用AI模型。其功能包括:
- Ask Image:描述图片内容并回答与图片相关的问题
- Audio Scribe:离线转写和翻译140多种语言的语音
- 端侧函数调用:让模型触发应用操作、提取结构化信息,并将日程直接添加到本地日历
- 小程序:Tiny Garden游戏、Haiku Card、天气查询工具和2048游戏等小型示例
在Google Pixel 10等配备神经网络处理器和GPU的手机上,Gemma模型可以流畅运行,而不会过度消耗CPU。缺少这些加速器的低端手机,一旦计算回落到CPU上,性能可能会变差。
▲ 离线端侧AI
小模型跑出大模型的分数
在一张将性能与参数量对照绘制的Elo图表上,Gemma 4的26B和31B思考模型得分约为1440到1460。这里的Elo是衡量模型之间相对表现的评分。这些分数超过了参数量约为其十倍的竞争模型。模型更小,也就无需在多台机器上进行分布式推理,从而降低基础设施成本。
量化感知训练(Quantization-Aware Training,简称QAT)可以进一步降低内存占用。量化是以较低精度存储模型数值的方法,而QAT在训练时就考虑到这种低精度,从而保留更多模型能力。Gemma 4在不同格式下的内存需求如下:
| 模型 | BF16,16位 | Q4_0,4位 | 移动端 | 移动端纯文本 |
|---|---|---|---|---|
| 2B | 11.4 GB | 2.9 GB | 1.1 GB | 0.84 GB |
| 4B | 17.9 GB | 4.5 GB | 2.5 GB | 2.2 GB |
| 12B | 26.7 GB | 6.7 GB | - | - |
| 26B | 57.7 GB | 14.4 GB | - | - |
| 31B | 69.9 GB | 17.5 GB | - | - |
2B模型在16位精度下需要11.4 GB,而在移动端纯文本格式下降至0.84 GB。这意味着语言模型可以在内存不到1 GB的手机上运行。
考虑本地推理时该做什么
借助Gemma 4,开发者可以把过去交给云端API的部分工作转移到浏览器和手机上。数据留在设备内,没有按次调用的费用和网络延迟,许可证也为商业产品留出了空间。比较务实的路径如下:
- 在开发定制应用之前,先在计划支持的设备上用Google AI Edge Gallery试用模型。
- 选择与设备内存相匹配的模型规格,内存紧张时使用QAT检查点。
- 如果是网页应用,用Transformers.js和WebAssembly搭建浏览器内推理原型。
- 如果模型需要适配自身业务领域,可在Apache 2.0许可证下进行微调。
由于在没有专用加速器的手机上性能可能下降,应先确认用户实际使用的硬件。为性能较弱的设备保留云端API作为备用,可能是更稳妥的配置。