构建一个AI智能体本身并不难。把语言模型放进一个循环,再给它几样工具,借助现有框架很快就能拼出一个可运行的演示。难的是演示之后的事:在云端全天候运行智能体,记录它做了什么,用可重复的测试给它打分,并逐一修复失败,直到它可以承担真正的工作。大部分工程投入花在这些生产化工作上,而不是智能体的核心逻辑上。
从人驱动的循环到智能体循环
先看看如今大多数人如何使用大语言模型。假设你想要一个React组件。你输入提示词,阅读回答,判断是否够好。如果缺了什么,就再问一次。你一直亲自驱动这个问答循环,直到满意为止。
AI智能体接管了这个循环。你只需给出起始目标,此后智能体在每一步自行决定是给出最终答案还是调用工具。当它调用工具或产生中间结果时,这些输出会直接回到循环中,作为下一次决策的上下文,中间无需人工介入。这个循环被称为智能体循环。它可能只运行一次,也可能运行多次,当智能体判断任务完成时就会停止。
| 传统大语言模型用法 | AI智能体 | |
|---|---|---|
| 谁驱动迭代 | 人 | 智能体 |
| 下一步 | 人输入下一条提示词 | 智能体选择回答或调用工具 |
| 中间输出 | 由人阅读并判断 | 自动回到循环中 |
| 何时结束 | 人满意时 | 智能体判断任务完成时 |
两个基本构件:循环与工具
把智能体拆解到最后,只剩两个核心概念。
智能体循环
循环是用普通的控制代码(例如while循环)包裹语言模型,让它持续运行,直到满足停止条件。当模型输出预先设定的停止信号(例如“done”)时,宿主程序中的确定性解析代码会检测到它并跳出循环。
工具
语言模型本身只能生成文本。结构化输出改变了这一点,即模型的回答遵循固定格式,外围代码可以解析。封装代码可以把模型的输出读作函数参数,并用它们调用真实的软件函数。智能体正是这样发送API请求、搜索网络、查询数据库或运行shell命令的。能够挑选并调用这些确定性函数,让一个文本预测器变成了能够改变现实世界的软件。
给智能体一份工作:AI员工
一旦能构建通用智能体,下一步就是为某个岗位打造的智能体,可以把它看作AI员工。它的不同之处在于,职责范围、可用工具和运行环境都是围绕特定工作设计的。
- 软件工程师:为它提供文件系统、代码编辑工具,以及用于推送和审查代码的GitHub访问权限,并让它在一个隔离环境中自行浏览代码仓库、修改文件、测试自己的工作。
- 销售代表:为它提供CRM即客户关系管理系统、Gmail之类的邮件工具和网络搜索,让它研究潜在客户并主动联系。
- 客户支持:同样的方法也适用,配备与岗位相匹配的工具和环境。
在实践中,设计AI员工就是研究组织的结构,为每个岗位规划出一个独立且装备齐全的智能体环境。
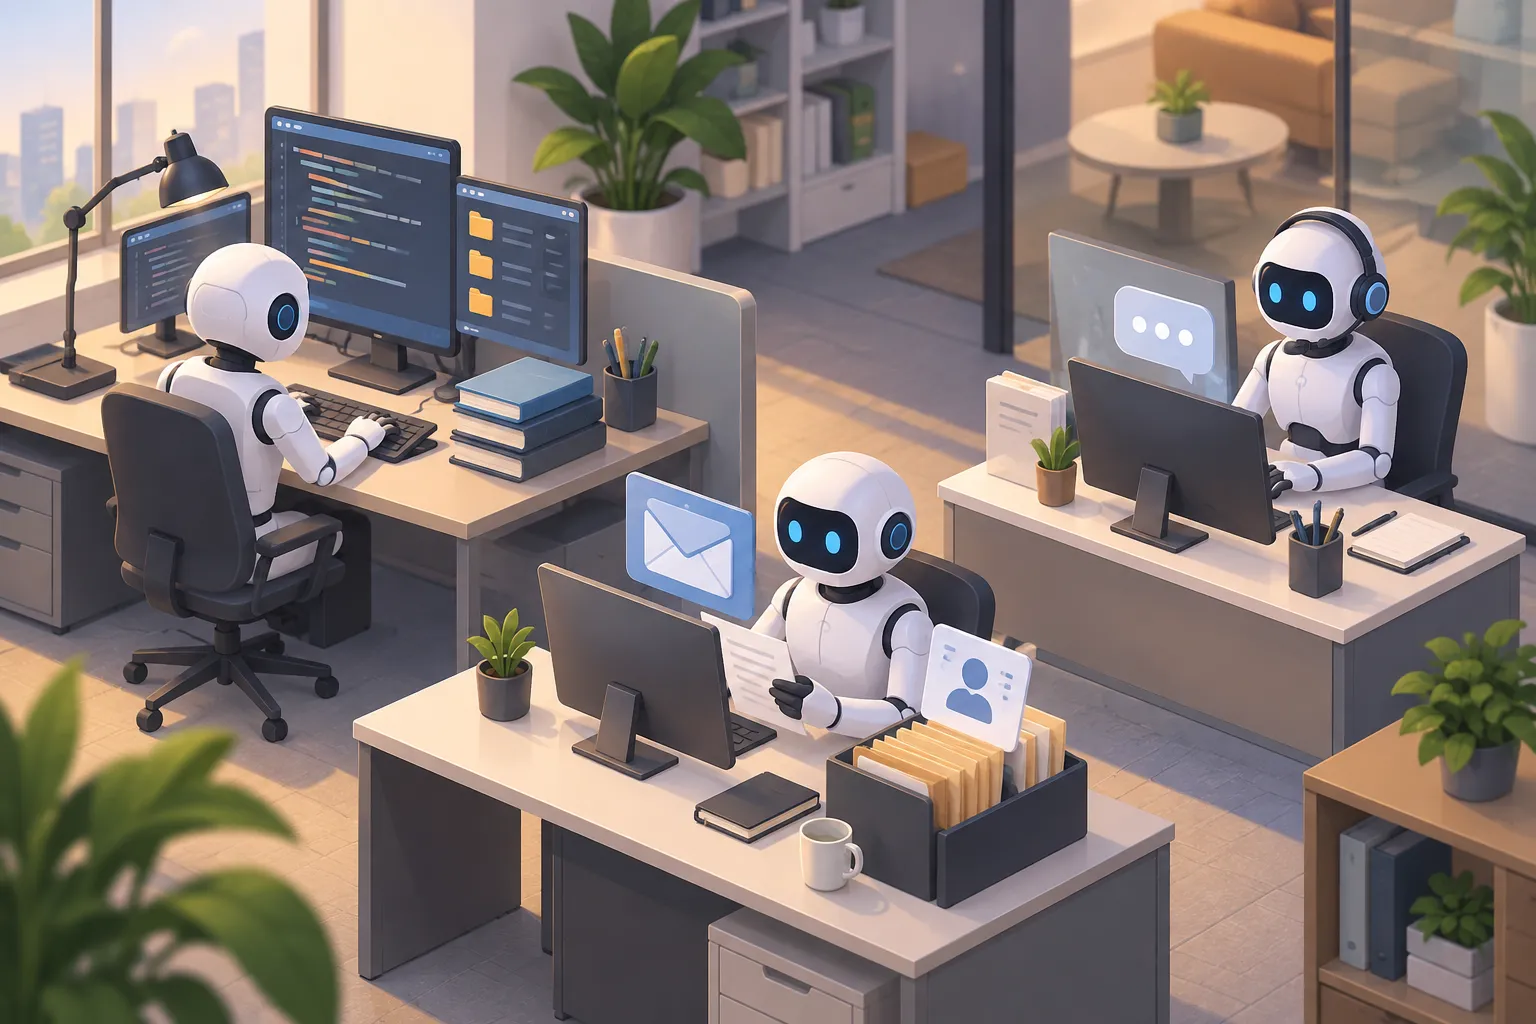
▲ 按岗位配备工具的AI员工
为什么第一个智能体会令人失望
为某项任务构建的第一个智能体,如果周围没有配套系统,几乎肯定表现不佳。要把一个表现得像能力欠佳员工的智能体,提升为能达到高级工程师水平的智能体,需要严格的工程纪律。无论智能体是写代码、做销售还是处理支持工单,都是如此。配套工作分为七个方面。
| 方面 | 需要解决的问题 |
|---|---|
| 部署 | 长时间运行的智能体比短时任务的智能体更难在云端保持稳定 |
| 可观测性 | 需要看清智能体是在完成分配的任务,还是在编造内容、偏离轨道 |
| 遥测 | 全天候运行的智能体会产生海量执行数据,必须把有用信号从噪声中分离出来 |
| 评估 | 定量评估与人工监督相结合,显示智能体目前实际能做什么 |
| 人工监督 | 人在自动评分之外审查智能体的工作 |
| 版本管理 | 在生产环境中做A/B测试,让两个版本并行运行,确认改进后再全面推出 |
| 改进循环 | 智能体输出trace和span,即每次运行及其中每一步的记录,评估套件为其打分,工程师逐一修复失败模式 |
有两点值得注意。第一,遥测即运行中的系统关于自身上报的执行数据,单靠收集并没有用。没有智能过滤,数据量会淹没改进智能体所需的信号。第二,改进循环永远不会真正结束。生产环境中的智能体只要还在运行,就需要持续的评估、追踪和完善。
从笔记本电脑到可靠智能体的六个步骤
掌握这些最可靠的方法是动手构建。整个路径分为六个阶段。
- 在本地构建一个。 在自己的电脑上编写一个能调用外部工具的智能体循环,并给它一些简单任务。
- 部署它。 把它迁移到云端,让它全天候运行,关上笔记本电脑也不会停止。团队成员和其他获得授权的人随时都能访问和监控它。
- 观察它。 建立可观测性,回答基本问题:智能体做了什么、走了什么路径、是否忠实完成了任务。
- 评估它。 运行一组固定场景,例如100项测试,得到一个数值化的可靠性分数。如果智能体通过了100项中的90项,那么失败的10项就是需要研究的案例。
- 改进它。 逐一修复发现的失败模式。
- 让它变得可靠。 不断重复观察、评估、改进的循环,直到智能体达到可依赖的生产质量。
走完这条路径的智能体,会让你掌握构建第一个合格AI员工所需的核心技能。
从AI员工到AI公司
有了一个可靠的AI员工,下一步就是让众多智能体作为一家AI公司协同工作。此时主要瓶颈从单个智能体的逻辑,转向智能体之间的协调以及整体设计的可扩展性。
这里的关键建议是,不要孤立地构建每个AI员工。当所有智能体共享一个通用底座和统一的基础设施层时,就能避免重复劳动,并以一致的方式创建、配置和运行大量智能体。许多科技企业大举投资专门的AI智能体平台,似乎正是这种协调需求的体现。
由此形成的组织很可能是混合型的,按照比较优势分工。AI员工擅长大批量的后台事务,例如解析、汇总和综合大量数据。人则专注于创造性、战略性以及只有人才能完成的工作,并监督智能体如何围绕公司目标协作。
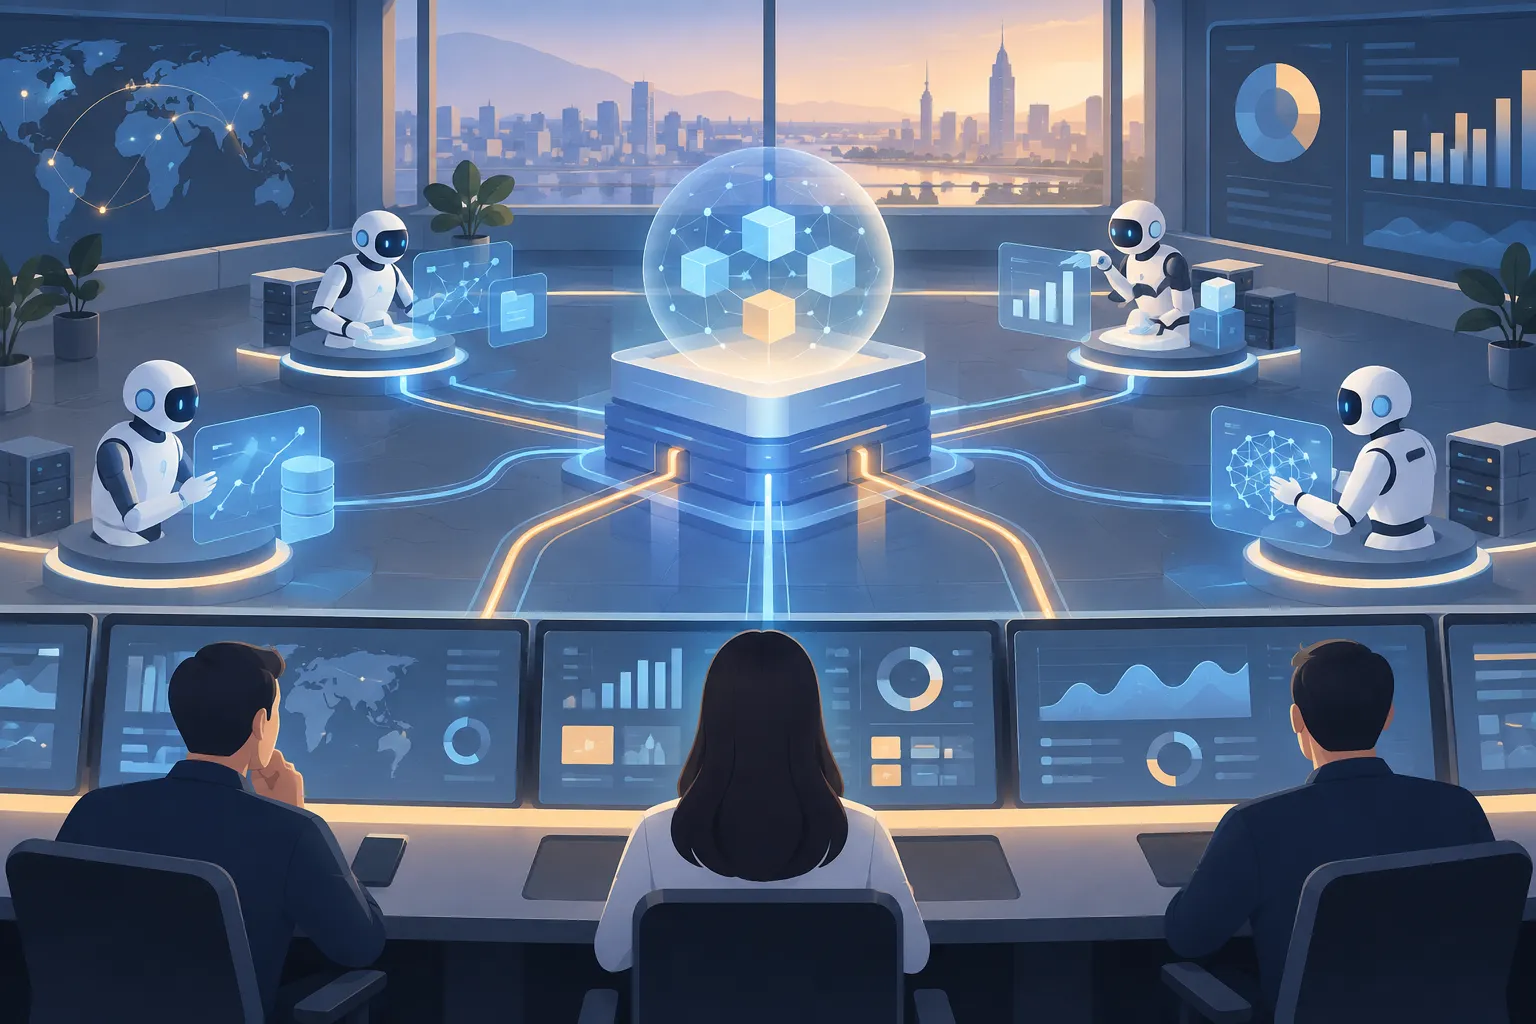
▲ 建立在共享平台上的AI公司
一个求职平台展示了这种协调的样子。简历辅导智能体会审阅上传的简历,指出缺失的细节,例如毕业时间或学校信息,并改写相关部分。不同的面试智能体分别负责编程、系统设计和行为面试,编程测试包含2道题、60分钟时限,支持3种编程语言。另一个智能体则颠倒了通常的角色:它扮演新手学生,用户必须教它二分查找之类的概念,它再为用户的代码熟练度、表达能力和准确性打分。平台的目标是把这些智能体连成一条端到端的流程,引导求职者从投递简历一路走到拿到录用通知。
下一步该做什么
AI智能体就是一个处于循环之中、能够使用工具的语言模型,结构很简单。演示与可靠系统之间真正的差别,在于它周围的一切。如果你正在构建智能体,可以按以下顺序推进:
- 先在自己的电脑上编写一个能调用工具的小型智能体循环。
- 尽早迁移到云端,让它全天候运行,并为每次运行记录trace和span。
- 建立可重复使用的评估套件,跟踪满分100的分数,修复它暴露出的失败。
- 每个新版本在切换前,先用A/B测试与上一个版本比较。
- 如果计划运行多个智能体,从一开始就为它们设计共享的基础。
能运行的演示只是起点,而不是终点。尽早建立观察、评估和改进的体系,看来是通往真正可靠智能体的更快路径。