性能强大的模型只是企业AI智能体的一部分。智能体(执行任务的AI系统)还需要理解企业的决策,在受限的权限范围内工作,并证明自己能够完成所分配的任务。Salesforce总裁兼首席平台与工程官罗汉·库马尔认为,业务上下文是其中最难的一环:企业可能存储了海量数据,却没有记录让这些数据真正发挥作用的决策理由。
决策记录并不等于决策本身
设想一名员工请经理批准一项政策例外。业务系统也许会保存批准结果,却不会记录背后的具体情况和判断。日后智能体遇到类似案例时,仅凭记录下来的结果,可能无法判断该如何处理。
当决策发生在电话、聊天或会议中时,同样的缺口也会出现。即便留有文字记录,相关的决策依据仍可能难以提取和利用。要把这类隐性知识转化为智能体可用的信息,远不止让它多访问一个数据库那么简单。
▲ 决策记录中缺失的理由
库马尔把企业智能体的能力分为三部分:智能体代码、底层模型的通用智能,以及对特定企业的了解。第三部分无法仅靠通用推理能力获得。Salesforce已发布CRM推理模型Cora,该模型汇集了28年的CRM经验和约十年的数据与AI研究积累。即便是为这一领域打造的模型,仍然需要具体企业的业务运作情况和决策历史。
在工作发生的地方捕捉判断
软件工程师会留下源代码,其中记录了他们的许多设计选择。业务团队则往往缺少结构化的证据,来说明为何选择某种例外处理或应对方式而非另一种。这种差异在一定程度上解释了,为什么模型编程能力的提升并不会自动带来可靠的业务判断力。
库马尔主张,工程师应直接与一线业务人员共事:在决策发生时进行观察,弄清哪些细节真正重要,再把这些知识用软件表达出来。其中可以包括API,即智能体调用业务信息或功能时所使用的明确接口。这样做的目的并不是假装每一项判断都遵循僵硬的规则,而是让相关上下文和决策逻辑可供测试和使用,而不是只依赖最终操作的记录。
给智能体一套运行框架,而不是不受限的访问权限
智能体运行框架(agent harness)是指用于构建、运行、测试和治理智能体的外围系统。在企业中,它的作用不能止于执行代码或连接API。库马尔提出的管控措施包括:
- 评估: 用黄金测试集测试智能体,以检查其行为。黄金测试集是一组精心挑选、可信的问题及其预期答案。
- 中央注册表: 在整个组织范围内掌握智能体情况,包括哪些正在运行、哪些应当停用。
- 智能体专属身份: 为智能体授予仅限于其任务的权限,而不是自动沿用调用它的员工所拥有的全部权限。
- 数据策略: 对信息进行分类,使智能体能够区分机密资料与公开或限制较少的数据。
之所以要区分权限,是因为智能体若以个人的宽泛凭据运行,一旦行为异常,就可能泄露与其既定任务无关的信息。限定访问范围约束的是智能体能触及什么,评估检查的是它如何使用已有的访问权限。两者无法相互替代。
在智能体提出请求之前准备好上下文
把智能体连接到所有数据湖、数据仓库和软件服务,再把原始资料直接塞进提示词,并不等于提供了有用的上下文。词元(token)是模型处理文本的单位。这种有时被称为“token maxing”的蛮力做法,可能消耗大量词元,却无法带来可靠的答案。
库马尔提议预先构建一个可信的上下文层。与其在智能体收到请求时才完成所有工作,不如让后台流程在使用率较低的时段(例如晚上11点至凌晨5点)整理数据。这些流程可以构建语义模型和本体:前者为业务数据赋予一致的含义,后者梳理业务概念及其相互关系。智能体可以使用哪些数据,仍由数据分类来决定。
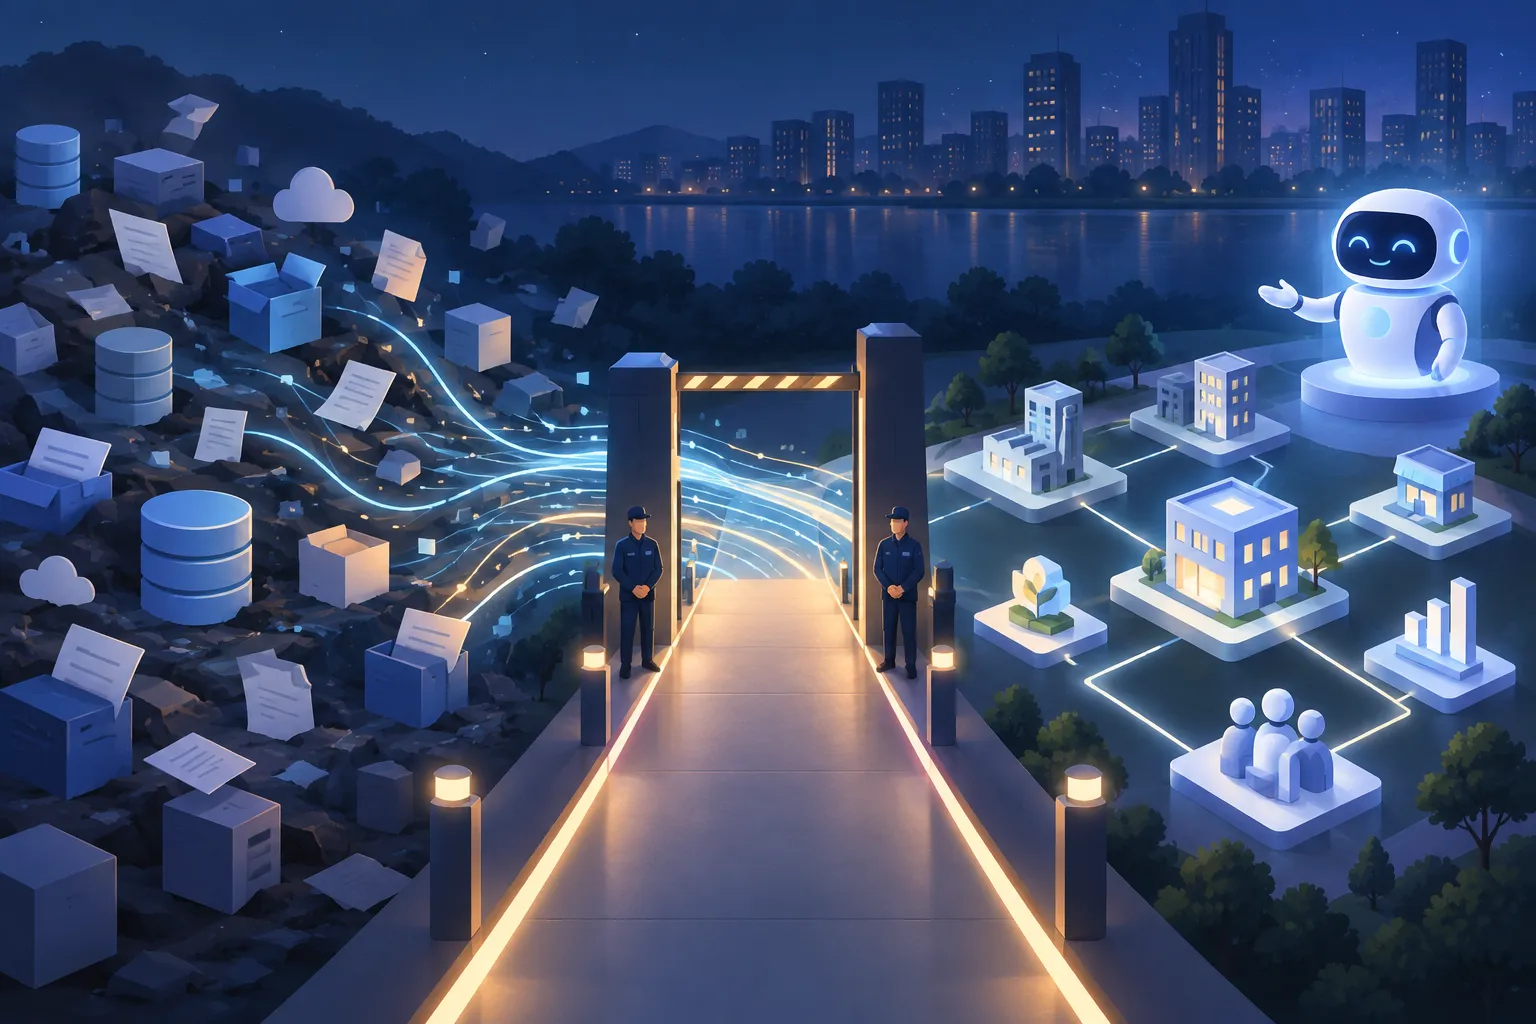
▲ 为智能体整理的业务上下文
这项准备工作之所以困难,是因为企业信息分散在不同的存储系统和格式中。知识图谱提供了一种将其连接起来的方式:实体成为节点,实体之间的关系成为可查询的连接。例如,“客户”拥有一个“案例”,而该案例遵循某项“政策”。梳理好这些关联,或许能帮助智能体找到所需的业务关系,而无需接收所有来源的原始数据。
让模型成本与任务相匹配
运行框架还需要模型路由:根据任务所需的性能和使用价格为其选择AI模型。对某些工作而言,能力更强的模型或许物有所值,但库马尔认为,把这类模型用于每一个日常请求,会让企业部署的成本过高。
实际问题在于,结果的提升是否重要到足以抵消增加的成本。如果额外的能力不能带来实际的业务收益,运行框架就应把任务交给更轻量、更便宜的模型。按照这一思路,模型选择与上下文准备、访问控制同属一套运行框架,而不是日后另行做出的决定。
扩大智能体应用之前应做的事
组织从未记录下来的决策理由,再强大的模型也无法找回;数据层整理得再好,也无法让过度的权限变得安全。要做的是同步推进这几方面的工作:
- 检查一个记录审批或例外情况的工作流程,看它是否也记录了这些决定的原因。
- 让工程师观察做出这些决策的人员,并把相关上下文转化为智能体可读取的软件。
- 用黄金测试集测试智能体,进行集中注册,并将其凭据限定在所分配的任务范围内。
- 在查询到来之前整理获准使用的数据,再针对智能体实际承担的工作比较模型的性能与成本。
这些步骤能让智能体的业务知识、行为、访问权限和开销变得可见,也能为判断哪些任务已适合交给智能体提供更清晰的依据。