在一组交互式3D生成测试中,GPT-6 Sol相较GPT-5.6 Sol最稳定的优势是速度。在相同提示词和最高推理强度下,新模型在每项对比中都更快完成场景,视觉效果通常也更好。不过,它并非总是消耗更少的token,这些测试也无法确定其每项任务的成本。对于考虑切换模型的人来说,耗时和实际支出值得与输出质量一同考量。
这些对比衡量了什么
OpenAI将GPT-6 Sol定位在旗舰GPT-6 Astra档位之下。为比较它与GPT-5.6 Sol的表现,两个模型接收了完全相同的提示词,任务是通过代码生成3D场景,要求包括相机视角、运动物体和可调节控件。两者都采用最高推理强度,这一设置允许模型为生成回答投入更多工作。所列token总量统计了已处理文本的单位数,包括缓存token;实际耗时则是每次运行从开始到结束所花的时间。
这些都是要求较高的编程任务,不能全面衡量软件开发能力。场景看起来可能像模像样,页面上的滑块却未必能改变实时WebGL渲染结果,也就是浏览器中的3D图形。因此,对比也考察交互元素是否正常工作。
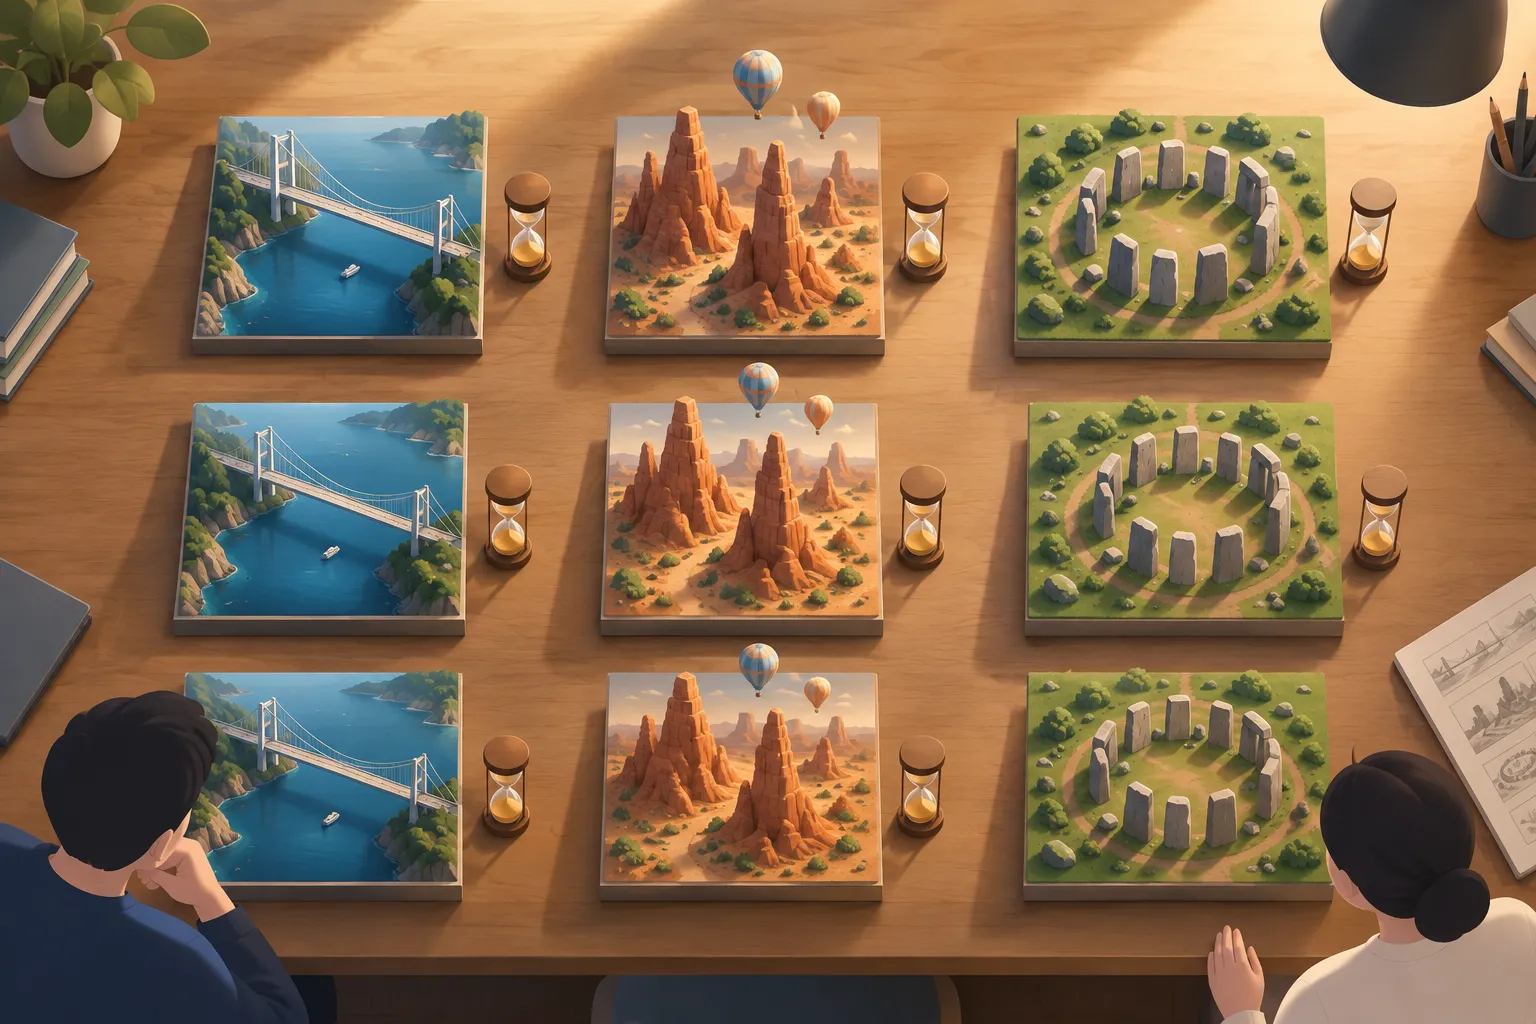
▲ 3D场景耗时对比
耗时和token数据说明,速度与token用量为何应分别追踪。下表中的M表示百万token。
| 场景 | GPT-5.6 Sol:token数;用时 | GPT-6 Sol:token数;用时 |
|---|---|---|
| 金门大桥 | 9.4M;1小时04分钟 | 4.7M;11分35秒 |
| 卡帕多奇亚热气球 | 13.1M;53分52秒 | 4.0M;9分58秒 |
| 巨石阵 | 9.5M;53分49秒 | 3.5M;11分42秒 |
| 北太平洋巨型章鱼 | 7.8M;48分39秒 | 6.6M;9分51秒 |
| 莫奈《睡莲》 | 9.4M;47分15秒 | 17.1M;25分26秒 |
| 巴别塔 | 9.3M;50分10秒 | 20.3M;24分28秒 |
| 雨中花园 | 4.6M;48分46秒 | 6.9M;14分16秒 |
| 曼哈顿航拍场景 | 7.0M;1小时41分钟 | 24.2M;44分24秒 |
金门大桥任务的提示词要求加入大气效果控件和可调节的车流。GPT-6 Sol耗时不到GPT-5.6 Sol的五分之一,token用量也只有一半。它生成的桥梁结构更清晰,水面倒影更出色,控件响应也更灵敏;GPT-5.6 Sol的场景尚可接受,但显得更平淡。卡帕多奇亚和巨石阵的测试同样在减少token用量、大幅缩短等待时间的同时,呈现出更可信的地形或石阵布局。
更快不一定意味着token更少
章鱼任务尤其清楚地表明,不能用token总量推断等待时间。GPT-5.6 Sol消耗780万token,用时48分39秒;GPT-6 Sol消耗660万token,与前者相差不大,却只用9分51秒就完成了。新模型生成的腕足弯曲更自然,外套膜运动更有动感,而旧模型生成的腕足较为僵硬。
造成耗时差距的一种可能解释是,GPT-5.6 Sol反复测试、检查部分代码,却没有在最终场景上取得相应进展。这是对运行过程的解读,并非能把每一分钟归因于具体活动的耗时明细。但它确实说明,即使token总量没有同比例增加,追踪实际耗时仍然重要。
另外几项任务完全颠倒了节省token的趋势。在《睡莲》场景中,GPT-6 Sol消耗1710万token,GPT-5.6 Sol则消耗940万;但前者仅用25分26秒便完成,后者则用了47分15秒。新模型生成了可供探索、具有绘画风格的池塘,其中有睡莲叶和桥梁倒影;旧模型的输出则是平面化、缺乏整体感的图块。巴别塔和曼哈顿任务中,GPT-6 Sol也消耗了更多token,却更早完成。在这些情况下,更多token伴随着更精细的场景,并不能证明token消耗更低。
时间优势的幅度并不一致。有些测试将等待时间缩短了约五分之四,而《睡莲》和巴别塔任务的完成时间约为此前的一半。这种差异说明,测试任务的类型很重要:单一的百分比无法概括所有提示词的结果。
成本仍是另一回事
另有一项智能体任务对比,考察了执行多步骤工作的AI系统,报告了以下每项任务成本中位数和净任务改进得分。它涵盖的是不同任务,并混用了Max和High推理设置,因此这些数字只能作为选择模型时的参考,并非上述场景的实测价格。
| 模型与设置 | 每项任务成本中位数 | 净任务改进 |
|---|---|---|
| Claude Fable 5.1(Max) | $4.40 | +13.7% |
| GPT-6 Astra(Max) | $3.94 | +12.7% |
| Claude Opus 5(High) | $2.07 | +10.3% |
| GPT-5.6 Sol(High) | $1.03 | +8.0% |
▲ 智能体任务成本与性能
一种可能的估算是,如果GPT-6 Sol能以更低价格达到接近Claude Opus 5的性能,其每项任务成本可能约为$0.40。这只是估算,而非这项对比中的实测数据。同样,场景测试的token总量和完成时间也无法确定其他用户为不同任务需要支付多少费用。实际要问的是:在当前工作的时间和成本限制内,模型能否产出可接受的结果。
如何决定是否切换
对于这些复杂的3D编程提示词,GPT-6 Sol似乎能大幅缩短等待时间,对比结果也显示出明显的质量提升。但它节省token的表现并不稳定,预计的成本优势仍需测量。不要默认使用最高推理强度;应选取一项有代表性的任务,在Low或Medium推理强度下测试,并与目前使用的设置比较。记录token总量、实际耗时、任务的实际成本,以及交互控件是否正常工作。最终保留能够满足质量要求、又不会徒增等待时间或费用的模型和设置。